<?xml version="1.0" encoding="utf-8"?>
<!DOCTYPE html>
<html xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://www.w3.org/1999/xhtml https://raw.githubusercontent.com/oreillymedia/HTMLBook/master/schema/htmlbook.xsd"
xmlns="http://www.w3.org/1999/xhtml"
lang="zh">
<head>
<title>面向教师的人工智能教程： 一本开放式教科书</title>
</head>
<body data-type="book">
<section data-type="halftitlepage">
    <h1 class="title">面向教师的人工智能教程： 一本开放式教科书</h1>
</section>
<section data-type="titlepage">
    <h1 class="title">面向教师的人工智能教程： 一本开放式教科书</h1>
    <p class="subtitle"></p>
    <p class="author">Colin de la Higuera</p>
    <p class="author">Jotsna Iyer</p>
    <p class="publisher"></p>
    <p class="publisher-city"></p>
</section>
<section data-type="copyright-page">
    <h1>面向教师的人工智能教程： 一本开放式教科书</h1>
    <div class="license-attribution">
         <p><img src="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/themes/pressbooks-book/packages/buckram/assets/images/cc-by.svg" alt="知识共享署名 4.0 国际许可的图标" /></p>
         <p>面向教师的人工智能教程： 一本开放式教科书 Copyright © 2024 by <span>Colin de la Higuera 和 Jotsna Iyer</span> is licensed under a <a rel="license" href="https://creativecommons.org/licenses/by/4.0/">知识共享署名 4.0 国际许可</a>, except where otherwise noted.</p>
    </div>
</section>
<nav data-type="toc">
    <h1>内容</h1>
    <ol>
         <li class="front-matter miscellaneous"><a href="#front-matter-note-for-partners-who-are-reviewing-edition-2-content"><span class="toc-chapter-title">给正在审阅第二版内容的合作伙伴的注意事项</span></a></li>
         <li class="front-matter introduction"><a href="#front-matter-slug-33"><span class="toc-chapter-title">本书介绍</span></a></li>
         <li class="front-matter miscellaneous post-introduction"><a href="#front-matter-acknowledgements"><span class="toc-chapter-title">致谢</span></a></li>
         <li class="front-matter miscellaneous post-introduction"><a href="#front-matter-about-the-project"><span class="toc-chapter-title">关于项目</span></a></li>
         <li class="front-matter miscellaneous post-introduction"><a href="#front-matter-introduction-2"><span class="toc-chapter-title">前言</span></a></li>
         <li class="front-matter miscellaneous post-introduction"><a href="#front-matter-e4b8ade69687e78988e5ba8f"><span class="toc-chapter-title">中文版序</span></a></li>
         <li class="part"><a href="#part-why-learn-about-ai">我们为什么要学习人工智能（AI）</a></li>
         <li class="chapter standard"><a href="#chapter-technology-change-and-you"><span class="toc-chapter-title">技术、变革与你我</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-is-everywhere"><span class="toc-chapter-title">AI 无处不在</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-already-in-education"><span class="toc-chapter-title">AI 已进入教育领域</span></a></li>
         <li class="chapter standard"><a href="#chapter-how-ai-can-help-you"><span class="toc-chapter-title">AI如何帮助您</span></a></li>
         <li class="chapter standard"><a href="#chapter-why-not-just-do-ai-part-1"><span class="toc-chapter-title">为什么不直接使用AI，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-why-not-just-do-ai-part-2"><span class="toc-chapter-title">为什么不直接使用AI，第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-chapter-1"><span class="toc-chapter-title">第一章</span></a></li>
         <li class="part"><a href="#part-finding-information">寻找信息</a></li>
         <li class="chapter standard"><a href="#chapter-search-engines-part-1"><span class="toc-chapter-title">搜索引擎 第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-search-engines-part-2"><span class="toc-chapter-title">搜索引擎 第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-machine-learning"><span class="toc-chapter-title">AI 说(AI Speak)：机器学习</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-search-engine-indexing"><span class="toc-chapter-title">AI说(AI Speak)：搜索引擎检索</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-search-engine-ranking"><span class="toc-chapter-title">AI说(AI Speak)：搜索引擎排序</span></a></li>
         <li class="chapter standard"><a href="#chapter-behind-the-search-lens-effects-of-search-on-the-individual"><span class="toc-chapter-title">搜索视角的背后：搜索对个人的影响</span></a></li>
         <li class="chapter standard"><a href="#chapter-behind-the-search-lens-effects-of-search-on-the-individual-on-the-society"><span class="toc-chapter-title">搜索视角的背后：搜索对社会的影响</span></a></li>
         <li class="part"><a href="#part-managing-learning">管理学习</a></li>
         <li class="chapter standard"><a href="#chapter-smart-lms"><span class="toc-chapter-title">智慧学习管理系统</span> <span class="chapter-author">Giuseppe Città 和 Manuel Gentile</span></a></li>
         <li class="chapter standard"><a href="#chapter-slug-235"><span class="toc-chapter-title">学习分析与教育数据挖掘</span> <span class="chapter-author">Anne Boyer; Azim Roussanaly; 和 Jiajun Pan</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-data-based-systems-part-1"><span class="toc-chapter-title">AI说（AI-Speak）：基于数据的系统，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-data-based-systems-part-2"><span class="toc-chapter-title">AI说（AI-Speak）：基于数据的系统，第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-what-not-to-do-with-data-issues-of-personal-identity-bias-and-fairness"><span class="toc-chapter-title">数据相关的问题：个人身份</span></a></li>
         <li class="chapter standard"><a href="#chapter-issues-with-data-bias-and-fairness"><span class="toc-chapter-title">数据相关问题：偏见与公平</span></a></li>
         <li class="part"><a href="#part-listening-speaking-and-writing">听、说与写</a></li>
         <li class="chapter standard"><a href="#chapter-translators"><span class="toc-chapter-title">翻译</span></a></li>
         <li class="chapter standard"><a href="#chapter-writing-with-ai"><span class="toc-chapter-title">使用AI写作</span> <span class="chapter-author">Giuseppe Città 和 Manuel Gentile</span></a></li>
         <li class="chapter standard"><a href="#chapter-deep-neural-networks"><span class="toc-chapter-title">AI说（AI-Speak）：深度神经网络</span></a></li>
         <li class="chapter standard"><a href="#chapter-slug-415"><span class="toc-chapter-title">AI说（AI-Speak）：自然语言处理</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-aied-and-human-agency"><span class="toc-chapter-title">AI、AIED与人类能动性</span> <span class="chapter-author">Wayne Holmes</span></a></li>
         <li class="chapter standard"><a href="#chapter-homogenisation-invisibility-and-beyond-towards-an-ethical-ai"><span class="toc-chapter-title">同质化、隐形化及其超越：走向符合伦理的AI</span></a></li>
         <li class="part"><a href="#part-personalising-learning">个性化学习</a></li>
         <li class="chapter standard"><a href="#chapter-a-note-on-personalisation"><span class="toc-chapter-title">关于个性化的说明</span></a></li>
         <li class="chapter standard"><a href="#chapter-adaptive-learning-systems"><span class="toc-chapter-title">自适应学习系统</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-how-youtube-learns-you-part-1"><span class="toc-chapter-title">AI说（AI Speak）：Youtube是如何了解你的，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-how-youtube-learns-you-part-2"><span class="toc-chapter-title">AI说（AI Speak）：Youtube是如何了解你的，第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-how-adaptive-systems-learn-the-learner-part-1"><span class="toc-chapter-title">AI说（AI-Speak）：自适应系统如何了解学习者，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-ai-speak-how-adaptive-systems-learn-the-learner-part-2"><span class="toc-chapter-title">AI说（AI-Speak）：自适应系统如何学习学习者，第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-the-flip-side-of-als-some-paradigms-to-take-note-of"><span class="toc-chapter-title">自适应学习系统的另一面：一些值得关注的范式</span></a></li>
         <li class="part"><a href="#part-on-generative-ai">关于生成式人工智能</a></li>
         <li class="chapter standard"><a href="#chapter-an-introduction-to-generative-ai"><span class="toc-chapter-title">生成式和对话式人工智能的介绍</span> <span class="chapter-author">John Hurley 和 Michael Hallissy</span></a></li>
         <li class="chapter standard"><a href="#chapter-generative-for-the-classroom"><span class="toc-chapter-title">面向课堂的生成式AI，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-generative-ai-for-the-classroom-part-ii"><span class="toc-chapter-title">面向课堂的生成式AI，第2部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-of-assignments-and-assessments-2"><span class="toc-chapter-title">ChatGPT及其对学校作业的潜在影响</span> <span class="chapter-author">John Hurley 和 Michael Hallissy</span></a></li>
         <li class="chapter standard"><a href="#chapter-the-gears-of-generative"><span class="toc-chapter-title">生成式AI的要素</span> <span class="chapter-author">Fabrizio Falchi 和 Manuel Gentile</span></a></li>
         <li class="chapter standard"><a href="#chapter-of-assignments-and-assessments"><span class="toc-chapter-title">提示的艺术、技巧或科学</span> <span class="chapter-author">Bastien Masse</span></a></li>
         <li class="chapter standard"><a href="#chapter-the-degenerative"><span class="toc-chapter-title">局限性，第1部分</span></a></li>
         <li class="chapter standard"><a href="#chapter-the-degenerative-part-2"><span class="toc-chapter-title">局限性，第2部分</span></a></li>
         <li class="part"><a href="#part-the-next-steps">下一步</a></li>
         <li class="chapter standard"><a href="#chapter-open-or-closed"><span class="toc-chapter-title">开放还是封闭？</span></a></li>
         <li class="chapter standard"><a href="#chapter-artificial-intelligence-homework-exams-and-so-forth"><span class="toc-chapter-title">人工智能、作业与考试等</span></a></li>
         <li class="chapter standard"><a href="#chapter-obsolescence"><span class="toc-chapter-title">过时了吗？</span></a></li>
         <li class="chapter standard"><a href="#chapter-individual-or-collective-ai"><span class="toc-chapter-title">面向个体或群体的AI</span></a></li>
         <li class="chapter standard"><a href="#chapter-teaching-ai"><span class="toc-chapter-title">教授人工智能</span></a></li>
         <li class="part"><a href="#part-additional-content">附加内容</a></li>
         <li class="chapter numberless"><a href="#chapter-optical-character-recognition"><span class="toc-chapter-title">光学字符识别（OCR）</span></a></li>
         <li class="chapter numberless"><a href="#chapter-slug-42"><span class="toc-chapter-title">42</span></a></li>
         <li class="chapter numberless"><a href="#chapter-a-brief-description-of-some-search-engines"><span class="toc-chapter-title">一些搜索引擎的简要描述</span></a></li>
         <li class="chapter numberless"><a href="#chapter-optimising-search"><span class="toc-chapter-title">优化搜索</span></a></li>
         <li class="chapter numberless"><a href="#chapter-x5gon"><span class="toc-chapter-title">X5GON项目</span></a></li>
         <li class="chapter numberless"><a href="#chapter-does-data-always-have-to-be-labeled"><span class="toc-chapter-title">数据是否总需要标注？</span></a></li>
         <li class="chapter numberless"><a href="#chapter-how-many-features-are-too-many"><span class="toc-chapter-title">多少特征才算太多？</span></a></li>
         <li class="chapter numberless"><a href="#chapter-hands-on-machine-learning"><span class="toc-chapter-title">动手实践机器学习</span></a></li>
         <li class="chapter numberless"><a href="#chapter-cookies-and-fingerprinting"><span class="toc-chapter-title">Cookie 和指纹识别</span></a></li>
         <li class="chapter numberless"><a href="#chapter-more-on-big-data"><span class="toc-chapter-title">关于大数据的更多信息</span></a></li>
         <li class="chapter numberless"><a href="#chapter-other-terms-related-to-personalised-learning"><span class="toc-chapter-title">与个性化学习相关的其他术语</span></a></li>
         <li class="chapter numberless"><a href="#chapter-ai-technology-is-moving-fast"><span class="toc-chapter-title">AI技术发展迅速</span></a></li>
         <li class="chapter numberless"><a href="#chapter-some-automatic-translation-vocabulary"><span class="toc-chapter-title">一些自动翻译相关的词汇</span></a></li>
         <li class="chapter numberless"><a href="#chapter-understanding-the-debates-about-the-possible-dangers-of-ai"><span class="toc-chapter-title">理解关于人工智能潜在危险的争论</span></a></li>
         <li class="chapter numberless"><a href="#chapter-generative-ais-where-should-a-teacher-use-them"><span class="toc-chapter-title">生成式AI - 教师应该在哪里使用它们？</span></a></li>
         <li class="chapter numberless"><a href="#chapter-transformers"><span class="toc-chapter-title">变换器网络（Transformer）</span> <span class="chapter-author">Fabrizio Falchi 和 Manuel Gentile</span></a></li>
         <li class="chapter numberless"><a href="#chapter-gdpr-in-a-nutshell"><span class="toc-chapter-title">《通用数据保护条例》（GDPR）简述</span></a></li>
         <li class="chapter numberless"><a href="#chapter-ai-and-coding"><span class="toc-chapter-title">人工智能与编程</span></a></li>
         <li class="chapter numberless"><a href="#chapter-machine-learning-ai-through-data-experiments-in-orange"><span class="toc-chapter-title">通过Orange项目中的数据实验学习机器学习与人工智能</span> <span class="chapter-author">Blaž Zupan</span></a></li>
         <li class="back-matter appendix"><a href="#back-matter-appendix"><span class="toc-chapter-title">Appendix</span></a></li>
         <li class="back-matter afterword"><a href="#back-matter-as-a-very-provisional-conclusion"><span class="toc-chapter-title">初步结论</span></a></li>
    </ol>
</nav>
<section data-type="halftitlepage" class="front-matter miscellaneous" id="front-matter-note-for-partners-who-are-reviewing-edition-2-content" title="给正在审阅第二版内容的合作伙伴的注意事项">
    <header>
         <h1 class="front-matter-title">给正在审阅第二版内容的合作伙伴的注意事项</h1>
         <p data-type="subtitle" class="front-matter-number">1</p>
    </header>
    <p>亲爱的合作伙伴们，</p>
    <p>&nbsp;</p>
    <p>感谢您抽出时间审阅这项工作。在此列出第二版的变化，以供您快速参考：</p>
    <h3 style="text-align: left">第二版的主要变动：</h3>
    <ol>
         <li>在第二章的<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-machine-learning/" target="_blank" rel="noopener">AI 语言：机器学习</a>中，新增了一个关于<a href="https://pressbooks.pub/aiforteachers/chapter/does-data-always-have-to-be-labeled/" target="_blank" rel="noopener">监督学习和无监督学习</a>的延伸阅读模块。</li>
         <li>在第二章的<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual/" target="_blank" rel="noopener">搜索对个人的影响</a>中，新增了一个<a href="https://pressbooks.pub/aiforteachers/chapter/cookies-and-fingerprinting/" target="_blank" rel="noopener">Cookies 和指纹识别</a>的延伸阅读模块。</li>
         <li>在第三章，新添加了<a href="https://pressbooks.pub/aiforteachers/chapter/what-not-to-do-with-data-issues-of-personal-identity-bias-and-fairness/" target="_blank" rel="noopener">数据问题：个人身份</a>。</li>
         <li>在第三章，新添加了<a href="https://pressbooks.pub/aiforteachers/chapter/issues-with-data-bias-and-fairness/" target="_blank" rel="noopener">数据问题：偏见和公平</a>。</li>
         <li>在第四章，新添加<a href="https://pressbooks.pub/aiforteachers/chapter/the-flip-side-of-als-some-paradigms-to-take-note-of/" target="_blank" rel="noopener">ALS 的另一面：一些值得注意的范例</a>。</li>
         <li>在第五章，新添加<a href="https://pressbooks.pub/aiforteachers/chapter/deep-neural-networks/" target="_blank" rel="noopener">AI 语言：深度神经网络</a>。</li>
         <li>在第五章，新添加由 Wayne Holmes 博士撰写的<a href="https://pressbooks.pub/aiforteachers/chapter/ai-aied-and-human-agency/" target="_blank" rel="noopener">AI、人工智能与教育（AIED） 和人类代理</a>。</li>
         <li>在第五章，新添加<a href="https://pressbooks.pub/aiforteachers/chapter/homogenisation-invisibility-and-beyond-towards-an-ethical-ai/" target="_blank" rel="noopener">同质化、隐形化及其后，走向合乎伦理的 AI</a>。</li>
         <li>新增了<a href="https://pressbooks.pub/aiforteachers/part/on-generative-ai/" target="_blank" rel="noopener">关于生成式 AI</a>部分，包括由 Michael 和 John 撰写的<a href="https://pressbooks.pub/aiforteachers/chapter/an-introduction-to-generative-ai/" target="_blank" rel="noopener">生成式和对话式 AI</a><a href="https://pressbooks.pub/aiforteachers/chapter/an-introduction-to-generative-ai/" target="_blank" rel="noopener">介绍</a>，关于<a href="https://pressbooks.pub/aiforteachers/chapter/understanding-the-debates-about-the-possible-dangers-of-ai/" target="_blank" rel="noopener">理解 AI 可能危险的辩论</a>的延伸阅读模块，<a href="https://pressbooks.pub/aiforteachers/chapter/generative-for-the-classroom/" target="_blank" rel="noopener">课堂上的生成式 AI 第一部分</a>和<a href="https://pressbooks.pub/aiforteachers/chapter/generative-ai-for-the-classroom-part-ii/" target="_blank" rel="noopener">第二部分</a>中的关于<a href="https://pressbooks.pub/aiforteachers/chapter/generative-ais-where-should-a-teacher-use-them/" target="_blank" rel="noopener">生成式 AI。教师应该在哪里使用它们</a>的延伸阅读模块，然后还新增了Michael 撰写的<a href="https://pressbooks.pub/aiforteachers/chapter/of-assignments-and-assessments-2/" target="_blank" rel="noopener">ChatGPT 及其对学校作业的潜在影响</a>，Manuel 撰写的<a href="https://pressbooks.pub/aiforteachers/chapter/the-gears-of-generative/" target="_blank" rel="noopener">生成式 AI 的设备</a>，Bastien 撰写的<a href="https://pressbooks.pub/aiforteachers/chapter/of-assignments-and-assessments/" target="_blank" rel="noopener">提示的艺术、工艺或科学</a>以及<a href="https://pressbooks.pub/aiforteachers/chapter/the-degenerative/" target="_blank" rel="noopener">逆生成第1部分部分</a>和<a href="https://pressbooks.pub/aiforteachers/chapter/the-degenerative-part-2/" target="_blank" rel="noopener">第2部分</a>。</li>
         <li>在第七章，修改了<a href="https://pressbooks.pub/aiforteachers/chapter/teaching-ai/" target="_blank" rel="noopener"> AIbuzh</a><a href="https://pressbooks.pub/aiforteachers/chapter/teaching-ai/" target="_blank" rel="noopener">教授</a>撰写的部分。</li>
         <li>新增了关于<a href="https://pressbooks.pub/aiforteachers/chapter/ai-and-coding/" target="_blank" rel="noopener">AI 和编码：编码、无代码或低代码</a>的延伸阅读模块</li>
         <li>新增了由 BLAŽ ZUPAN 教授撰写的关于<a href="https://pressbooks.pub/aiforteachers/chapter/machine-learning-ai-through-data-experiments-in-orange/" target="_blank" rel="noopener">Orange</a>的延伸阅读模块。</li>
    </ol>
    <p>&nbsp;</p>
    <h3 style="text-align: left">新视频：</h3>
    <p>录制并添加了 15 个新视频。对所有帮助我们翻译背景文本和字幕的合作伙伴致以感谢，此外感谢Petra 对 Youtube 的支持。</p>
    <p>&nbsp;</p>
    <p>第一章<a href="https://pressbooks.pub/aiforteachers/chapter/ai-is-everywhere/" target="_blank" rel="noopener">AI 无处不在</a>中新增了两个视频，</p>
    <p>第一章<a href="https://pressbooks.pub/aiforteachers/chapter/ai-already-in-education/" target="_blank" rel="noopener">AI 已在教育中</a>中新增了一个视频，</p>
    <p>第二章<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-machine-learning/" target="_blank" rel="noopener">AI 语言：机器学习</a>中新增了三个视频，其中有一个视频链接到<a href="https://pressbooks.pub/aiforteachers/chapter/how-many-features-are-too-many/" target="_blank" rel="noopener">过拟合<span style="text-decoration: underline">；</span></a></p>
    <p>第二章<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual/" target="_blank" rel="noopener">搜索对个人的影响</a>中新增了一个视频，</p>
    <p>第三章<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-data-based-systems-part-1/" target="_blank" rel="noopener">基于数据的系统 第一部分</a>中新增了两个视频，</p>
    <p>第四章<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-how-youtube-learns-you-part-1/" target="_blank" rel="noopener">AI 语言：Youtube 如何了解你 第一部分</a>中新增了两个视频。</p>
    <p>第五章<a href="https://pressbooks.pub/aiforteachers/chapter/415/" target="_blank" rel="noopener">AI 语言：自然语言处理</a>中新增了一个视频，</p>
    <p>第六章<a href="https://pressbooks.pub/aiforteachers/chapter/the-gears-of-generative/" target="_blank" rel="noopener">生成式 AI 的齿轮</a>中新增了一个视频，</p>
    <p>第七章<a href="https://pressbooks.pub/aiforteachers/chapter/open-or-closed/" target="_blank" rel="noopener">开放还是封闭？</a>中有新增了一个视频。</p>
    <p>&nbsp;</p>
    <h3 style="text-align: left">其他修改：</h3>
    <p>修改了<a href="https://pressbooks.pub/aiforteachers/front-matter/33/" target="_blank" rel="noopener">作者信息</a>，</p>
    <p>修改了<a href="https://pressbooks.pub/aiforteachers/front-matter/introduction/" target="_blank" rel="noopener">前言</a>，</p>
    <p>第一章中添加了<a href="https://pressbooks.pub/aiforteachers/part/why-learn-about-ai/" target="_blank" rel="noopener">为什么学习 AI</a> 介绍，</p>
    <p>第二章中压缩了<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-search-engine-indexing/" target="_blank" rel="noopener">AI 语言：搜索引擎索引</a>章节，</p>
    <p>更改了第二章<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual-on-the-society/" target="_blank" rel="noopener">搜索对社会的影响</a>的参考列表和参考编号，</p>
    <p>新添加了第三章的介绍 2<a href="https://pressbooks.pub/aiforteachers/part/managing-learning/" target="_blank" rel="noopener">管理学习</a>，</p>
    <p>新添加了第五章的介绍<a href="https://pressbooks.pub/aiforteachers/part/listening-speaking-and-writing/" target="_blank" rel="noopener">听、说和写</a>。</p>
    <p>&nbsp;</p>
</section>
<section data-type="introduction" class="front-matter introduction" id="front-matter-slug-33" title="本书介绍">
    <header>
         <h1 class="front-matter-title">本书介绍</h1>
         <p data-type="subtitle" class="front-matter-number">2</p>
    </header>
    <h1 class="blocktext"><img class="size-medium wp-image-23 aligncenter" style="font-family: Georgia, 'Times New Roman', serif;font-size: 14pt;text-align: justify" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-300x83.jpg" alt="" width="300" height="83" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-300x83.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-1024x282.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-768x211.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-1536x423.jpg 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-65x18.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-225x62.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo-350x96.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ai4t-eu-logo.jpg 1740w" sizes="(max-width: 300px) 100vw, 300px" /></h1>
    <h1 class="blocktext"><strong>面向教师的人工智能教程：一本开放式教科书</strong></h1>
    <p style="text-align: center">作者</p>
    <h2 style="text-align: center">Colin de la Higuera 和 Jotsna Iyer</h2>
    <p>&nbsp;</p>
    <p style="text-align: center"><strong>译著</strong></p>
    <p style="text-align: center"><strong>王欢欢、朱立新、张进宝、黄荣怀、刘德建</strong></p>
    <p>&nbsp;</p>
    <p style="text-align: center">其他特邀贡献者</p>
    <p style="text-align: center">Anne Boyer, Azim Roussanaly, Bastien Masse, Blaž Zupan, Fabrizio Falchi, Giuseppe Città, Jiajun Pan, John Hurley, Manuel Gentile, Michael Hallissy, Wayne Holmes</p>
    <p>&nbsp;</p>
    <div class="textbox">
         <p><i>此教科书系Erasmus + 项目 AI4T 626145-EPP-1-2020-2-FR-EPPKA3-PI-POLICY的成果之一。它得益于所有合作伙伴的共同工作。</i></p>
         <p><i><br />
          欧盟委员会对本书出版的支持并不构成其对内容的认可，内容仅反映作者观点。委员会不对书中所含信息的任何使用承担责任。<br />
          </i></p>
    </div>
    <p><img class="size-medium wp-image-24 aligncenter" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-300x124.png" alt="" width="300" height="124" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-300x124.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-1024x423.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-768x318.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-1536x635.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-65x27.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-225x93.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo-350x145.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/Chaire-logo.png 1799w" sizes="(max-width: 300px) 100vw, 300px" /></p>
    <p style="text-align: center"><span style="font-size: 18.6667px"> </span></p>
    <p>&nbsp;</p>
    <p>&nbsp;</p>
</section>
<section data-type="halftitlepage" class="front-matter miscellaneous post-introduction" id="front-matter-acknowledgements" title="致谢">
    <header>
         <h1 class="front-matter-title">致谢</h1>
         <p data-type="subtitle" class="front-matter-number">3</p>
    </header>
    <p class="no-indent">我们感谢AI4T（面向教师的人工智能）项目的所有成员，感谢他们在内容研讨会和会议中的帮助和参与。本书的许多想法正是从这些活动中产生的。我们还要感谢研究人员、教师和学生，以及我们合作的学习小组，他们也做出了贡献。如果没有他们的帮助和投入，本书的写作是不可能完成的。</p>
    <p><img class="wp-image-26 aligncenter" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-300x213.png" alt="" width="531" height="377" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-300x213.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-1024x726.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-768x545.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-1536x1090.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-225x160.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos-350x248.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/AI4T-partner-logos.png 1748w" sizes="(max-width: 531px) 100vw, 531px" /></p>
</section>
<section data-type="halftitlepage" class="front-matter miscellaneous post-introduction" id="front-matter-about-the-project" title="关于项目">
    <header>
         <h1 class="front-matter-title">关于项目</h1>
         <p data-type="subtitle" class="front-matter-number">4</p>
    </header>
    <p class="no-indent">AI4T是一个（欧盟）Erasmus+项目。作为一个“关键行动3”（Key Action 3）项目，它涉及到各部委并由各部委进行试点。AI4T基于这样一种前提，即人工智能和教育不仅仅是工业界的话题，教育系统也应做好准备，确定如何在课堂上最好地利用人工智能，让教师放心，使他们成为负责任的用户，并启动有效的教师培训计划。</p>
    <p class="indent">关于项目更完整的介绍可以在<a href="https://www.ai4t.eu/about/" target="_blank" rel="noopener">项目网页</a>上找到。该项目也通过网络研讨会和会议进行了公开介绍。我们提出以下项目目标：</p>
    <ul>
         <li>制作课件培训教师如何在教育环境中使用人工智能；</li>
         <li>在五个国家的教师培训课程中使用这些课件；</li>
         <li>评估和记录培训的质量。</li>
    </ul>
    <p class="no-indent">为了实现这一目标，法国、爱尔兰、意大利、卢森堡和斯洛文尼亚五个国家的教育部组成了一个强大的联盟。来自这五个国家的评估专家以及在人工智能和教育方面拥有专业知识的学术团队也参与其中。</p>
    <ul>
         <li><strong>国家部委</strong>
         <ul>
              <li>国家教育、青年和体育部 (F，法国)</li>
              <li>都柏林西部教育中心 (IR，爱尔兰)</li>
              <li>教育部 (IT，意大利)</li>
              <li>教育和技术研究与创新协调部 (LU，卢森堡)</li>
              <li>教育、科学和体育部 (SL，斯洛文尼亚)</li>
         </ul>
          </li>
         <li><strong>评估单位</strong>
         <ul>
              <li>法国国立艺术学院 (FR，法国)</li>
              <li>教育研究中心 (IR，爱尔兰)</li>
              <li>国家文献、创新和教育研究所 (IT，意大利)</li>
              <li>卢森堡大学 (LU，卢森堡)</li>
              <li>教育研究所 (SL，斯洛文尼亚)</li>
         </ul>
          </li>
         <li><strong>研究机构</strong>
         <ul>
              <li>国家数字科学技术研究所 (FR，法国)</li>
              <li>南特大学 (LS2N) (FR，法国)</li>
              <li>洛林大学 (LORIA) (FR，法国)</li>
              <li>H2 Learning公司 (IR，爱尔兰)</li>
              <li>马里博尔大学 (SL，斯洛文尼亚)</li>
              <li>国家研究委员会 (IT，意大利)</li>
         </ul>
          </li>
    </ul>
</section>
<section data-type="halftitlepage" class="front-matter miscellaneous post-introduction" id="front-matter-introduction-2" title="前言">
    <header>
         <h1 class="front-matter-title">前言</h1>
         <p data-type="subtitle" class="front-matter-number">5</p>
    </header>
    <h3 style="text-align: left">第二版序言</h3>
    <p class="no-indent" style="text-align: center">欢  迎</p>
    <h3 class="no-indent" style="text-align: left">2022年10月至2023年10月</h3>
    <p class="no-indent">      本书的第一版于2022年10月出版。没过几天，ChatGPT就出现了。我们进入了为期十二个月的人工智能（AI）狂热。每周都有新产品推出，语言模型及其应用的改进也不断发布。更重要的是，教育似乎突然成为生成式人工智能的衡量标准。教师和教育机构迅速做出反应，承认新工具的到来，并将其纳入教育工具箱或因为可能带来的威胁而禁止使用它们。新闻媒体和国际组织都进行了讨论，还签署了请愿书和公开信。大家已经开始测量人工智能对就业市场的影响，一些公司已经开始用人工智能取代工人。</p>
    <p class="indent">对本书作者来说，所有这些带来了一个关键问题、一个挑战和一个机遇。这个<strong>问题</strong>是任何一本与技术相关的书籍的作者都害怕的问题：这本书是否已经过时？这可能是所有书籍中寿命最短的——只是几天的问题。<strong>挑战</strong>是要将ChatGPT海啸带来的新奇事物纳入第二版。而<strong>机会</strong>则是在最需要的时刻分享这本书。</p>
    <h3 style="text-align: left">问题：生成式人工智能的重要性是否意味着其他人工智能现在已经不再重要？</h3>
    <p class="no-indent">        这个问题是有意义的。ChatGPT之所以被很多人采用，是因为它非常容易使用。2023年的一些生成式人工智能专家对2022年的人工智能知之甚少。因此，很容易让人误以为生成型人工智能是建立在空中楼阁之上，如果目标是理解它们，只需阅读过去一年内发表的内容即可。那么，现在还有必要了解机器学习和人工智能技术人员在过去70年里开发的各种工具吗？</p>
    <p class="indent">我们相信答案是“是的”。即使是一个引人注目的飞跃，生成型人工智能也是建立在数十年来共享的技术和理念之上。理解数据、偏见、无监督学习、个性化和伦理仍然是教师在课堂上使用人工智能之前应该了解的关键。</p>
    <h3 class="no-indent" style="text-align: left">挑战</h3>
    <p class="no-indent">挑战在于如何以一种能够满足教师需求的方式来撰写关于快速发展的技术，毕竟他们希望从非短暂性的知识出发构建他们的教学，使用那些能够经得起时间考验的概念和技术。一个例子就是“幻觉”这一概念，它在过去十二个月里发生了巨大的变化，而且对于教师如何采用生成型人工智能将至关重要。</p>
    <h3 style="text-align: left">机会</h3>
    <p class="no-indent">机会则伴随着紧迫性而来，即如今所有利益相关者都在研究人工智能和教育问题。2020年，当AI4T项目启动时，困难在于如何招募足够的教师来了解人工智能，从而使项目的实验结果有效。到了2023年，这已成为所有国家最优先考虑的问题。</p>
    <h3 style="text-align: left">第二版有什么新内容？</h3>
    <p class="no-indent">显然，我们必须考虑到ChatGPT（及后来的其他人工智能）的出现。现在有一整节（7）专门用于理解这一现象，并开始提出教师应该如何利用这些技术。在技术方面，我们选择了突出视觉表达而非文本。因此，这个版本中有许多新的插图。我们还添加了15个短视频，希望能帮助理解重要概念。</p>
    <h3 style="text-align: left">开放性和多语言的挑战</h3>
    <p class="no-indent">这是一本开放式教科书。这意味着我们使用了知识共享许可协议（Creative Commons, CC）。所有的图片、视频和额外材料都经过了仔细审查，以便公开分享。这意味着任何人都可以取用整本教材或其中的部分，并按他们希望的方式使用。他们也可以进行修改。有不同的输出格式可供选择，作者也可以以任何方式共享，以确保这是一本可持续发展的教科书。它还将通过后续的版本和新项目继续存在。</p>
    <p class="indent">按照惯例，使用者唯一的义务是在相关情况下引用本书或具体章节的作者。</p>
    <p class="indent">其中一项特别的修改——翻译——我们已尽可能谨慎地考虑到了。我们已经开始将英文原版翻译成法语、斯洛文尼亚语、意大利语和德语。此外，将本书翻译成其他语言版本的新项目也在不断涌现。我们相信人工智能可以帮助翻译过程，只不过仍需要人工校正。</p>
    <p class="indent">如果您希望将本书翻译成您的语言，请与我们联系建立合作伙伴关系！</p>
    <h3 style="text-align: left">一年前我们在讨论什么？</h3>
    <p class="no-indent">让我们从你已经知道的开始：AI无处不在，在教育领域也不例外。对于一些人来说，未来是光明的，即将到来的技术将有助于让所有人都能接受教育；它甚至可能在教师数量不足时提供帮助。它将允许教师花更多时间在“高尚”的任务上，而机器将接管“无聊”的任务，如打分、组织课堂。</p>
    <p class="indent">对于有些人来说，这些人工智能算法代表着巨大的风险。教育行业准备投资的数十亿美元证明，教育现在已被视为一个市场。但这不是一个市场。在这些截然不同的立场之间，有一些研究人员、教育工作者和政策制定者持中立立场，他们意识到了一些问题：人工智能将长期存在，如果它还没有进入课堂，也终将会进入课堂。没有任何部长——更不用说教师——能够阻止这一切。所以，鉴于这个事实，教师如何驾驭这头野兽并利用人工智能来改进教育呢？教师如何才能让人工智能为课堂服务，而不是相反？</p>
    <p class="indent">本教科书的目的就是为教师提供这方面的支持。它是在Erasmus+项目AI4T的背景下开发的。来自爱尔兰、卢森堡、意大利、斯洛文尼亚和法国的团队共同合作，为教师学习人工智能（特别是教育领域的人工智能）提供学习资源。学习材料和项目及其结果的介绍可以在AI4T的网页（<a href="https://www.ai4t.eu/">https://www.ai4t.eu/</a>）上找到。</p>
    <p class="indent">培训教师是所有参与部委的一项基本任务，目标如下：</p>
    <ol>
         <li style="text-align: justify">让教师意识到为什么这样的培训是好的。培训不能是一个强加的决定，它必须是共同的决定。</li>
         <li style="text-align: justify">介绍人工智能：根据我们多次参加会议和研讨会的经验，有些参与者已经探索、阅读并内化了这个话题。然而，绝大多数人并没有这么做。</li>
         <li style="text-align: justify">解释人工智能在课堂上是如何发挥作用，有哪些机制？关键的思想是什么？</li>
         <li style="text-align: justify">在教育场景中使用人工智能。</li>
         <li style="text-align: justify">分析该领域正在发生的事情，并积极应对未来的变化。</li>
    </ol>
    <p class="no-indent">我们希望这本教科书能够帮助您解决其中的大多数问题。我们分析了当前的形势，并将AI与教师的经验联系起来。我们希望通过这样的方式，鼓励他们对这些问题保持兴趣。毫无疑问，我们将会遇到新的挑战，会犯错误，也可能会有强烈的反对意见和争议。在名为“AI说”（AI Speak）的模块，我们试图解释算法的工作原理。我们的目的是为教师提供信息，以便他们可以充分参与关于教育和人工智能的辩论和讨论。AI4T准备的视频中介绍了准备这份材料的一些理由。</p>
    <p class="indent">我们相信以下几点：</p>
    <ul>
         <li style="text-align: justify">具备一些AI素养是必要的。经常有人说“你不需要知道发动机是如何发动的，就可以开车”。这种说法不完全正确：我们大多数人不知道发动机是如何工作的，但我们都承认其中涉及到科学技术。我们之所以接受这一点，是因为我们在学校上过基础物理和技术课程。同样，我们不会满足于书里根据与吸烟有关的早死人数统计论据，来说服我们不要吸烟。同样，我们之所以能够理解吸烟为什么有害，是因为老师曾经向我们解释过呼吸系统是如何工作的，肺是什么等等。在AI对社会产生巨大影响的今天，我们相信这一点同样适用——仅仅了解AI的影响是不够的，教师需要了解它是<strong>如何</strong>工作的。我们的目标不是让每个人都成为生物学家或物理学家，而是让理解其中的原理和思想。</li>
         <li>教师是非凡的学习者。他们会在解释错误时提出批判，并更多地参与其中。他们希望理解。这本教科书就是为那些愿意付出额外努力的人准备的，他们在理解之前不会满足。</li>
         <li style="text-align: justify">AI必须在一个安全可信的环境中使用——计算机或设备将连接到网络，应用程序将在云端运行。这里存在一个巨大的安全问题，教师需要确保工作环境对所有人都是安全的。计算机安全是一个高度复杂的问题；教师无法检查软件的安全规格。这需要一个可信赖的机制来帮助完成。</li>
         <li style="text-align: justify">AI可以提供帮助，但前提是必须在一个明确界定且安全可控的学习环境中使用，而且是在教师认为重要的任务中使用。出于明显的经济原因，人工智能行业会将产品推荐向教师，表面上是为了帮助他们解决有时并不重要的任务。但如果产品被认为是“很不错”的，而且是由销售商推销的，那么它可能最终被视为重要的。一位好教师应该意识到这一点。在这本教科书中，我们介绍了帮助教师识别此类产品或情况的要素。</li>
         <li style="text-align: justify">在准备这个课程时，我们确实遇到了一个严重的问题。我们的想法是使用我们向教师推荐的AI软件，以便他们能够迅速在课堂上使用这些软件。不幸的是，情况并非如此：许多软件仍然不成熟，存在许多伦理问题，而且在大多数情况下，不同的部门和政府还没有一个获得批准的软件名单。因此，我们选择了一种不同的方法：我们将在教科书中提及软件。这是因为我们相信它能够解释人工智能在教育中的一个特定要点。不过，我们并不认可任何特定的软件。预计不久之后，联合国教科文组织、联合国儿童基金会或欧盟委员会等国际机构将提出具体的软件推荐建议。</li>
    </ul>
    <p>我们要感谢帮助编写这本书的众多贡献者。</p>
    <p class="indent">首先，我们从韦恩·霍姆斯（Wayne Holmes）的工作中受益匪浅，并与他进行了长时间的讨论。AI4T联盟内部也进行了讨论。为了确定主题，我们组织了研讨会。教师本身也是一个重要的信息来源——通过研讨会和网络研讨会，我们与他们交流了想法，他们让我们知道哪些是令人困惑的和/或错误的。许多人提供了宝贵的意见，校对了文件，并建议了链接资源和文本。有些人为本著作撰写了章节：</p>
    <p style="padding-left: 40px">Manuel Gentile帮助我们完成了许多章节，并展示了他让人工智能最晦涩的方面变得通俗易懂的高超技巧；<br />
     Fabrizio Falchi和Giuseppe Città是很棒的合作者，他们帮助我们理解了各种人工智能问题；<br />
     Azim Roussanaly、Anne Boyer和Jiajun Pan非常好地撰写了关于学习分析的章节；<br />
     Wayne Holmes撰写了关于代理的章节。这个话题在讨论人工智能的伦理影响时非常重要；<br />
     Michael Halissy和John Hurley探讨了生成式人工智能到来后作业和评估的问题；<br />
     Bastien Masse是当今掌握了提示工程的专家，他在这里分享了他的技能；<br />
     Blaž Zupan介绍了他们团队正在开发的Orange软件，以便利用机器学习。</p>
    <p>        我们也非常感谢那些协调将这本教材翻译成法语、意大利语、德语和斯洛文尼亚语的人。特别感谢Solenn、Manuel、Daniela和Helena。</p>
    <p>2023年11月26日，于海滨平原La Plaine sur Mer</p>
    <p>Colin de la Higuera</p>
</section>
<section data-type="halftitlepage" class="front-matter miscellaneous post-introduction" id="front-matter-e4b8ade69687e78988e5ba8f" title="中文版序">
    <header>
         <h1 class="front-matter-title">中文版序</h1>
         <p data-type="subtitle" class="front-matter-number">6</p>
    </header>
    <p class="indent">在这个人工智能技术飞速发展的时代，教育领域正面临着前所未有的机遇与挑战。人工智能与教育的深度融合，已成为推动教育改革与创新的重要力量。在此背景下，联合国教科文组织人工智能与教育教席（UNESCO Chair on AI in Education，简称教席）团队有幸承担了《面向教师的人工智能教程》这本开放获取教材的翻译工作。我们教席于2023年初在北京师范大学成立，主要聚焦教育领域人工智能相关研究、培训、信息共享和文献工作。这本教材的主题与我们教席的工作规划高度一致，它旨在为广大教育工作者和研究者提供一部关于在教师工作中应用人工智能的实用教程。</p>
    <p class="indent">《面向教师的人工智能教程》是Colin de la Higuera 教授和 Jotsna Iyer 基于欧盟Erasmus + 项目 AI4T的产出编撰而成 。Colin de la Higuera教授在人工智能与教育领域具有深厚的学术造诣和丰富的实践经验。自2024年初，我们接到Colin de la Higuera教授的邀请后，便着手开展这部著作的中文版翻译工作。在此过程中，我们得到了联合国教科文组织人工智能与教育教席主持人黄荣怀教授的鼎力支持，以及教席成员北京师范大学助理研究员王欢欢、北京师范大学副教授张进宝、北京师范大学高级工程师朱立新、北京师范大学智慧学习研究院联席院长刘德建博士等的贡献。此外，科研助理徐嘉欣、叶小蕤、余佳芸也在翻译过程中提供了有力支持。</p>
    <p class="indent">本书围绕帮助教师理解和使用人工智能的目标展开，深入讲解了人工智能技术在教学中的应用及其对教师角色的影响。书中既有理论阐述，又有实践案例，为广大教育工作者提供了宝贵的借鉴和启示。我们相信，本书的出版将有助于推动我国人工智能与教育的融合发展，为培养新时代的教师队伍提供有力支持。</p>
    <p class="indent">在此，我们要感谢所有参与本书翻译工作的团队成员，正是你们的共同努力，才使得这部著作得以顺利呈现给广大读者。同时，我们也希望本书能为我国人工智能与教育领域的研究和实践带来新的思考，为我国教育事业的繁荣发展贡献力量。</p>
    <p class="indent">最后，祝愿广大读者在阅读本书的过程中，能够汲取智慧，激发创新，共同书写人工智能与教育的新篇章！</p>
    <p>&nbsp;</p>
    <p class="indent">联合国教科文组织人工智能与教育教席团队</p>
    <p class="indent">2024年夏</p>
</section>
<div data-type="part" class="part" id="part-why-learn-about-ai">
    <header>
         <h1 class="part-title">我们为什么要学习人工智能（AI）</h1>
         <p data-type="subtitle" class="part-number">I</p>
    </header>
    <p class="no-indent">你是否曾经问过自己如下问题，</p>
    <p class="indent">“AI会如何影响我教室里的学习和教学？”</p>
    <p class="indent">“它能帮助我实现我想要与我的学生一起做的事情吗？”</p>
    <p class="indent">“它会如何改变我与学生之间的互动？”</p>
    <p class="indent">“如何才能知道我是否在正确地使用它？”</p>
    <p class="indent">“如果我想有效地利用它，应该注意什么？”</p>
    <p class="no-indent">请继续阅读&#8230;</p>
    <section data-type="chapter" class="chapter" id="chapter-technology-change-and-you" title="技术、变革与你我">
         <header>
              <h1 class="chapter-title">技术、变革与你我</h1>
              <p data-type="subtitle" class="chapter-number">1</p>
         </header>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title">思考</p>
              </header>
              <div class="textbox__content">
                   <p>1922年，托马斯·爱迪生宣称电影将革新教育。他相信它会<span style="font-size: 1em;text-align: justify">取代所有教科书<sup>1</sup>。</span></p>
                   <figure id="attachment_31" aria-describedby="caption-attachment-31" style="width: 296px" class="wp-caption alignright">
                        <img class="wp-image-31" style="margin-top: 1em;margin-bottom: 1em;padding-left: 0px;text-align: left" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-300x297.jpg" alt="" width="296" height="294" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-300x297.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-1024x1015.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-150x150.jpg 150w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-768x761.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-1536x1523.jpg 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-65x64.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-225x223.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel-350x347.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page1-Kodak-carousel.jpg 1713w" sizes="(max-width: 296px) 100vw, 296px" />
                        <figcaption id="caption-attachment-31" class="wp-caption-text">“Carousel &#8217;77” 由 Voxphoto 拍摄，根据 CC BY-NC-ND 2.0 许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nd-nc/2.0/jp/?ref=openverse">https://creativecommons.org/licenses/by-nd-nc/2.0/jp/?ref=openverse</a>。</figcaption>
                   </figure>
                   <p>然而，教师对电影的使用是有限的。从1950年代到1990年代末，许多教师使用了幻灯片放映机进行教学。</p>
                   <p>与使用电影不同，教师可以：</p>
                   <ul>
                        <li> 自己准备幻灯片，耗费低廉</li>
                        <li> 使用放映机就像使用黑板一样，不需要改变他们教学方式</li>
                        <li>幻灯片可以重复使用，也可以进行重新排序及不断改进<sup>2</sup>。</li>
                   </ul>
                   <p class="indent">如果有一项新技术可以帮助你，</p>
                   <ol>
                        <li><em>你会希望有它哪些功能？</em></li>
                        <li><em>你会为了使用它而改变你的教学实践吗？</em></li>
                        <li><em>你害怕需要被迫进行改变吗？</em></li>
                   </ol>
              </div>
         </div>
         <h3 style="text-align: left">人工智能与你我</h3>
         <p class="no-indent">作为一名教师，你每天都在面对技术带来的变化。技术的应用改变了你所教学的世界以及你教的学生。最终，它们改变了你的授课内容、技能和环境。同时它们还可以改变你的教学方法。</p>
         <p class="indent">这本教科书中将会讨论人工智能（AI）如何改变你的教学方式。</p>
         <p class="no-indent"><strong><em>为什么是AI</em>？</strong> 在AI有效时，它带来变化的速度和幅度可能是颠覆性的。而且，还有哪些是“智能”机器做不到的事情吗？它能超越你作为一名教师的表现吗？它能在教室里取代你吗？以上几个重要的问题需要我们去回答。</p>
         <figure id="attachment_32" aria-describedby="caption-attachment-32" style="width: 300px" class="wp-caption alignleft">
              <img class="wp-image-32 size-medium" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-300x225.png" alt="" width="300" height="225" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-1024x768.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-1536x1152.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling-350x263.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-1-TM-juggling.png 2048w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption id="caption-attachment-32" class="wp-caption-text">“教学机器日记” 由 [ Ed ] 拍摄，根据 CC BY-NC-SA 2.0 许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">如今的人工智能应用是为一个特定任务和一种类型的用户创建的——例如，翻译软件就不能预测股票价格。</p>
         <p class="indent">至于任务自身，是的，在完成某些任务上，AI可以比人类做得更好。但对于其他大部分任务，即使是一个孩子也可以击败最好的AI。对于与丰富的认知、社会和文化息息相关的活动，例如教学，AI要想取代人类还有很长的路要走。但它可以帮助教师做更多的事情。专家曾提到过“被增强的人类”<sup>3</sup>，在我们这里的情景中，将是“被增强的教师”。</p>
         <p class="indent">在教育中，在AI提供帮助时，教育专家强调应该始终让教师参与其中，监督它的工作。在课堂上AI的有效使用方案是赋予权力给教师。当教师清楚知道学生在学习什么时，收益显著<sup>4</sup>。</p>
         <p class="indent">这本教科书的目的是为教师提供关于必要的知识来决定是否使用AI，在什么地方使用以及如何使用AI。我们希望帮助教师为应对未来做好准备，应对AI带来的变化。</p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"></p>
              </header>
              <div class="textbox__content">
                   <p>请看BBC的测量”<a href="https://www.bbc.com/news/technology-34066941" target="_blank" rel="noopener">机器人会取代你的工作吗</a>“中关于对未来英国不同工作的看法。如果你的工作需要与人协商，需要帮助、协助他人，或者在工作需要你产出原创想法，那么你的工作不太可能会被自动化取代。对于“中学教育教学专业人员”，该工具估测他们被自动化取代的可能性为1%。</p>
              </div>
         </div>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Cuban, L., Teachers and machines: The classroom use of technology since 1920, Teacher College, 1986.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Lee, M., Winzenried, A., The use of Instructional Technology in Schools, Lessons to be learned, AcerPress, 2009.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Holmes, W., Bialik, M., Fadel, C., Artificial Intelligence In Education: Promises and Implicationsfor Teaching and Learning, 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup> Groff, J., Personalized Learning: The state of the field and future directions, Centre for curriculumredesign, 2017.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-is-everywhere" title="AI 无处不在">
         <header>
              <h1 class="chapter-title">AI 无处不在</h1>
              <p data-type="subtitle" class="chapter-number">2</p>
         </header>
         <h3 style="text-align: left">AI：一种直观的理解</h3>
         <p><a href="https://www.bilibili.com/video/BV17U411o78X/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">视频：[AI4T] 什么是AI？(What is AI?)</a></p>
         <p class="no-indent">如果打开一本AI的教科书或在互联网上进行搜索，你会发现人们对AI的定义各不相同。什么是AI，它在哪里被使用以及它扮演什么角色，这些问题一直都没有一个很好的方式去解答。它可能是一个像机器人或自动驾驶汽车一样的复杂独立系统。它也可能只是一个软件内的几行代码，扮演一个小角色。</p>
         <p class="indent"><a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/AI intelligence.jpg" data-size="medium" data-align="right" data-caption="none" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/AI intelligence.jpg"></a>AI涉及一系列执行多样化任务的程序。从数学和算法上来讲，它的界限模糊——对于AI从何处开始，以及其他技术在何处停止都没有明确的说明。</p>
         <p><img class="alignright wp-image-820" style="font-size: 14pt" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.1-e1717737017262.png" alt="" width="287" height="510" /></p>
         <p class="indent">此外，许多专家不同意使用“智能（intelligence）”这个词——人工智能与人类智能没有相似之处！然而，这个词向我们暗示了这些程序旨在实现的目标——它们之间的联系线索。</p>
         <p class="indent">最终，AI系统是基于机器的。它们通过以下方式做出预测、推荐或决策：</p>
         <ul>
              <li>感知真实或虚拟环境（使用诸如麦克风或摄像头之类的设备），</li>
              <li>简化并分析数据，</li>
              <li>使用分析做出决策或预测<sup>1</sup>。</li>
         </ul>
         <p class="no-indent">当你遇到一个系统能够：</p>
         <ul>
              <li>识别你所写的或你所说的内容（如翻译软件、文本识别、面部识别、个性化助理、网络留言板）；或者，</li>
              <li>使用时间越长它就越了解你（如Youtube视频推荐、新闻推荐、亚马逊商品推荐、Facebook的朋友建议、定向广告）；或者，</li>
              <li>能够在信息不完整且处于快速变化的情况下预测结果（去往某处的最快路线、未来的股票价格），</li>
         </ul>
         <p class="indent">&#8230;AI很可能参与其中。</p>
         <p><a class="inline" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/5 ideas in AI.PNG" data-size="medium" data-align="center" data-caption="description" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/5 ideas in AI.PNG"></a></p>
         <figure id="attachment_864" aria-describedby="caption-attachment-864" style="width: 317px" class="wp-caption aligncenter">
              <img class="wp-image-864" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3.png" alt="" width="317" height="307" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3.png 903w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3-300x290.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3-768x743.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3-65x63.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3-225x218.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-2.2-3-350x339.png 350w" sizes="(max-width: 317px) 100vw, 317px" />
              <figcaption id="caption-attachment-864" class="wp-caption-text">人工智能中的五大理念。来源：AI4K12 Initiative。授权使用CC BY-NC-SA 4.0。访问 <a href="https://creativecommons.org/licenses/by-nc-sa/4.0/">https://creativecommons.org/licenses/by-nc-sa/4.0/</a></figcaption>
         </figure>
         <h3 class="indent no-indent" style="text-align: left">我们身边的AI</h3>
         <p class="no-indent">AI已成为一种能赋能用户成功所需优势的技术。几乎每个领域都在以某种形式使用着AI：</p>
         <ul>
              <li>
              <p class="indent">从商业到研究，许多领域使用语言应用程序进行即时转录语音和获取高质量的翻译。</p>
               </li>
              <li>
              <p class="indent">医学在图像分析和基于AI的决策支持工具中获益<sup>2</sup>。</p>
               </li>
              <li>
              <p class="indent">在农业上，AI驱动的系统帮助可以优化可获取资源的使用。</p>
               </li>
              <li>
              <p class="indent">每天都有关于游戏、艺术、工业和商业界中AI带来新突破的新闻。</p>
               </li>
         </ul>
         <p class="indent">在学校，课件的选择，适应个体学习者，以有效的方式评估他们以及做好后勤管理，这些都是“智能”的活动。根据定义，理想情况下基于AI的软件应该能够帮助完成这些活动。</p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>活动</strong></p>
              </header>
              <div class="textbox__content">
                   <p>请列出你或你的学生在过去两年中使用过的五项技术。你认为，其中有多少项技术涉及AI？</p>
              </div>
         </div>
         <p class="no-indent">许多人认为艾伦·图灵是计算机科学之父。如今AI中的许多新想法实际上也是由艾伦·图灵在“AI”一词发明之前就引入的！</p>
         <p><a href="https://www.bilibili.com/video/BV18i421v7xq/?share_source=copy_web">[AI4T] 人工智能是阿兰-图灵发明的吗？(Did Alan Turing invent AI?)</a></p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> <a href="https://oecd.ai/en/ai-principles" target="_blank" rel="noopener" data-cke-saved-href="https://oecd.ai/en/ai-principles">The OECD AI Principles</a>, 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup><a href="https://en.wikipedia.org/wiki/Artificial_intelligence_in_healthcare">Artificial Intelligence in Healthcare, Wikipedia</a>.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-already-in-education" title="AI 已进入教育领域">
         <header>
              <h1 class="chapter-title">AI 已进入教育领域</h1>
              <p data-type="subtitle" class="chapter-number">3</p>
         </header>
         <h3 style="color: #737273;text-align: left">无论是教师还是学生，无论是有意还是无意，无论是好是坏，他们都已经在课堂内外使用人工智能。这是如何做到的？</h3>
         <p class="no-indent">        在本书的后续部分，我们将探讨用于教育的人工智能工具。但许多最有用的应用程序还尚未进入课堂。教育技术行业、大型数字公司和大学研究实验室都在开发工具，以帮助教师教学和学习者学习。越来越多专门从事AI的公司在教育领域进行巨额投资。无论是否获得相关权威机构的批准，这些免费工具都在被教师和学生所使用。</p>
         <p class="indent">无论是否以教育为目的开发，这些工具都可能在课堂上使用。有必要了解它们的可能带来益处和潜在问题。</p>
         <p class="indent">在撰写本书时，一个可用的免费数学应用程序是Photomath。（对于语文教师来说，类似的例子可能是语言学习应用程序Duolingo或使用GPT3的写作软件。）</p>
         <p><a href="https://www.bilibili.com/video/BV1S4421X7Mr/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">视频：[AI4T] Photomath 2.0</a></p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>反思</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent">通常，在研究软件的使用时，我们会看到制造商发布的视频。其中第三方的评论可能出自隶属或非隶属于制造商的不同机构。</p>
                   <p>如何区分真相和夸大其词？</p>
                   <p>应用程序是否真的像视频中声称的那样有用？</p>
                   <p>使用其功能有困难吗？</p>
                   <p>使用这些功能可能会带来哪些潜在问题？</p>
              </div>
         </div>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><a href="https://pressbooks.pub/aiforteachers/chapter/optical-character-recognition/" target="_blank" rel="noopener">点击此处阅读关于</a></p>
              </header>
              <div class="textbox__content">
                   <h5 class="heading_font heading_weight clearboth">光学字符识别</h5>
              </div>
         </div>
         <p class="no-indent">        Photomath是一个<em>数学求解器</em>。它能够求解数学方程式。教师一直在应对计算器，因为它既是教学工具，也是作弊工具。</p>
         <p class="indent">Photomath的强大之处在于它的易用性：只需点击黑板或笔记本中的照片，Photomath中的AI可以扫描照片并直接解决问题。</p>
         <p class="indent">假设计算器给出的答案是<a href="https://pressbooks.pub/aiforteachers/chapter/42/" target="_blank" rel="noopener">42</a>，教师可以允许使用计算器来检查结果，但学生必须自己求解。像这样的求解器可以展示多种解决问题的方法并将其可视化，不过这对程序员的技术要求要低得多。</p>
         <p class="indent">在当今课堂上发现的其他应用程序有：</p>
         <ul>
              <li>搜索引擎</li>
              <li>大多数写作软件内置的拼写检查和语法纠正</li>
              <li>在线翻译器</li>
              <li>语言学习移动程序</li>
              <li>数学求解器，如Photomath、Geogebra和Wolfram</li>
              <li>个人助理</li>
              <li>聊天机器人</li>
              <li>智能导学系统</li>
              <li>AI驱动的学习管理系统</li>
         </ul>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>反思</strong></p>
              </header>
              <div class="textbox__content">
                   还有另一个名为<a href="https://checkmath.com/index.html" target="_blank" rel="noopener">Checkmath</a>的软件，与<a href="https://photomath.com/en" target="_blank" rel="noopener">Photomath</a>类似。请查看它们各自的网站。<strong>如果你必须选择一个</strong>，你会选择哪一个？为什么？
              </div>
         </div>
         <h3 style="text-align: left">使用AI是作弊吗：教师们的反应如何？</h3>
         <p class="no-indent">以下是一些教师对学生使用AI的反应：</p>
         <p><a href="https://www.bilibili.com/video/BV1Az421h7Ln/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">视频：[AI4T] 使用人工智能是作弊吗：教师的反应如何？(Is using AI cheating: What are the teachers’ reactions?)</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-how-ai-can-help-you" title="AI如何帮助您">
         <header>
              <h1 class="chapter-title">AI如何帮助您</h1>
              <p data-type="subtitle" class="chapter-number">4</p>
         </header>
         <p class="no-indent">在技术领域，有两个极端需要注意：</p>
         <ul>
              <li>因恐惧和无知而未充分利用技术</li>
              <li>不加选择的使用可能导致不良后果</li>
         </ul>
         <p class="no-indent">例如，过度使用手机可能有害。有些地方完全避免使用手机。不过，大多数人都不会过度使用手机。事实上，谨慎使用移动技术已经挽救了生命。</p>
         <p class="indent">为了避免陷入上述第一个例子，了解重要的教育应用程序的知识将很有帮助。我们将在接下来的章节中逐一进行深入探讨。下面是一些例子。</p>
         <h3 style="text-align: left">用于管理学习的AI工具</h3>
         <figure id="attachment_38" aria-describedby="caption-attachment-38" style="width: 300px" class="wp-caption alignleft">
              <img class="wp-image-38 size-medium" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-300x225.png" alt="" width="300" height="225" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-1024x768.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-1536x1152.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting-350x263.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-page-4-TM-painting.png 2048w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption id="caption-attachment-38" class="wp-caption-text">“教学机器日记” 由 [ Ed ] 授权 CC BY-NC-SA 2.0。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>.</figcaption>
         </figure>
         <p class="no-indent">       人工智能<strong>仪表板</strong>、其他<strong>数据可视化工具</strong>和<strong>学习管理系统</strong>将所有可用信息汇集在一起。这些工具有助于监控学生在多个科目上的表现，或跟踪任何规模教室中任何教学的进展情况。</p>
         <p class="indent">AI应用程序可以<strong>标记潜在问题</strong>，例如缺勤和辍学等常见的行为。因此收集的所有数据都可以作为<strong>教师的自我评估</strong>，显示哪些课程是有效的，哪些地方需要改变方法。</p>
         <p class="indent">AI适用于<strong>调度和资源优化</strong>任务。但最重要的应用是处理包容性和与残障人士的融合。人机界面从未像现在这样无缝衔接，这使得多媒体输入和输出成为可能。例如，<a href="https://developer.huawei.com/consumer/en/doc/development/hiai-Guides/storysign-0000001055597759" target="_blank" rel="noopener" data-cke-saved-href="https://developer.huawei.com/consumer/en/doc/development/hiai-Guides/storysign-0000001055597759">Storysign</a>应用程序可以将文字翻译成手语，以帮助聋哑儿童学习阅读。</p>
         <h3 style="text-align: left">用于个性化学习的AI工具<a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/4.jpg" data-size="medium" data-align="right" data-caption="none" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/4.jpg"></a></h3>
         <ul>
              <li style="text-align: left"><b data-wp-editing="1"><img class="alignright wp-image-835" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1.png" alt="" width="371" height="262" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1.png 4973w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-4.1-350x247.png 350w" sizes="(max-width: 371px) 100vw, 371px" /></b><strong>自适应学习系统</strong>（Adaptive Learning Systems ，ALSs）通过测验或实时反馈对学习者进行评估。根据评估结果，它们为学生提供预定义的学习路径。与“一刀切”的方法不同，学生可以在每个主题上花费或多或少的时间，探索新的相关主题。这种自适应软件可以帮助他们学习阅读、写作、发音和解决问题。</li>
              <li>自适应学习系统还可以帮助有特殊需求的学习者。系统的任何个性化都将建立在经过验证的理论和专家意见的基础之上。有针对性的系统“对于教授认知障碍个体（如唐氏综合症、创伤性脑损伤或痴呆）以及轻度认知问题（如阅读障碍、注意力缺陷障碍和计算障碍）的个体来说，可能会大有帮助”<sup>1</sup>。</li>
              <li>虑到每个成员的个人优势和劣势，可以根据不同的活动形成不同的小组（“<strong>聚类</strong>”）。</li>
         </ul>
         <p class="no-indent">虽然这些技术可以提供帮助，“但关键在于如何实际使用这些技术”<sup>2</sup>。同样的创新和强大的学习技术，可能在一所学校中被有效使用，而在另一所学校中则可能使用不当<sup>2</sup>。</p>
         <p class="indent">再次强调，知识是关键！</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Alkhatlan, A., Kalita, J.K., <em>Intelligent Tutoring Systems: A Comprehensive Historical Survey with </em><em>Recent Developments</em>, International Journal of Computer Applications 181(43):1-20, March 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Groff, J., <em>Personalized Learning: The state of the field and future directions</em>, Centre for curriculum redesign, 2017.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-why-not-just-do-ai-part-1" title="为什么不直接使用AI，第1部分">
         <header>
              <h1 class="chapter-title">为什么不直接使用AI，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">5</p>
         </header>
         <p class="no-indent">在AI领域，第二个极端立场是不加区分地使用或滥用技术。人工智能与人类智能的工作方式不同。无论是由于情境的本质特征、其设计还是数据，AI系统的工作方式可能与预期不同。</p>
         <p class="indent">例如，使用一组数据用于一个目的而开发的应用程序，将无法在用于另一个目的的其他数据上运行良好。了解人工智能的局限性并加以纠正是有值得的；不仅去研究AI，同时还能去了解它的优点和局限性，这是件很好的事。</p>
         <h3 style="text-align: left">刻板印象的固化</h3>
         <p class="no-indent">谷歌翻译是通过互联网去学习如何进行翻译的。它的“数据挖掘者”通过在公共网络上搜索数据来学习。除了语言，AI还学到男性机械师的人数多于女性机械师，女性护士的人数超过男性护士。它无法区分哪些是“真实”的，哪些是因为刻板印象和其他偏见造成的结果。谷歌翻译最终将它所学到的进行传播，因此进一步巩固了刻板印象<sup>1</sup>：</p>
         <figure id="attachment_41" aria-describedby="caption-attachment-41" style="width: 1024px" class="wp-caption alignnone">
              <img class="wp-image-41 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-1024x432.png" alt="" width="1024" height="432" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-1024x432.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-300x126.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-768x324.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-1536x648.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-65x27.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-225x95.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate-350x148.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch1-Page-5-translate.png 1729w" sizes="(max-width: 1024px) 100vw, 1024px" />
              <figcaption id="caption-attachment-41" class="wp-caption-text">将“女性机械师”和“男性护士”翻译成英语然后再翻译回法语，变成了“男性机械师”和“女性护士”。该例子受到Barocas, S., Hardt, M., Narayanan, A., Fairness and machine learning Limitations and Opportunities, MIT Press, 2023的启发。</figcaption>
         </figure>
         <p class="no-indent">每当个别案例与大多数案例不同时（无论这是真实地反映了现实世界中的大多数，还是仅代表了互联网所代表的大多数），AI就会出现问题。在课堂上，教师必须弥补系统带来的失误，并在必要时将学生的注意力引向备选的文本。</p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>探索</strong></p>
              </header>
              <p class="textbox__content no-indent">你能在<a href="https://translate.google.com/" target="_blank" rel="noopener" data-cke-saved-href="https://translate.google.com/">谷歌翻译</a>中找到一个刻板印象吗？尝试用不同的语言进行翻译。通过点击两个翻译框之间的双箭头，你可以交换源语言和翻译目标语言（这就是我们在上面示例中所做的）。</p>
              <p class="indent">像土耳其语这样的语言对于“他”和“她”的词语使用相同。当从土耳其语翻译回来时，许多刻板印象就显现出来。请注意，许多语言都有男性偏见——未知性别的人被假定为男性。这并不是应用程序的偏见。令人震惊的是，在上面我们展示的例子中男性护士被改成了女性。</p>
         </div>
         <h3 style="text-align: left">多种准确性度量</h3>
         <p class="no-indent"><img class="alignleft wp-image-838" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1.png" alt="" width="377" height="267" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1.png 4973w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-5.1-350x247.png 350w" sizes="(max-width: 377px) 100vw, 377px" />AI系统能预测学生接下来应该学习什么，他或她是否理解了一个主题，班级如何进行分组更好，或者学生何时有辍学的风险。这些预测通常会附有一个百分比值。这个数字告诉我们系统对其预测的准确性如何高。</p>
         <p class="indent">本质上，预测可能是错误的。在许多应用中，这种错误是可以接受的，在某些情况下，这是不可接受的。而且，对这种错误的计算方式并不固定。有不同的度量方法，程序员来选择他或她认为最合适的。通常，准确性会根据输入本身而变化。</p>
         <p class="indent">在课堂上，这些系统会对儿童进行预测，教师需要判断什么是可接受的，并在AI做出不适当的决定时采取行动。为此，了解AI技术的背景知识及其常见的错误将大有裨益。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <a href="https://fairmlbook.org/">Fairness and machine learning Limitations and Opportunities, MIT Press, 2023.</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-why-not-just-do-ai-part-2" title="为什么不直接使用AI，第2部分">
         <header>
              <h1 class="chapter-title">为什么不直接使用AI，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">6</p>
         </header>
         <h3 style="text-align: left">数据与隐私</h3>
         <p class="no-indent"><img class="alignleft wp-image-841" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1.png" alt="" width="321" height="161" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-300x150.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-1024x512.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-768x384.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-1536x768.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-2048x1024.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-65x33.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-225x113.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-6.1-350x175.png 350w" sizes="(max-width: 321px) 100vw, 321px" />所有企业都使用数据来改善他们的资产负债表。他们利用数据来决定销售什么，向谁销售，定价多少以及如何定制广告。机器学习算法使数据变得有意义。因此，谁拥有拥有更好的数据和算法，谁就是赢家。数据是新的黄金，也是新的阿喀琉斯之踵。</p>
         <p class="indent"><em>这里的数据仅指个人地址和银行账户吗？</em></p>
         <p class="indent"><em>访问网站时用户点击鼠标的次数呢？</em></p>
         <p class="indent">作为自己和学生数据的管理者，教师有必要知道哪种AI数据有用，它们有哪些形式以及如何保护用户的隐私。</p>
         <h3 style="text-align: left">AI与教育事业</h3>
         <p class="no-indent">“教育技术”（EdTech）是指将技术应用于教育的行业，包括使用人工智能的应用。这些公司可以是小公司或初创企业，也可以是开始向教育投资的互联网巨头。它们也可以是拥有公共资金的实体机构。</p>
         <p class="indent">一些教育技术软件需要购买。其余的则是免费的，其收入来自其他方面——通常是定向广告和转售用户数据。无论教育技术 AI使用何种财务模式，都可以盈利。</p>
         <p class="indent">这对你和你的学生意味着什么？世上有免费的午餐吗？我们在享受一个贪婪行业的成果的同时，如何保护我们的课堂安全？</p>
         <h3 style="text-align: left">工具创建与你</h3>
         <p class="no-indent">教育不必为了适应技术而改变。“以技术为起点的学习环境往往会走向不理想的路径”<sup>1</sup>。任何工具都应基于健全的教学理论。此外，为了达到最佳效果，它应该由教师、教育专家和计算机科学家组成的团队共同创建<sup>2</sup>。</p>
         <p class="indent">那么，你准备好开始了吗？</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1  </sup>Groff, J., <em>Personalized Learning : The state of the field and future directions</em>, Centre for curriculum redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Du Boulay, B., Poulovasillis, A., Holmes, W., and Mavrikis, M., <em>Artificial Intelligence And Big Data </em><em>Technologies To Close The Achievement Gap</em>, 2018.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-chapter-1" title="第一章">
         <header>
              <h1 class="chapter-title"><span class="display-none">第一章</span></h1>
              <p data-type="subtitle" class="chapter-number">7</p>
         </header>
         <p>这是正文的第一个章节。你可以修改文本，重命名章节，添加新章节，以及添加新模块。</p>
    </section>
</div>
<div data-type="part" class="part" id="part-finding-information">
    <header>
         <h1 class="part-title">寻找信息</h1>
         <p data-type="subtitle" class="part-number">II</p>
    </header>
    <p class="no-indent">1993年6月，网站数量达到130个。到1996年初，这一数字增加到了100,000个。据估计，截至2022年，这一数字已达到17亿。</p>
    <p class="indent">如果没有找到我们想要的确切信息的能力，这种爆炸式增长几乎毫无意义。搜索引擎对帮助我们做到这一点上表现出色。</p>
    <p class="indent">它们能读懂我们匆忙输入的、常常有拼写错误的查询，并输出文本、图片、视频以及所有相关内容。</p>
    <p class="indent"><em>这种对信息的快速获取如何能帮助教育？</em></p>
    <p class="indent"><em>它如何帮助学生主导的学习——在这种学习中，学生通过建设性活动构建他们的知识？</em></p>
    <p class="indent"><em>如何在避免其缺点的同时，最大限度地利用这项技术？</em></p>
    <p>&nbsp;</p>
    <p>&nbsp;</p>
    <section data-type="chapter" class="chapter" id="chapter-search-engines-part-1" title="搜索引擎 第1部分">
         <header>
              <h1 class="chapter-title">搜索引擎 第1部分</h1>
              <p data-type="subtitle" class="chapter-number">8</p>
         </header>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>活动</strong></p>
              </header>
              <div class="textbox__content">
                   <p>从下面的列表中选择一个搜索引擎：</p>
                   <figure id="attachment_47" aria-describedby="caption-attachment-47" style="width: 200px" class="wp-caption alignright">
                        <img class="size-medium wp-image-47" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-300x300.png" alt="" width="200" height="200" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-300x300.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-150x150.png 150w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-65x65.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-225x225.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo-350x350.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-1-Duckduckgo.png 700w" sizes="(max-width: 200px) 100vw, 200px" />
                        <figcaption id="caption-attachment-47" class="wp-caption-text">&#8220;duckduckgo [Www.Etoile.App]&#8221; 由 eXploration Etoile 设置为开放资源。要查看该项，请访问 <a href="https://creativecommons.org/publicdomain/mark/1.0/?ref=openverse.">https://creativecommons.org/publicdomain/mark/1.0/?ref=openverse.</a></figcaption>
                   </figure>
                   <p><span style="color: #0000ff"><a style="color: #0000ff" href="https://www.bing.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.bing.com/">Bing</a> </span>               <a href="https://www.onesearch.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.onesearch.com/">OneSearch</a><br />
                    <a href="https://search.brave.com/" target="_blank" rel="noopener" data-cke-saved-href="https://search.brave.com/">Brave </a>              <a href="https://www.qwant.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.qwant.com/">Qwant </a><br />
                    <a href="https://duckduckgo.com/" target="_blank" rel="noopener" data-cke-saved-href="https://duckduckgo.com/">DuckDuckGo</a>   <a href="https://en.wikipedia.org/wiki/Spotlight_(software)" target="_blank" rel="noopener" data-cke-saved-href="https://en.wikipedia.org/wiki/Spotlight_(software)">Spotlight</a><br />
                    <a href="https://www.ecosia.org/?tt=ba893d82&amp;gclid=Cj0KCQjwkOqZBhDNARIsAACsbfJRLI3qDUK3kcAU2FGQRzlkK4yAi3QQqLR6NKQ8pXG6v0MYOhZFqcAaAlaQEALw_wcB" target="_blank" rel="noopener" data-cke-saved-href="https://www.ecosia.org/?tt=ba893d82&amp;gclid=Cj0KCQjwkOqZBhDNARIsAACsbfJRLI3qDUK3kcAU2FGQRzlkK4yAi3QQqLR6NKQ8pXG6v0MYOhZFqcAaAlaQEALw_wcB">Ecosia</a>              <a href="https://www.startpage.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.startpage.com/">Startpage</a><br />
                    <a href="https://www.google.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.google.com/">Google </a>            <a href="https://swisscows.com/en" target="_blank" rel="noopener" data-cke-saved-href="https://swisscows.com/en">Swisscows</a><br />
                    <a href="https://metager.org/" target="_blank" rel="noopener" data-cke-saved-href="https://metager.org/">MetaGer</a>           <a href="https://search.yahoo.com/" target="_blank" rel="noopener" data-cke-saved-href="https://search.yahoo.com/">Yahoo!</a></p>
                   <ol>
                        <li>搜索结果是否与您经常使用的其他引擎一样好？</li>
                        <li>这个搜索引擎的来源是什么？它是否依赖于其他搜索引擎来获取其结果？</li>
                        <li>阅读“关于我们”和“隐私政策”或“使用条款”页面。</li>
                        <li>根据这些网页推断，您认为搜索引擎公司会如何处理您的数据？您可以更改默认的隐私设置吗？</li>
                   </ol>
                   <p>完成后，请在<a href="https://pressbooks.pub/aiforteachers/chapter/a-brief-description-of-some-search-engines/" target="_blank" rel="noopener">这里</a>查看每个引擎的简要描述。</p>
              </div>
         </div>
         <p class="no-indent">搜索引擎是您口袋里的AI。它是我们大多数人经常使用的最复杂的AI应用。搜索引擎的成功归因于以下几点：</p>
         <ul>
              <li>万维网上内容的爆炸式增长；</li>
              <li>搜索引擎能够对网络上大量的内容进行分类标记，以便后续用户搜索时快速查找（索引化）；</li>
              <li>搜索引擎能够理解人类用户所查询的内容<sup>1</sup>；</li>
              <li>搜索引擎能够首先显示最相关的内容（排序）。</li>
         </ul>
         <p class="no-indent">AI算法提升了搜索引擎后三个能力的水平。</p>
         <p class="indent">搜索引擎——有些人称之为“知识引擎”——成功地创造了一个幻觉，即世界上的一切都在网络上，而网络上的一切都是可搜索的<sup>2</sup>。这种随时可用的知识、认知方式和扩展记忆的方法正在改变学习。</p>
         <h3 style="text-align: left">搜索引擎作为学习和教学工具</h3>
         <p>搜索引擎至少可以在三个方面帮助教师和学习者：</p>
         <ul>
              <li style="text-align: justify">使得在课堂和测验中查找和验证所使用的信息变得容易。过去十年，信息的含义发生了巨大变化。现在，文本、音频、视频、动画甚至代码片段都容易获取。搜索论坛和数字存储库也是如此。</li>
              <li style="text-align: justify">缓解教师作为唯一知识来源的需求。如果教师愿意，他们可以自由地选择帮助学生提升技能，激发探究精神并解决冲突和疑问。</li>
              <li style="text-align: justify">通过开放信息资源，学生能够进行探索性学习和基于项目的学习。学生可以访问、排序并理解信息的含义。这带来了持久的学习，并可以迁移到现实生活情境中<sup>3</sup>。</li>
         </ul>
         <p class="no-indent">然而，探索性学习或任何其他类型的学生主导的学习并不容易。学生在搜索和整合自己的信息来源时需要帮助和脚手架，以便掌握更多技能<sup>3</sup>。</p>
         <h3 style="text-align: left">查询什么以及如何查询<a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/Stumbling Blocks to Personalisation (2).jpg" data-size="medium" data-align="left" data-caption="none" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/Stumbling Blocks to Personalisation (2).jpg"></a></h3>
         <p class="no-indent"><img class="aligncenter wp-image-741" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.1-576x1024.png" alt="" width="295" height="524" data-wp-editing="1" /></p>
         <p>欧洲和其他地区的一些研究表明，学生在高效且高质量的网络搜索方面存在困难<sup>3</sup>。当他们的搜索没有结果时，他们经常感到沮丧，或者不确定哪些结果是真正有用和相关的<sup>4</sup>。幼童在电脑上搜索信息时似乎有四种的困难：创建搜索关键字，从搜索结果列表中选择适当的网页，正确拼写搜索词和理解搜索结果使用的语言<sup>5</sup>。</p>
         <p class="indent">掌握一些搜索技巧将大有帮助，让您和您的学生都能有效利用这一极好的资源。</p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>优化搜索</strong></p>
              </header>
              <div class="textbox__content">
                   <ol>
                        <li>在您选择的搜索引擎中输入“<strong><em>搜索”</em></strong>并查看结果。将它们与“<strong><em>如何搜索”</em></strong>或“<strong><em>搜索技巧”</em></strong>的结果进行比较。现在搜索：人工智能在搜索引擎中的应用是什么？</li>
                        <li>比较搜索<strong><em>烤奶酪食谱</em></strong>和<strong><em>烤奶酪&#8221;食谱&#8221; </em></strong>的结果。如何知道搜索<em><strong>&#8220;东德人&#8221;的故事</strong></em>比<em><strong>东德人的故事</strong></em>更好，仅仅凭借第一页搜索结果？</li>
                        <li><em><strong>吃，祈祷，爱</strong></em>与<strong>吃祈祷爱</strong>搜索结果相同吗？</li>
                        <li>尝试<strong><em>木星附近的行星</em></strong>。找到埃菲尔铁塔附近的一家餐厅。</li>
                        <li><strong><em>人工智能中的&#8221;机器学习&#8221; </em></strong>有什么作用？</li>
                        <li>搜索<strong><em>&#8220;汤姆·克鲁斯&#8221; 和 &#8220;约翰·奥利弗&#8221;</em></strong>与<strong><em>&#8220;汤姆·克鲁斯&#8221; 或 &#8220;约翰·奥利弗&#8221;</em></strong>有什么区别？</li>
                        <li>比较搜素<strong><em>加利福尼亚大学</em></strong>和<strong><em>加利福尼亚*大学 </em></strong>的结果。* 有什么作用？</li>
                        <li>尝试<strong>“courses site bbc.com”</strong>和<em><strong>“courses site:bbc.com”</strong></em>。在所有具有.edu网址(URL)的网站中查找课程。</li>
                        <li>向任何搜索查询后添加<strong><em>filetype:pdf </em></strong>以了解其用途。</li>
                   </ol>
                   <p><a href="https://pressbooks.pub/aiforteachers/chapter/optimising-search/" target="_blank" rel="noopener" data-cke-saved-href="guide--optimising-search">您可以在这里查阅相关指南</a></p>
              </div>
         </div>
         <p><a href="https://www.bilibili.com/video/BV1Lw4m1q7sw/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 在线研究： 有效搜索策略小贴士 (Online Research: Tips for Effective Search Strategies)</a></p>
         <p>除了练习良好的搜索技巧，向下滚动搜索结果并查看第一页后的页面也是有价值的。搜索引擎在如何对结果排序方面有所不同。排在最前的结果可能不仅基于您的搜索查询和用户活动。并非每个人都知道如何编写网页以使其出现在最先显示的结果中。</p>
         <p>在我们结束关于搜索引擎的讨论时，请查看搜索设置。无论您喜欢使用哪种搜索引擎，它们都允许您调整搜索结果的显示方式以及是否设置适合儿童模式等。</p>
         <h3 style="text-align: left">两人一组搜索</h3>
         <p>即使在学习了搜索的优化技巧之后，学生们在构思有效的搜索词和分析搜索结果方面仍可能面临困难。有证据表明，两人或三人一组进行搜索可以帮助解决这一问题。讨论搜索的每一步骤可以帮助学生找到更好的搜索策略，纠正结果并评估如何处理获得的信息。与单独搜索相比，两人一组搜索的学生在定位网站内信息和评估信息的能力上也可能更强<sup>4</sup>。</p>
         <p>* &#8220;理解&#8221;(make sense of)、&#8221;了解&#8221;(understand)、&#8221;智能&#8221;(intelligent)等词语在本文中用于描述机器的行为。重要的是要记住，基于机器的应用程序无法以与人类相同的方式理解或了解某事。</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Russell, D., <em>What Do You Need to Know to Use a Search Engine? Why We Still Need to Teach Research Skills</em>, AI Magazine, 36(4), 2015</p>
         <p class="hanging-indent"><sup>2 </sup>Hillis, K., Petit, M., Jarrett, K., <em>Google and the culture of search</em>, Routledge, 2013.</p>
         <p class="hanging-indent"><sup>3 </sup>Marion Walton, M., Archer, A., <em>The Web and information literacy: scaffolding the use of web sources in a project-based curriculum, </em>British Journal of Educational Technology, Vol 35 No 2, 2004.</p>
         <p class="hanging-indent"><sup>4 </sup>Lazonder, A.,<em> Do two heads search better than one? Effects of student collaboration on web search behaviour and search outcomes</em>, British Journal of Educational Technology, Vol 36 Issue 3, 2005.</p>
         <p class="hanging-indent"><sup>5 </sup>Vanderschantz, N., Hinze, A., Cunningham, S., “<em>Sometimes the internet reads the question wrong”: Children’s search strategies &amp; difficulties</em>, Proceedings of the American Society for Information Science and Technology, Vol 51, Issue 1, 2014.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-search-engines-part-2" title="搜索引擎 第2部分">
         <header>
              <h1 class="chapter-title">搜索引擎 第2部分</h1>
              <p data-type="subtitle" class="chapter-number">9</p>
         </header>
         <h3 style="text-align: left">真实性与相关性</h3>
         <p>我们被教导要对书籍充满信心。出版商、图书管理员、教授和学科专家充当着纸质印刷物守门人的角色，他们确保了印刷物的内容是真实的、质量良好的。然而，网络 上的信息却良莠不齐，如何确保学生能够在网络上找到有价值的信息来源呢<sup>1,2</sup>？<br />
          <img class="alignright wp-image-750" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.2-2-576x1024.png" alt="" width="347" height="617" />即使是看似权威的印刷物也被证明存在错误和偏见。如果我们能够培养批判性评价的习惯或文化，那么我们能够得到的好处将远远超过仅仅学会如何选择优质的在线资源<sup>2</sup>。</p>
         <h3 style="text-align: left">数字资料库<a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/8529618244_e7c7046413_o.png" data-size="medium" data-align="right" data-caption="description" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/8529618244_e7c7046413_o.png"></a></h3>
         <figure id="attachment_51" aria-describedby="caption-attachment-51" style="width: 300px" class="wp-caption alignleft">
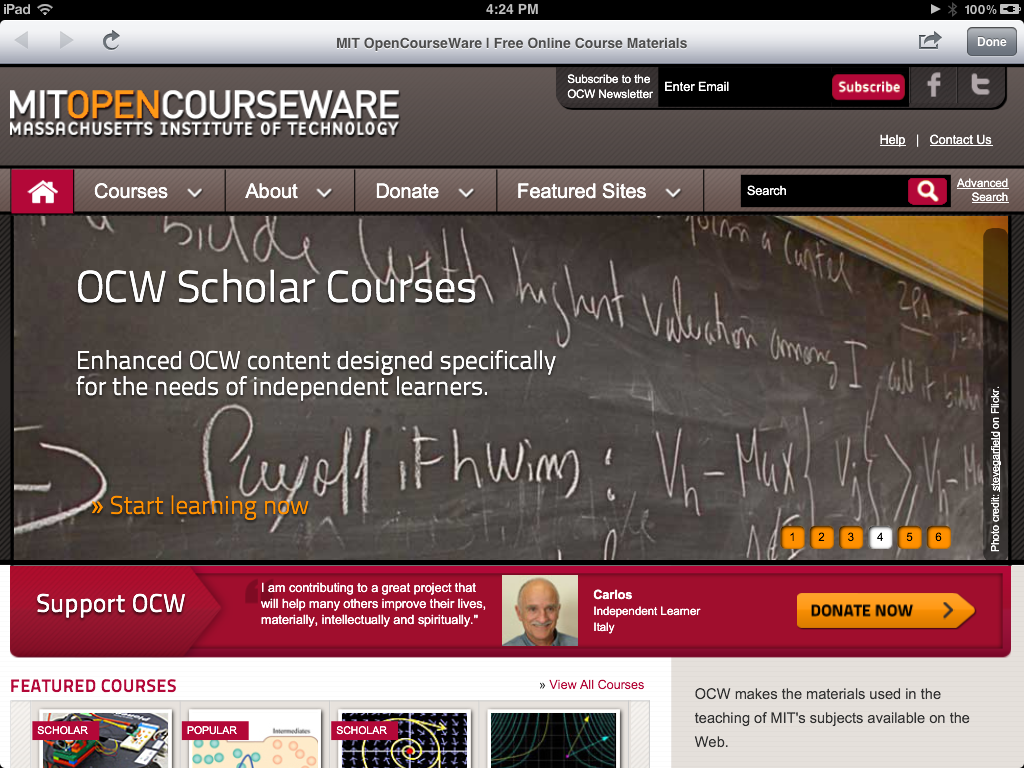
              <img class="size-medium wp-image-51" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-300x225.png" alt="" width="300" height="225" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware-350x263.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page2-MIT-opencourseware.png 1024w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption id="caption-attachment-51" class="wp-caption-text">“MIT 开放课程” 由 stevegarfield 授权 CC BY-NC-SA 2.0。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.</a></figcaption>
         </figure>
         <p><a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/8529618244_e7c7046413_o.png" data-size="medium" data-align="right" data-caption="description" data-annotations="" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/8529618244_e7c7046413_o.png"></a>确保内容真实可靠的<span style="font-size: 1em">一个</span>有效途径是使用已知且<span style="font-size: 1em">可信</span><span style="text-align: initial;font-size: 1em">的来源。这些资源范围广泛，既有学校级别的，也有全球性的。在过去的二十年里，数字图书馆的数量显著增加，教育者能够访问和使用数据集、地图和图像等文件</span><sup style="text-align: initial">3</sup><span style="text-align: initial;font-size: 1em">。</span></p>
         <p class="indent">要查找信息，你可以选择直接在相应网站内部进行搜索，或者在搜索引擎中使用“site: 关键字”的方式搜索。</p>
         <p class="indent">谷歌也有专门用于<a href="https://www.google.com/publicdata/directory" target="_blank" rel="noopener" data-cke-saved-href="https://www.google.com/publicdata/directory">公共数据集</a>的搜索引擎，政府、公共机构和大型公司将其收集的数据提供给公众。这些都是从研究、调查和人口普查中收集的公共信息<sup>4</sup>。<br />
          也有搜索引擎用于 <a href="https://scholar.google.com/" target="_blank" rel="noopener" data-cke-saved-href="https://scholar.google.com/">研究数据库</a>，这里收录了数以百万计的论文和书籍，无论是免费的还是付费的，都已经按照一定规则整理归类并建立索引，用户随时可以通过关键词进行搜索。</p>
         <p class="no-indent">来自大学的开放课程、<a href="https://www.khanacademy.org/" target="_blank" rel="noopener" data-cke-saved-href="https://www.khanacademy.org/">可汗学院</a>和在线百科全书都是常见的信息来源。</p>
         <h3 style="text-align: left">易变的内容</h3>
         <div class="textbox textbox--sidebar textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title">发现！</p>
              </header>
              <div class="textbox__content">
                   <p>点击<span style="font-size: 1em"> </span><a style="font-size: 1em" href="https://pressbooks.pub/aiforteachers/chapter/x5gon/" target="_blank" rel="noopener">这里</a><span style="text-align: initial;font-size: 1em">阅读关于在网上搜索开放教育资源的信息</span></p>
              </div>
         </div>
         <p>搜索引擎总是在试测验新的算法。与传统的电脑搜索不同，移动设备搜索更加重视与用户当前所处位置相关的搜索结果<sup>4</sup>。</p>
         <p>我们每天都会看到新的内容被加入到搜索引擎的索引中，而旧内容则以不同的方式被处理。通过重新分析，旧数据可以转化为新数据<sup>1</sup>。版权和许可证也在不断变化。数据相关的法律也会随着时间和地点的不同而有所不同。例如，在欧盟地区，由于通用数据保护条例(GDPR)的存在，即使某些内容已被移出搜索引擎的索引，仍然会被列出来。地图会根据访问地点的不同而发生变化。语言及其应用在持续变化。不同国家对医疗分类的使用和解释也各不相同<sup>1</sup>。</p>
         <p class="indent">不要忘记，搜索结果的排序是根据用户的活动历史、个人信息和隐私设置来决定的。这意味着我们每个人看到的内容都是不一样的，甚至可能无法两次找到相同的内容。在制定和评估教育活动时，这些差异都是必须考虑的因素。</p>
         <h3 style="text-align: left">其他挑战</h3>
         <p class="no-indent">搜索引擎也带来了其他变化。知识变得唾手可得，我们没必要非得知道事实。相反，我们更关注如何快速找到所需信息<sup>1</sup>。程序员们习惯于复制粘贴代码片段，工程师们则依赖模拟器。论坛成了学生提问作业和<span style="font-size: 1em">抱怨</span><span style="text-align: initial;font-size: 1em">老师的聚集地。在这个时代，技能的重要性逐渐超越了知识和记忆。甚至我们的伦理道德观念也在发生变化——面对“复制粘贴”的一代，我们该如何解释抄袭行为呢？</span></p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Russell, D., <em>What Do You Need to Know to Use a Search Engine? Why We Still Need to Teach Research Skills</em>, AI Magazine, 36(4), 2015.</p>
         <p class="hanging-indent"><sup>2 </sup>Marion Walton, M., Archer, A., <em>The Web and information literacy: scaffolding the use of web sources in a project-based curriculum, </em>British Journal of Educational Technology, Vol 35 No 2, 2004.</p>
         <p class="hanging-indent"><sup>3 </sup>Land, S., Hannafin, M. J., &amp; Oliver, K. <em>Student-Centered Learning Environments: Foundations, Assumptions and Design</em>. In Jonassen, D. H. &amp; Land, S. (Ed.), Theoretical foundations of learning environments (pp. 3–26), Routledge, 2012.</p>
         <p class="hanging-indent"><sup>4 </sup>Spencer, Stephan. <em>Google Power Search: The Essential Guide to Finding Anything Online With Google, </em>Koshkonong. Kindle Edition.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-machine-learning" title="AI 说(AI Speak)：机器学习">
         <header>
              <h1 class="chapter-title">AI 说(AI Speak)：机器学习</h1>
              <p data-type="subtitle" class="chapter-number">10</p>
         </header>
         <p class="no-indent"><strong>算法</strong>是一系列固定的指令，用于执行特定任务。它将任务分解成简单、无歧义的步骤，就像一份写得很好的食谱。</p>
         <p class="indent">编程语言是计算机可以遵循和执行的指令集。它们充当了人类和机器互相理解的桥梁。最终，所有的数据和信息都被转化为二进制的形式，类似于开关的“开”和“关”状态。对于计算机来说，图像、视频、指令都是1（开关打开）和0（开关关闭）。</p>
         <p class="indent">在编程语言中，算法变成了<strong>程序</strong>。<strong>应用程序</strong>是为最终用户编写的程序。</p>
         <p class="indent">传统程序接收数据并按照指令输出结果。许多早期的AI程序都是传统的。由于指令不能适应数据，这些程序在预测不完整信息和自然语言处理（NLP）等方面表现不佳。</p>
         <p class="indent"><a class="inline wrap" href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/Green%20Illustrated%20Modern%20Social%20Media%20Marketing%20Report%20Presentation%20(1).jpg" data-align="left" data-annotations="" data-size="medium" data-caption="none" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/media/Green%20Illustrated%20Modern%20Social%20Media%20Marketing%20Report%20Presentation%20(1).jpg"><img class="wp-image-753 alignleft" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-9.1.jpg" alt="" width="460" height="259" /> </a>搜索引擎既依赖于传统算法，也依赖于<strong>机器学习<span style="font-size: 1em">(Machine learning, ML)</span>算法</strong>。与传统程序不同，机器学习<span style="text-align: initial;text-indent: 2em;font-size: 1em">算法分析数据以寻找模式，并使用这些模式或规则来做出未来决策或预测。因此，基于数据和好坏事例，算法通过不断试验和调整，它们会形成自己独特的“食谱”</span><span style="text-align: initial;text-indent: 2em;font-size: 1em">。</span></p>
         <p class="indent">这些算法非常适合处理复杂和缺失数据的情况。它们还可以监控自己的性能，并利用这些反馈来变得更好。</p>
         <p class="indent">这与人类的情况并没有太大不同，尤其是当我们看到婴儿在传统教育体系之外学习技能时。婴儿观察、重复、学习、测试自己的学习成果并改进。在必要时，他们会即兴发挥。</p>
         <p class="indent">但是，机器与人类的相似性只是表面的。<span style="font-size: 1em">人类的</span><span style="text-align: initial;text-indent: 2em;font-size: 1em">“学习”与机器的学习有着天壤之别，人类的“学习”更加微妙和复杂。</span></p>
         <p><a href="https://www.bilibili.com/video/BV1ar421A7qD/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 机器学习 (Machine Learning)</a></p>
         <h3 style="text-align: left">分类问题</h3>
         <figure id="attachment_917" aria-describedby="caption-attachment-917" style="width: 430px" class="wp-caption alignright">
              <img class="wp-image-917" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935.png" alt="" width="430" height="242" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935.png 1054w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-300x169.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-1024x576.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-768x432.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-65x37.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-225x127.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/1-1-e1718939166935-350x197.png 350w" sizes="(max-width: 430px) 100vw, 430px" />
              <figcaption id="caption-attachment-917" class="wp-caption-text">“玩牌”由aquarianinsight.com/free-readings/提供，采用CC BY-SA 2.0许可。要查看此项，请访问<a href="https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">机器学习应用的一个常见任务是分类。比如，判断一张图片是狗还是猫，或者预测一个学生会不会通过考试。这些任务中通常存在两个或更多的组，机器学习应用需要将新的数据归类到其中一个组中。</p>
         <p class="indent">我们以扑克牌为例，假设有两组牌——组A和组B——它们按照某种规律分成两堆。现在，我们要将一张新的牌——方块A——归类到组A或组B中。</p>
         <p class="indent">为了完成这个任务，我们首先需要了解这两组牌是如何划分的，这就需要一些示例牌。我们从组A中抽四张牌，从组B中也抽四张牌。这八张牌就是我们的<strong>训练集</strong>，它们可以帮助我们找到分类的规律，就像“训练”我们的大脑一样。</p>
         <p class="indent">当我们看到右侧图展示的排列后，大多数人都能猜出方块A应该属于组B。这是因为人类大脑非常擅长发现模式。那么，机器是如何做到这一点的呢？</p>
         <p class="indent">机器学习算法建立在强大的统计理论基础之上。不同的算法基于不同的数学方程，这些方程需要仔细选择，以便适应特定的任务。程序员的工作是选择数据，分析数据的哪些特征与特定问题相关，并选择正确的机器学习算法。</p>
         <h3 style="text-align: left">数据的重要性</h3>
         <figure id="attachment_56" aria-describedby="caption-attachment-56" style="width: 442px" class="wp-caption alignright">
              <img class="wp-image-55" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-300x169.jpg" alt="" width="442" height="249" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-300x169.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-1024x576.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-768x432.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-1536x864.jpg 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-65x37.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-225x127.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2-350x197.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-3-card2.jpg 1920w" sizes="(max-width: 442px) 100vw, 442px" />
              <figcaption id="caption-attachment-56" class="wp-caption-text">“玩牌”由aquarianinsight.com/free-readings/提供，采用CC BY-SA 2.0许可。要查看此许可证的副本，请访问<a href="https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse.">https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse.</a></figcaption>
         </figure>
         <p class="no-indent">上面的抽牌可能会以多种方式出错。请参考右图。1组的牌太少，无法做出猜测。2组有更多的牌，但都是同一花色——无法知道方块应该放在哪里。如果各组的大小不同，3组可能意味着数字牌在A组，而图片牌在B组。</p>
         <p class="indent">一般来说，机器学习问题更为复杂，所涉及的数据集规模远大于一副牌。在选择训练集时，我们需要借助统计分析来确保数据的有效性和准确性，否则可能会导致错误。对于机器学习应用来说，良好的数据选择至关重要，其重要性甚至超过了其他类型的程序。机器学习需要大量的相关数据来支持其训练和预测。在最基本的情况下，机器学习模型所包含的数据点数量应该是特征总数的十倍<sup>1</sup>。也就是说，机器学习也擅长处理复杂、混乱甚至矛盾的数据。</p>
         <h3 style="text-align: left">特征提取</h3>
         <p class="no-indent">当我们看到上面A组和B组的牌时，可能首先会注意到牌的颜色。然后，我们会关注牌上的数字或字母以及花色。但是，对于算法来说，它并不知道哪些特征是重要的，所以我们必须明确地告诉它这些特征。</p>
         <p><img class="aligncenter wp-image-759" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.4-2-e1717585659928.png" alt="" width="450" height="377" /></p>
         <p class="no-indent">在选择特征时，程序员会面临很多问题。如“特征太少无法发挥作用？”“特征多大的数量是太多呢？”“哪些特征是与任务相关的？”“这些特征之间是否有关联，比如一个特征是否依赖于另一个特征？”“使用这些特征，算法能否给出准确的输出？”这些都是程序员在特征提取时需要仔细考虑的问题。</p>
         <p><a href="https://www.bilibili.com/video/BV13f421R7xW/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 特征的作用是什么？(What is the role of features?)</a></p>
         <h3 style="text-align: left">过程</h3>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <h4><strong>数据必须被预先分类吗？</strong></h4>
              </header>
              <div class="textbox__content" style="text-align: center">
                   阅读<a href="https://pressbooks.pub/aiforteachers/chapter/does-data-always-have-to-be-labeled/" target="_blank" rel="noopener">这里</a>
              </div>
         </div>
         <p class="no-indent">程序员在开发应用程序时，会先收集数据，从中提取出关键特征，然后选用合适的机器学习算法（一种定义处理过程的数学函数），并用已标注数据（比如已知是A组还是B组的数据）进行训练，让机器“理解<span style="font-size: 1em">”</span><span style="text-align: initial;font-size: 1em">问题背后的规律。</span></p>
         <p class="indent">在机器眼中，“<span style="font-size: 1em">理解</span><span style="text-align: initial;text-indent: 2em;font-size: 1em">”问题其实就是给每个特征分配一组数字（权重）。通过给特征分配正确的权重，机器就能算出新卡属于A组还是B组的概率。在训练过程中，程序员会手动调整一些数值来帮助机器更好地学习。这个过程叫做<strong>调整（tuning）</strong>应用程序。</span></p>
         <p class="indent">训练完成后，程序还需要经过测试才能投入使用。这时，我们会把之前没用过的标注数据输入程序进行测试。这些用于测试的数据就叫<strong>测试数据</strong>。接着，我们会评估机器预测输出的表现。如果表现让人满意，程序就可以正式投入使用了——它现在已经能够接收新数据，并基于这些数据做出决策或预测。</p>
         <p class="no-indent"><img class="aligncenter wp-image-762" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1717586260426.png" alt="" width="466" height="222" />模型在训练和测试数据集上发挥的功能是否不同？特征的数量如何影响两者的性能？<a href="https://www.bilibili.com/video/BV1b1421y7aQ/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f" target="_blank" rel="noopener">点击观看此视频了解。</a></p>
         <p class="indent">实时性能将持续受到监控和并得到改进（即调整特征权重，使输出结果更精确）。在实际使用中，实时性能往往与用已有数据测试机器学习时的结果不同。由于用真实用户做实验成本高昂，工作量大且风险高，所以算法总是先用历史用户数据进行测试，但这样可能无法准确评估算法对用户行为的影响<sup>1</sup>。这就是为什么一旦投入使用，对机器学习应用进行全面评估就显得至关重要：</p>
         <p><a href="https://www.bilibili.com/video/BV1Sw4m1i7Vi/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">【[AI4T] 评估 (Evaluating)】 </a></p>
         <p>&nbsp;</p>
         <p class="indent no-indent">想要亲手尝试一些机器学习吗？<a href="hands-on-machine-learning" target="_blank" rel="noopener" data-cke-saved-href="hands-on-machine-learning">尝试这个活动吧。</a></p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Theobald, O. <em>Machine Learning For Absolute Beginners: A Plain English Introduction</em> (Second Edition) (Machine Learning From Scratch Book 1) (p. 24). Scatterplot Press. Kindle Edition.</p>
         <p class="hanging-indent"><sup>2 </sup>Konstan, J., Terveen, L., <em>Human-centered recommender systems: Origins, advances, challenges, and opportunities</em>, AI Magazine, 42(3), 31-42, 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-search-engine-indexing" title="AI说(AI Speak)：搜索引擎检索">
         <header>
              <h1 class="chapter-title">AI说(AI Speak)：搜索引擎检索</h1>
              <p data-type="subtitle" class="chapter-number">11</p>
         </header>
         <p class="no-indent">搜索引擎会将用户在搜索框中输入的关键词（搜索查询）作为指引，尝试寻找与这些关键词相关的网络文档，作为对查询的回应。然后，它会以一种易于理解的方式展示这些信息，将最符合需求的页面放在最前面。为了完成这项任务，搜索引擎首先需要在网络上找到相关的文档，并给它们打上标签，方便后续快速检索。接下来，让我们来大致了解一下这个过程是如何运作的：</p>
         <h3 style="text-align: left">步骤 1：网络爬虫搜集并下载文档</h3>
         <figure id="attachment_65" aria-describedby="caption-attachment-65" style="width: 403px" class="wp-caption alignleft">
              <img class="wp-image-59" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-300x213.png" alt="" width="403" height="286" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-300x213.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-1024x726.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-768x545.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-1536x1090.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-225x160.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling-350x248.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-web-crawling.png 1748w" sizes="(max-width: 403px) 100vw, 403px" />
              <figcaption id="caption-attachment-65" class="wp-caption-text">灵感来源于Seobility的“搜索引擎爬虫”，由CC BY-SA 4.0许可。要查看此项的副本，请访问 <a href="https://www.seobility.net/en/wiki/Creative_Commons_License_BY-SA_4.0">https://www.seobility.net/en/wiki/Creative_Commons_License_BY-SA_4.0</a></figcaption>
         </figure>
         <p class="no-indent">在用户进行搜索之前，互联网上的所有内容已经由网络爬虫提前“侦察”过了<sup>1</sup>。爬虫会先查看网络文档，并将文档内容拆分成不同部分存储。一旦用户输入查询，搜索引擎就会将查询与存储的文档内容进行匹配。</p>
         <p class="indent">网络爬虫实际上是一段程序代码，专门负责在网络上搜集和下载文档。它们会从一系列网站地址（URL）开始，深入其中寻找新网页的链接。接着，它们会下载这些新页面，并进一步查找更多的链接。只要初始的网站列表足够丰富多样，这些爬虫最终会访问到每一个允许访问的网站，并且为了查找最新内容，还会多次回访。</p>
         <h3 style="text-align: left">步骤 2：拆分文档</h3>
         <p class="no-indent"><img class="alignright wp-image-764" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.6-e1717586854376.png" alt="" width="405" height="287" /></p>
         <p>爬虫下载的文档可能是结构清晰、信息完备的网页，包含内容、作者、日期等描述。它也可能是一张模糊不清的旧图书馆书籍的扫描图。但无论哪种格式，搜索引擎在通常情况下都能读取<sup>1</sup>。它们会把这些文档转换成html或xml格式，并存储在数据库中（Google称为BigTable）。</p>
         <p class="indent">一个数据库是由很多小的分区构成的。在分区中，每一行用于专门记录一个网页的信息。这些行是按照一定顺序排列的，并且会记录更新日志。每列都包含了与网页相关的特定信息，这些信息有助于将文档内容与未来用户的查询进行匹配。这些列具体包含以下内容：</p>
         <ul>
              <li style="list-style-type: none">
              <ul>
                   <li>网站地址。这个地址是主页或者侧边页，并且包含有代表性的内容，那么它本身就能很好地描述页面的内容；</li>
                   <li>标题、小标题和粗体文字。这些都能描述页面的重要内容；</li>
                   <li>页面的元数据。这是关于页面的信息，不是主要内容的一部分，例如文档类型（例如电子邮件或网页）、文档结构和特征，如文档长度、关键词、作者姓名和发布日期；</li>
                   <li>从其他页面到此页面的链接的描述，提供有关页面内容不同方面的简洁文本。链接越多，描述越多，使用的列越多。链接的存在也用于排名，以确定网页的受欢迎程度。（看看<a href="https://en.wikipedia.org/wiki/PageRank" target="_blank" rel="noopener" data-cke-saved-href="https://en.wikipedia.org/wiki/PageRank">谷歌的PageRank</a>，一个使用链接到页面和来自页面的链接来衡量质量和受欢迎程度的排名系统）。</li>
              </ul>
               </li>
         </ul>
         <ul>
              <li>人名、公司或组织名称、地点、地址、时间和日期、数量和货币值等。可以使用机器学习算法，通过人工注释的训练数据，在任何内容中找到这些实体<sup>1</sup>。</li>
         </ul>
         <figure aria-describedby="caption-attachment-65" style="width: 297px" class="wp-caption alignleft">
              <img class="size-medium wp-image-61" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage-297x300.jpg" alt="" width="297" height="300" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage-297x300.jpg 297w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage-65x66.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage-225x227.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage-350x354.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-webpage.jpg 553w" sizes="(max-width: 297px) 100vw, 297px" />
              <figcaption class="wp-caption-text">页面的主要内容往往隐藏在其他信息中。&#8221;theguardian&#8221; 由 Il Fatto Quotidiano 提供，根据 CC BY-NC-SA 2.0 许可。要查看此许可的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.</a></figcaption>
         </figure>
         <p class="no-indent">在表格中，有一个非常关键的列，专门用于存储文档的主要内容。然而，这些内容常常隐藏在众多的外部链接和广告之中，需要仔细识别。为此，一种技术应运而生，即利用机器学习模型来“学习”如何识别网页中的主要内容。</p>
         <p class="indent">当然，我们也可以尝试将查询中的关键词与网页文档中的内容进行匹配，就像我们在文字处理器中使用“查找”功能一样。但是，这种方法的效果并不理想，因为人们常常会用不同的词汇来描述同一个事物。仅仅记录单个的词汇，并不能帮助我们理解这些词汇是如何组合在一起形成意义的。实际上，是词汇背后的思想在帮助我们进行交流，而不是词汇本身。因此，所有搜索引擎都会以特定的方式对文本进行转换，以便更好地与查询的含义相匹配。随后，查询本身也会进行类似的处理。<br />
          <img class="aligncenter wp-image-766" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.7-e1717587360940.png" alt="" width="388" height="690" />作为单词的组成部分，词元（Token）使得需要存储的数量得以减少。目前的模型大约存储了30,000到50,000个词元<sup>2</sup>。即使单词拼写错误，只要其部分与存储的词元匹配，仍然可以被识别出来。同样，一些未知单词也可能出现在搜索结果中，因为它们的局部可能与存储的词元相匹配。</p>
         <p class="indent">在机器学习的训练过程中，我们使用包含示例文本的训练集。模型从单个字符、空格和标点符号开始，将频繁出现的字符合并成新的词元。如果词元的数量不够多，模型会继续运行合并程序，以覆盖更大范围或不太常见的单词部分。这样，大多数单词、单词后缀和前缀都可以被覆盖。因此，当我们有一个新文本需要处理时，机器可以很容易地将其拆分为词元，并存储起来。</p>
         <p><img class="aligncenter wp-image-768" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.8-e1717587596777.png" alt="" width="495" height="330" /></p>
         <h3 style="text-align: left">步骤 3：建立索引以便查阅</h3>
         <figure aria-describedby="caption-attachment-65" style="width: 352px" class="wp-caption alignright">
              <img class="wp-image-177" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch2-page-4-index-scaled-1.jpg" alt="" width="352" height="264" />
              <figcaption class="wp-caption-text">“索引”由Ben Weiner提供，根据CC BY-ND 2.0许可。要查看此许可的副本，请访问 <a href="https://creativecommons.org/licenses/by-nd/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nd/2.0/?ref=openverse</a>.</figcaption>
         </figure>
         <p class="no-indent">一旦数据被存放在大表（BigTables）中，就会创建一个索引。类似于教科书索引的想法，搜索索引列出了词元（tokens）及其在网页文档中的位置。统计数据显示一个词元在文档中出现了多少次以及它对文档的重要性等等，信息的位置也是如此——词元是否在标题或小标题中，它是否集中在文档的某个部分，一个词元是否总是跟随另一个？</p>
         <p class="indent">如今，许多搜索引擎使用由深度神经网络生成的基于语言的模型。后者编码了文本的语义细节，负责更好地理解查询<sup>3</sup>。神经网络帮助搜索引擎超越查询，以捕获最初引发查询的信息需求。</p>
         <p class="no-indent" style="text-align: left">这三个步骤简化了所谓的“索引”过程 &#8211; 查找、准备和存储文档以及创建索引。接下来涉及的“排名”步骤 &#8211; 将查询与内容匹配并根据相关性显示结果。</p>
         <p><img class="aligncenter wp-image-769" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.9-e1717587950583.png" alt="" width="453" height="321" /></p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Croft, B., Metzler D., Strohman, T.,<em> Search Engines, Information Retrieval in Practice</em>, 2015</p>
         <p class="hanging-indent"><sup>2 </sup>Sennrich,R., Haddow, B., and Birch, A., <em>Neural Machine Translation of Rare Words with Subword Units,</em> In Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 1715–1725, Berlin, Germany. Association for Computational Linguistics, 2016.</p>
         <p class="hanging-indent"><sup>3</sup> Metzler, D., Tay, Y., Bahri, D., Najork, M., <em>Rethinking Search: Making Domain Experts out of Dilettantes</em>, SIGIR Forum 55, 1, Article 13, June 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-search-engine-ranking" title="AI说(AI Speak)：搜索引擎排序">
         <header>
              <h1 class="chapter-title">AI说(AI Speak)：搜索引擎排序</h1>
              <p data-type="subtitle" class="chapter-number">12</p>
         </header>
         <p class="no-indent">与21世纪初期的搜索引擎相比，现在的搜索引擎分析得更深入、更全面。它们不仅能统计单词数量，还能分析和比较单词背后的含义<sup>1</sup>。这种深度的分析主要体现在排序过程中：</p>
         <p><img class="aligncenter wp-image-787" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.10.png" alt="" width="468" height="332" /></p>
         <h3 style="text-align: left">第4步：查询词与索引词匹配</h3>
         <figure id="attachment_919" aria-describedby="caption-attachment-919" style="width: 429px" class="wp-caption alignleft">
              <img class="wp-image-919" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110.png" alt="" width="429" height="286" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110.png 1064w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-300x200.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-1024x682.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-768x512.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-65x43.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-225x150.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2-e1718939409110-350x233.png 350w" sizes="(max-width: 429px) 100vw, 429px" />
              <figcaption id="caption-attachment-919" class="wp-caption-text">来源：<a href="https://ai.googleblog.com/2021/12/a-fast-wordpiece-tokenization-system.html">https://ai.googleblog.com/2021/12/a-fast-wordpiece-tokenization-system.html</a>，快速WordPiece分词系统，由Xinying Song和Denny Zhou以及“GranniesKitchen的复古迪士尼玛丽·波平斯盘子”获得Sun Valley Melmac许可，根据CC BY 2.0许可。要查看此许可证的副本，请访问<a href="https://creativecommons.org/licenses/by/2.0/">https://creativecommons.org/licenses/by/2.0/</a>?</figcaption>
         </figure>
         <p class="no-indent">当用户在搜索框输入查询并点击搜索时，搜索引擎会开始处理这个查询。它会像处理文档文本一样，把查询中的词语分解成词元。为了让搜索更准确，查询可能还会被扩展，添加一些其他关键词。这是为了避免因为查询使用的词汇与网络内容作者的用词略有差异而错过相关文档。同时，这样的处理也能捕捉到不同文化和习惯用语之间的差异。例如，根据国家的不同，总统、首相和总理等词语的使用可能可以互换<sup>1</sup>。</p>
         <p class="indent">大多数搜索引擎都会追踪用户的搜索记录（想了解更多？可以查看<a href="a-brief-description-of-some-search-engines" target="_blank" rel="noopener" data-cke-saved-href="a-brief-description-of-some-search-engines">常见搜索引擎的介绍</a>）。查询记录与用户数据一起存储，以便个性化内容并提供广告。或者，将所有用户的记录汇总起来，以查看如何以及在哪里提升搜索引擎的性能。</p>
         <p class="indent">用户日志中会记录一些信息，包含诸如过去的查询、结果页面和哪些是有效的信息。例如，用户点击了什么链接？他们花了多少时间浏览网页？有了用户日志，每个查询都可以与相关文档（用户点击、阅读并关闭网页）和非相关文档（用户未点击、未阅读或尝试重新表述查询）匹配<sup>2</sup>。</p>
         <p class="indent">通过用户日志，搜索引擎还可以将新的查询与过去相似的查询进行匹配。判断两个查询是否相似的一种方法，是看它们是否能检索出相同的文档。有时候，两个查询的用词可能并不完全一样，但它们的搜索结果可能是相同的<sup>2</sup>。</p>
         <p class="indent">为了扩展查询，搜索引擎还会考虑拼写因素。具体来说，它会查看过去相关文档中频繁出现的其他单词。一般而言，只有当某个单词在相关文档中的出现频率高于非相关文档时，它才会被加入到查询中，或者给予更高的权重<sup>2</sup>。</p>
         <h3 style="text-align: left">第5步：对文档进行相关性排序</h3>
         <p class="no-indent">在这一步，搜索引擎会对每个文档进行评分，并根据这个评分来排序。评分时，搜索引擎会考虑文档与查询在主题上的匹配度，即主题相关性，还会考虑文档与用户个人偏好的匹配度，即用户相关性。部分文档评分可以在索引时完成。搜索引擎的速度很大程度取决于索引的质量。而搜索结果的有效性，则取决于查询与文档的匹配程度，以及排名系统的优劣<sup>2</sup>。</p>
         <p class="indent"><img class="alignleft wp-image-789" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.11-e1717730772225.png" alt="" width="369" height="656" />为了衡量用户相关性，搜索引擎会根据用户之前的搜索记录、访问的网站、电子邮件内容、使用的设备、语言以及地理位置等信息，创建用户模型（或个性类型）。同时，搜索引擎还会使用<a href="https://pressbooks.pub/aiforteachers/chapter/cookies-and-fingerprinting/" target="_blank" rel="noopener" data-cke-saved-href="http-cookies">Cookies</a>来存储用户的偏好设置。有些搜索引擎甚至会从第三方购买用户信息来丰富其用户模型（您可以参考<a href="a-brief-description-of-some-search-engines" data-cke-saved-href="a-brief-description-of-some-search-engines">一些搜索引擎的描述</a>）。比如，如果一个用户对足球很感兴趣，那么他搜索“曼彻斯特”时得到的结果，就会与那些刚刚预订飞往伦敦的航班的用户有所不同。与个人兴趣相关的文档中频繁出现的词语，会得到更高的权重。</p>
         <p class="indent">商业网络搜索引擎在排名算法中融入了数百种特征，其中很多特征都来源于查询日志中大量的用户交互数据。排序函数会综合考虑文档、查询和用户相关性等特征来给出最终的评分。这些排序函数都基于可靠的数学原理。最终输出的结果，其实就是文档满足用户信息需求的概率。当这个概率超过某个阈值时，该文档就会被认为是与用户查询相关的文档<sup>2</sup>。</p>
         <p class="indent">此外，机器学习技术也被用于分析日志中的隐性用户反馈（即在以前的查询中什么有效）从而优化排序算法。通过机器学习，搜索引擎还可以构建复杂的人类语言使用模型，用于更准确地解析用户的查询意图<sup>1,2</sup>。</p>
         <p class="no-indent" style="text-align: left"><img class="aligncenter wp-image-791" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.12-e1717731056484.png" alt="" width="423" height="355" />过去十年间，网络搜索技术取得了惊人的进步。尽管搜索引擎已经越来越擅长解读用户意图和提供相关结果，然而就理解特定查询的上下文而言，用户自身的参与和反馈仍然是提升搜索效果的关键。用户审查搜索结果，重新调整查询关键词，从而引导搜索引擎提供更精准的信息<sup>2</sup>。</p>
         <h3 style="text-align: left">第6步：显示结果</h3>
         <figure id="attachment_71" aria-describedby="caption-attachment-71" style="width: 477px" class="wp-caption alignleft">
              <img class="wp-image-71" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-300x240.png" alt="" width="477" height="381" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-300x240.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-1024x819.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-768x614.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-65x52.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-225x180.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results-350x280.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/che-page-5-search-results.png 1280w" sizes="(max-width: 477px) 100vw, 477px" />
              <figcaption id="caption-attachment-71" class="wp-caption-text">“Gumshoe DuckDuckGo结果”由jrbrusseau授权，根据CC BY-SA 2.0许可。要查看此许可证的副本，请访问<a href="https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p>搜索结果已准备就绪。你会看到每个页面的标题、URL以及用粗体标记的查询词。每个链接后面，都会有一个简短的摘要，帮你快速了解文档的重点内容。</p>
         <p class="indent">这些摘要里的句子，通常是从标题、元数据描述或和查询最相关的文本中选取的。如果标题中已经包含了所有的查询词，那么这些词在摘要里就不会重复出现<sup>2</sup>。同时，摘要还会考虑句子的可读性，让你读起来更轻松。</p>
         <p class="indent">在搜索结果中，你可能会看到一些广告。搜索引擎公司通过展示广告来赚钱。有些搜索引擎会明确标注这些广告是赞助内容，但有些则不会。由于很多用户通常只看前几个搜索结果，所以广告的存在确实会影响我们的搜索体验。</p>
         <p class="indent">搜索引擎公司在选择展示哪些广告时，会考虑查询的上下文以及用户模型。它们会维护一个广告数据库，当你进行搜索时，它们会从这个数据库中找出与你的查询最相关的广告。广告主会对自己产品的关键词进行竞价，而投标金额和受欢迎程度都是决定广告是否会被展示的重要因素<sup>2</sup>。</p>
         <p class="indent">当我们搜索事实类问题时，有些搜索引擎会利用它们自己收集的大量事实来回答。比如说，谷歌的知识库就包含了超过十亿个从不同来源整理出来的事实<sup>3</sup>。搜索结果通过机器学习算法将结果归类到不同的组别中。最后，用户还会被提供查询的替代选项，以查看潜在的更好回答。</p>
         <h3 style="text-align: left">一些参考资料</h3>
         <p class="no-indent">谷歌的起源可以追溯到<a href="http://infolab.stanford.edu/pub/papers/google.pdf" target="_blank" rel="noopener" data-cke-saved-href="http://infolab.stanford.edu/pub/papers/google.pdf">Brin和Page的原始论文</a>。网页排名（Pagerank）背后的一些数学原理可以在<a href="https://en.wikipedia.org/wiki/PageRank" target="_blank" rel="noopener" data-cke-saved-href="https://en.wikipedia.org/wiki/PageRank">维基的网页排名</a>上找到。对于数学爱好者，这里有一个关于网页排名（<a href="https://towardsdatascience.com/pagerank-algorithm-fully-explained-dc794184b4af" target="_blank" rel="noopener" data-cke-saved-href="https://towardsdatascience.com/pagerank-algorithm-fully-explained-dc794184b4af">Pagerank）的很好的解释</a>。</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Russell, D., <em>What Do You Need to Know to Use a Search Engine? Why We Still Need to Teach Research Skills</em>, AI Magazine, 36(4), 2015.</p>
         <p class="hanging-indent"><sup>2 </sup>Croft, B., Metzler D., Strohman, T.,<em> Search Engines, Information Retrieval in Practice</em>, 2015.</p>
         <p class="hanging-indent"><sup>3</sup> Spencer, S., <em>Google Power Search: The Essential Guide to Finding Anything Online With Google</em>, Koshkonong, Kindle Edition.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-behind-the-search-lens-effects-of-search-on-the-individual" title="搜索视角的背后：搜索对个人的影响">
         <header>
              <h1 class="chapter-title">搜索视角的背后：搜索对个人的影响</h1>
              <p data-type="subtitle" class="chapter-number">13</p>
         </header>
         <p>搜索引擎提供了极大的便利，但它们对个人用户和社会整体也带来了一些负面影响。了解这些影响可以帮助我们更好地保护自己和我们所关心的人。</p>
         <h3 style="text-align: left">数据和隐私</h3>
         <p class="indent no-indent">在大多数情况下，无论是网站、搜索引擎还是邮件客户端，都会收集关于用户的信息。这些数据大多数会与用户的IP地址绑定，进而识别出用户的身份。随后，这些数据被用于投放精准广告，提供个性化内容，提升服务质量以及进行市场调研。然而，搜索引擎并不总是公开它们收集的所有信息、收集地点以及如何使用这些信息<sup>1</sup>，甚至它们在哪里收集的这些信息。例如，有研究表明，Google能够在近80%的网站上追踪用户的活动<sup>2</sup>。</p>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>了解！</strong></p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/cookies-and-fingerprinting/" target="_blank" rel="noopener">阅读关于</a> <strong>cookies</strong> 和其他追踪技术，如 <strong>指纹识别</strong>。
              </div>
         </div>
         <p class="indent">当有人搜索用户时，搜索引擎可以显示的信息包括：</p>
         <ul>
              <li>该用户在某些网站上发布的信息，</li>
              <li>经该用户同意后，由他人发布的信息，</li>
              <li>在其他场合收集后发布到网上的信息，如论坛帖子、活动记录、朋友分享等。</li>
         </ul>
         <p class="no-indent">使用搜索引擎时收集和处理的信息包括以下内容：</p>
         <p class="indent"><img class="alignleft wp-image-793" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.13-e1717731723505.png" alt="" width="372" height="661" /></p>
         <ul>
              <li style="text-align: justify">搜索的主题、搜索的日期和时间<sup>1,3,4</sup>。</li>
              <li style="text-align: justify">搜索引擎，比如Google和Microsoft，还会收集我们在电子邮件、日历和地图等应用中的活动数据<sup>3,4</sup>。</li>
              <li style="text-align: justify">有些搜索引擎还会从第三方购买数据<sup>3,4</sup>。</li>
              <li style="text-align: justify">从搜索引擎和网站购买的数据，由第三方整合并与用户关联<sup>2</sup>。</li>
              <li style="text-align: justify">从收集的数据中做出的推断。</li>
              <li style="text-align: justify">从个人设置中得出的推断。例如，“推断一个设置了强隐私设置的用户可能具有某些心理特质，或者他们可能有“什么需要隐瞒的事情””<sup>5</sup>。</li>
              <li style="text-align: justify">基于这些信息，搜索引擎会创建用户的画像或模型。但请注意，这些模型主要基于在线数据，只能提供对用户的有限了解。因此，在其他情境下基于这些模型做出的决策可能并不准确或全面。</li>
         </ul>
         <p class="no-indent">在收集到同意提供数据的用户信息后，搜索引擎可能会利用这些信息来推测那些未同意提供数据的用户，尽管后者与前者具有相似的用户画像。</p>
         <p class="indent">这些数据，无论是否经过处理，都带来了隐私和安全问题。为了保护隐私，搜索引擎提供商、政府和用户都可以采取一系列措施：</p>
         <ul>
              <li style="text-align: justify">数据可以采用更安全的方式进行存储，以减少泄露和被盗的风险。比如分散到不同的数据库中<sup>5</sup>；</li>
              <li>对数据进行加密或匿名化处理；</li>
              <li>机器学习技术还可以用来自动检测和分类追踪器，从而改善浏览器的隐私保护功能<sup>2</sup>；</li>
              <li>像GDPR这样的政策和法规可以引入明确的指导方针和制裁措施，以规范数据的收集、使用和存储<sup>1</sup>；</li>
              <li>一些以用户为中心的建议也被提出并公开，帮助用户（包括家长和教师）更好地保护自己和被监护人的隐私。</li>
         </ul>
         <p><a href="https://www.bilibili.com/video/BV1Aw4m1v7Te/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">【[AI4T] 关于数据隐私 (On Data Privacy)】 </a></p>
         <p class="no-indent">在欧洲，搜索引擎公司被视为“个人数据的掌控者”，而不仅仅是服务提供者。这意味着，这些公司需要对通过其平台可以获取的内容负起法律责任。然而，隐私法主要是关注那些机密和私密的数据。即使是关于人们看起来无害的信息也可以被挖掘，从而根据数据中的隐性信息创建出用户画像。这些画像（不论是否准确）都可能被用来做出影响个人的决策<sup>1</sup>。</p>
         <p class="indent">此外，不同国家对于法律的执行方式也有所区别。根据 GDPR 的规定，个人可以要求搜索引擎公司删除与他们相关的搜索结果。但即便公司按照要求在欧洲删除了这些结果，这些页面仍有可能在欧洲以外的地区出现在搜索结果中<sup>1</sup>。</p>
         <p class="no-indent"><img class="aligncenter wp-image-796" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.14-1-e1717732305725.png" alt="" width="393" height="699" />虽然公司制定的政策可以为我们了解其运营方式提供一些线索，但研究显示，这些政策在实际执行中往往存在偏差<sup>2</sup>。</p>
         <h3 style="text-align: left" data-pm-slice="1 1 []">内容的可靠性</h3>
         <p class="no-indent">批评者提出，搜索引擎公司在选择展示哪些网站以及为何将某些页面排名靠前方面并不完全透明<sup>1</sup>。</p>
         <p class="indent">搜索结果的排名很大程度上受到广告商的影响，他们赞助的内容往往排序靠前。此外，大型搜索引擎公司除了提供搜索功能外，也倾向于<span style="font-size: 1em">在搜索结果中</span><span style="text-align: initial;text-indent: 2em;font-size: 1em">优先展示自家的内容。在欧洲，谷歌就因为不</span><span style="font-size: 1em">考虑产品或服务的实际优劣，</span><span style="text-align: initial;text-indent: 2em;font-size: 1em">在其搜索结果中过于突出自家的产品或服务而遭到指控</span><sup style="text-align: initial;text-indent: 2em">1</sup><span style="text-align: initial;text-indent: 2em;font-size: 1em">。</span></p>
         <p class="indent">研究排名算法的大型企业和网络开发者也能通过操纵搜索引擎对网站流行度和真实性的判断来影响排名。当然，搜索引擎程序员所认为的重要标准本身就值得质疑。</p>
         <p class="indent">这自然会影响搜索结果的可靠性。因此，我们在获取信息时，最好使用多个来源和多个搜索引擎，并在学校工作中对使用的内容进行讨论。</p>
         <h3 style="text-align: left">自主性</h3>
         <p class="no-indent" style="text-align: left">搜索引擎通过其排序系统推荐内容，但如果不公开选择这些内容的标准，就会降低用户的自主性。例如，如果我们知道某个推荐的网页是广告赞助的，或者它的排序是基于我们不认同的流行度标准，我们可能就不会选择它。搜索引擎和其他推荐系统通过剥夺我们的知情同意权，对我们的行为产生了控制性影响。</p>
         <p class="indent">自主性意味着个体能够掌控过程、决策和结果<sup>7</sup>。它意味着自由（摆脱外部控制）和能动性（具备主动行动的能力）<sup>7</sup>。那些不提供任何解释就推荐内容的系统侵犯了用户的自主性。这些系统通过只向用户展示他们喜欢的内容并限制他们接触到的选项范围，来推动用户朝特定方向做出选择<sup>5</sup>。</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Tavani, H., Zimmer, M., <a href="https://plato.stanford.edu/archives/fall2020/entries/ethics-search/" target="_blank" rel="noopener" data-cke-saved-href="https://plato.stanford.edu/archives/fall2020/entries/ethics-search/"><em>Search Engines and Ethics</em></a>, The Stanford Encyclopedia of Philosophy, Fall 2020 Edition), Edward N. Zalta ed.</p>
         <p class="hanging-indent"><sup>2 </sup>Englehardt, S., Narayanan, A., <em><a href="https://webtransparency.cs.princeton.edu/webcensus/" target="_blank" rel="noopener" data-cke-saved-href="https://webtransparency.cs.princeton.edu/webcensus/">Online Tracking: A 1-million-site Measurement and Analysis</a></em>, Extended version of paper at ACM CCS 2016.</p>
         <p class="hanging-indent"><sup>3 </sup><a href="https://policies.google.com/privacy?hl=en-US#infocollect" target="_blank" rel="noopener" data-cke-saved-href="https://policies.google.com/privacy?hl=en-US#infocollect">Google Privacy and Terms.</a></p>
         <p class="hanging-indent"><sup>4 </sup><a href="https://privacy.microsoft.com/en-us/privacystatement#mainbingmodule" target="_blank" rel="noopener" data-cke-saved-href="https://privacy.microsoft.com/en-us/privacystatement#mainbingmodule">Microsoft Privacy Statement.</a></p>
         <p class="hanging-indent"><sup>5 </sup>Milano, S., Taddeo, M., Floridi, L. <em><a href="https://doi.org/10.1007/s00146-020-00950-y" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1007/s00146-020-00950-y">Recommender systems and their ethical challenges</a></em>, <i>AI &amp; Soc</i> 35, 957–967, 2020.</p>
         <p class="hanging-indent"><sup>6 </sup>Tavani, H.T., <em>Ethics and Technology: Controversies, Questions, and Strategies for Ethical Computing</em>, 5th edition, Hoboken, NJ: John Wiley and Sons, 2016.</p>
         <p class="hanging-indent"><sup>7 </sup>Hillis, K., Petit, M., Jarrett, K., <em>Google and the Culture of Search, </em>Routledge Taylor and Francis, 2013.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-behind-the-search-lens-effects-of-search-on-the-individual-on-the-society" title="搜索视角的背后：搜索对社会的影响">
         <header>
              <h1 class="chapter-title">搜索视角的背后：搜索对社会的影响</h1>
              <p data-type="subtitle" class="chapter-number">14</p>
         </header>
         <h3 style="text-align: left">社会影响</h3>
         <p class="no-indent">如今，越来越多的人认为网络上的信息至关重要，应该通过搜索引擎轻松获取<sup>1</sup>。正如LM Hinman所说，“存在就意味着在谷歌上被索引。”他还指出，“如果民主社会的公民没有获取准确信息的途径，那么他们将无法做出明智的决定”<sup>2,3</sup>。如果民主的基础是自由获取真实、未经过滤的信息，那么搜索引擎就在很大程度上影响着我们的民主水平。然而，搜索引擎作为知识守门人的角色与其作为依赖广告收入的私营企业的本质之间存在直接冲突。因此，为了维护自由社会的原则，我们必须要求搜索引擎承担相应责任，并提高其算法工作的透明度<sup>2</sup>。</p>
         <h3 style="text-align: left">创建过滤气泡</h3>
         <p class="no-indent">基于用户画像推荐内容的系统，如搜索引擎，可能会使用户陷入信息茧房，避免接触不同的观点。这些系统通过不断推送用户喜欢的内容，加强了用户的偏见，形成了所谓的“过滤气泡”<sup>2,4</sup>。这些过滤气泡是在用户基于过去的兴趣和活动获取新知识的过程中逐渐形成的<sup>5</sup>，进而偏见成为了他们知识体系的基础。对于年轻且易受影响的群体来说，这种现象尤为危险。因此，我们应该在课堂上鼓励学生们与同伴和教师进行开放讨论，开展协作学习活动，拓宽他们的视野。</p>
         <h3 style="text-align: left">反馈循环</h3>
         <p class="no-indent">搜索引擎和其他推荐系统一样会预测用户感兴趣的内容。当用户点击推荐的内容时，搜索引擎会将其视为正面反馈，并据此调整未来显示的链接。然而，我们很难判断用户点击某个链接是因为它确实相关，还是仅仅因为它是第一个结果而更容易被选中。</p>
         <p class="indent">这种隐性的反馈很难被准确解读。当预测基于错误的解读时，其效果更是难以预测。如果某些结果反复出现——成为用户唯一能看到的内容——这可能会改变用户的喜好——形成是一种自我实现的预言。</p>
         <p class="indent">在美国，曾有一个预测性警务系统，它标出了高犯罪率的地区。因此，更多的警察被部署到这些地区。由于这些警官知道该地区风险较高，他们会更加小心，并且比平常拦截、搜查或逮捕更多的人。这样一来，逮捕行为验证了预测的准确性，即使这些预测最初存在偏见。更糟糕的是，这些逮捕数据还会被用于对同一地区及类似地区进行未来预测，随着时间的推移，偏见只会不断加深<sup>5</sup>。</p>
         <p class="indent">我们使用预测系统是为了基于预测结果采取行动。然而，根据有偏见的预测采取行动会对未来的结果、涉及的人员以及整个社会产生深远影响。“因实现检索相关信息的目的产生的副作用，搜索引擎必然会改变它旨在测量、排序和排名的对象。同样，大多数机器学习系统也会影响它们所预测的现象”<sup>5</sup>。</p>
         <h3 style="text-align: left">假新闻、极端内容和审查制度</h3>
         <p class="no-indent">现在，假新闻（即作为新闻发布的虚假故事）在在线论坛、社交媒体平台和博客上越来越常见，学生们只要搜索就能找到。有些小团体专门提高特定视频和极端内容网站的评分，以此增加内容的流行度和可信度，进而操纵排序算法<sup>4</sup>。但到目前为止，搜索引擎公司还没有出台明确的政策来控制假新闻<sup>2</sup>。</p>
         <p class="indent">另一方面，搜索引擎会系统地排除某些网站和某些类型的网站，而偏爱其他网站<sup>6</sup>。有时，他们甚至会对某些作者的内容进行审查，尽管公众并没有提出这样的要求。因此，我们在使用搜索引擎时，应保持警惕，谨慎选择，明智判断。</p>
         <hr />
         <p class="indent hanging-indent"><sup>1 </sup>Hillis, K., Petit, M., Jarrett, K., <em>Google and the Culture of Search, </em>Routledge Taylor and Francis, 2013.</p>
         <p class="indent hanging-indent"><sup>2</sup> Tavani, H., Zimmer, M., <em><a href="https://plato.stanford.edu/archives/fall2020/entries/ethics-search/" target="_blank" rel="noopener" data-cke-saved-href="https://plato.stanford.edu/archives/fall2020/entries/ethics-search/">Search Engines and Ethics</a></em>, The Stanford Encyclopedia of Philosophy, Fall 2020 Edition), Edward N. Zalta (ed.).</p>
         <p class="indent hanging-indent"><sup>3 </sup>Hinman, L. M., <em>Esse Est Indicato in Google: Ethical and Political Issues in Search Engines</em>, International Review of Information Ethics, 3: 19–25, 2005.</p>
         <p class="indent hanging-indent"><sup>4 </sup>Milano, S., Taddeo, M., Floridi, L. <em><a href="https://doi.org/10.1007/s00146-020-00950-y" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1007/s00146-020-00950-y">Recommender systems and their ethical challenges</a></em>, <i>AI &amp; Soc</i> 35, 957–967, 2020.</p>
         <p class="indent hanging-indent"><sup>5 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <em><a href="https://fairmlbook.org/" target="_blank" rel="noopener" data-cke-saved-href="https://fairmlbook.org/">Fairness and machine learning Limitations and Opportunities</a>, </em>MIT Press, 2023.</p>
         <p class="indent hanging-indent"><sup>6 </sup>Introna, L. and Nissenbaum, H., <em>Shaping the Web: Why The Politics of Search Engines Matters</em>, The Information Society, 16(3): 169–185, 2000.</p>
    </section>
</div>
<div data-type="part" class="part" id="part-managing-learning">
    <header>
         <h1 class="part-title">管理学习</h1>
         <p data-type="subtitle" class="part-number">III</p>
    </header>
    <p class="indent no-indent">在你必须进行准备和评估工作时，你可能还要同时处理着行政任务。</p>
    <p class="indent"><em>你是否曾感觉无论是在课堂内还是课堂外，时间都不够用，无法更有效地帮助你的学生？</em></p>
    <p class="indent">一节课的时间可能过得太快，而且往往有很多学生表现让你难以监测记录。</p>
    <p class="indent"><em>你有没有错过学生的某个反应表现，未能解释清楚一个易混淆点？</em></p>
    <p class="indent"><em>有没有一种方法可以追踪每个学生的学习进程和遇到的困难？</em></p>
    <p class="indent"><em>除了询问同事，你如何能更好地了解其他科目中学生的学习情况，以便帮助他们提升学习能力？</em></p>
    <section data-type="chapter" class="chapter" id="chapter-smart-lms" title="智慧学习管理系统">
         <header>
              <h1 class="chapter-title">智慧学习管理系统</h1>
              <p data-type="subtitle" class="chapter-number">15</p>
         </header>
         <h2 class="chapter-author">Giuseppe Città 和 Manuel Gentile</h2>
         <h3 dir="ltr" style="text-align: left">电子化学习和学习管理系统（LMS）</h3>
         <p class="no-indent">使用电子化学习（E-learning）方式的人数在不断增长。“电子化学习”指的是通过技术介导的学习。在这种情况下，教育者和学习者不处于同一个空间和/或时间上。电子化学习的最终目标是改善学生的学习体验和实践。</p>
         <p class="indent">如今，随着技术的进步，更合适的叫法是电子学习的“传递”系统和平台，而不是单一用途的工具。该系统将不同软件工具集成在一起，构建出一个使用者可以灵活、自由地选择学习路径的生态系统。电子化学习系统可以管理使用者的学习过程和学习课程。它能够评估学生的学习、编写报告以及创建和组织相关内容。它能促进教师/导师与学生之间的沟通。在广泛使用的电子化学习系统之中，典型的例子有学习管理系统（LMS）（例如 Moodle、Edmodo）。</p>
         <p class="indent">学习管理系统（LMS）指的是一种基于网络的应用程序，旨在以不同的方式和不同的领域来管理不同级别的培训者<sup>1</sup>的学习过程。因此，LMS可以被定义为一个学习环境，在这个环境内实施学习、内容和评估活动及工具。同样在这个环境中，实施和管理“学生与学生”和/或“学生与教育者”的互动。此外，LMS的定义还涵盖了那些包含完整的课程管理系统、内容管理系统和门户的平台<sup>2</sup>。</p>
         <h3 dir="ltr" style="text-align: left">LMS和AI：智慧LMS</h3>
         <p class="no-indent">随着AI的出现，教育，特别是LMS，在这一革命性力量的应用中变成可能且充满希望的领域<sup>3</sup>。具体来说，得益于AI支持的功能，LMS代表了一种全新的学习工具，能够满足未来教育的两个基本特征：个性化和适应性<sup>4</sup>。正是从LMS和AI的结合中，智慧LMS（SLMS）或智慧学习管理系统诞生了。</p>
         <p class="indent">一个高效的SLMS具有能够从三个基本知识群中提供信息和检索信息的算法：a) 学习者， b) 教学法，和 c) （学科）领域。通过获取有关 (a) 学习者的偏好、他们的情绪和认知状态以及他们的成就和目标的信息，SLMS 可以实施对学习最有效的教学策略 (b)（特定类型的评估、协作学习等） ，在所研究的特定知识领域内最富有成效，（c）例如几何定理、数学运算、物理定律、文本分析程序4。</p>
         <p class="indent">因此，SLMS 可以被定义为一种学习系统，能够根据学习者在之前任务中展示的知识和技能来调整向学习者提出的内容。实际上，通过采用以学习者为中心的方法，它可以识别、跟踪和监控学习者的学习路径，记录他们的学习模式和风格。参考Fardinpour等人<sup>5</sup>的描述，智慧 LMS 通过<strong>自动化</strong>、不同教学策略（支架）的适应以及<strong>报告</strong>和<strong>知识生成</strong>，为学习者提供最有效的学习路径和最合适的学习内容 。它还可能为学习者提供有关跟踪和监控他们的学习和<strong>学习目标</strong>的帮助。此外，尽管LMS因为这些功能和工具能够更智能地运作，SLMS必须保证能为学习者提供禁用管理学习路径的AI的选择，以便他们可以使用学习环境中的所有学习材料。</p>
         <h3 style="text-align: left">SLMS中AI支持的功能示例</h3>
         <p class="no-indent">当SLMS正确运行时，几种AI支持的工具使具有上述特征的系统成为可能。这种AI支持的工具沿着上述三个知识集群横向移动，SLMS 算法不断参考这些知识集群（学习者、教学法、领域）。</p>
         <h3 style="text-align: left">AI支持的虚拟导师聊天机器人</h3>
         <p class="no-indent" style="text-align: left">聊天机器人是一种模拟、处理人类对话（书面或口头表达）的软件。在SLMS的背景下，它可以是虚拟导师，回答学习者关于学习课程等的问题。根据对学习者之前的表现和互动的分析，聊天机器人还能够向学习者提供建议<sup>6</sup>。</p>
         <h3 style="text-align: left">学习分析</h3>
         <p>学习分析——基于在线学习活动中与个别学习者互动的细节的相关数据，允许教师进一步监控学习者的进展和表现。得益于它们，系统可以激活实施自动的计算机辅助教育任务<sup>7</sup>，来弥补那些在特定任务中学习者表现不好的活动。此外，它还可以自动向教学人员提供对任务难度的相关建议或是否需要用额外学习内容来补充学习的建议。</p>
         <h3 style="text-align: left">对学习者和教师的益处</h3>
         <p class="no-indent">以上和其他AI所支持的工具<sup>4</sup>有助于使SLMS成为一个强大的学习和教学工具，它不会被视为教师工作的替代品，而是能够“增强”教学的人性化方面并带来更多的学习和教学工具，为整个学习/教学过程带来一系列的益处。</p>
         <p class="indent">由于SLMS的测量内容为学生的技能和水平，它让学习者在其学习路径中的不同阶段，不会遇到因为太简单而感到无聊，或因为太复杂而感到沮丧的任务。这保证了学生的动机和注意力始终保持在高水平并能适应任务的不同难度。这种情况直接促使辍学率显著降低，因为它能让教师及时发现问题，看到了学生遇到困难的迹象的时候能迅速介入其中。</p>
         <p class="indent">以上情况以及线性学习情况（即没有困难的情况） SLMS 工具可以向学生提供已存储在课程数据库中或来自第三方提供商的不同知识内容来解决问题。这给教师带来了直接的好处，他们不需要频繁地开发新的教学材料，可以将节省的时间用于其他重要的地方，例如改进教学方法和/或与学生进行直接的互动。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Kasim, N. N. M., and Khalid, F., <em>Choosing the right learning management system (LMS) for the higher education institution context: A systematic review</em>, International Journal of Emerging Technologies in Learning, 11(6), 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Coates, H., James, R., &amp; Baldwin, G., <em>A critical examination of the effects of learning management systems on university teaching and learning</em>, Tertiary education and management, 11(1), 19-36, 2005.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup> Beck, J., Sternm, M., &amp; Haugsjaa, E., <em>Applications of AI in Education</em>, Crossroads, 3(1), 11–15. doi:10.1145/332148.332153, 1996.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4</sup> Rerhaye, L., Altun, D., Krauss, C., &amp; Müller, C., <em>Evaluation Methods for an AI-Supported Learning Management System: Quantifying and Qualifying Added Values for Teaching and Learning,</em> International Conference on Human-Computer Interaction (pp. 394-411). Springer, Cham, July 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5</sup> Fardinpour, A., Pedram, M. M., &amp; Burkle, M., <em>Intelligent learning management systems: Definition, features and measurement of intelligence</em>, International Journal of Distance Education Technologies (IJDET), 12(4), 19-31, 2014.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6</sup><a href="https://www.spiceworks.com/hr/learning-development/articles/emerging-trends-for-ai-in-the-learning-management-system/">HR Technologist: Emerging Trends for AI in Learning Management Systems</a>, 2019, Accessed 31 Oct 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7</sup> Krauss, C., Salzmann, A., &amp; Merceron, A., <em>Branched Learning Paths for the Recommendation of Personalized Sequences of Course Items</em>, DeLFI Workshops, September 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>8</sup> Mavrikis, M., &amp; Holmes, W., <em>Intelligent learning environments: Design, usage and analytics for future schools,</em> Shaping future schools with digital technology, 57-73, 2019.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-slug-235" title="学习分析与教育数据挖掘">
         <header>
              <h1 class="chapter-title">学习分析与教育数据挖掘</h1>
              <p data-type="subtitle" class="chapter-number">16</p>
         </header>
         <h2 class="chapter-author">Anne Boyer; Azim Roussanaly; 和 Jiajun Pan</h2>
         <h3 style="text-align: left">什么是学习分析？</h3>
         <p class="no-indent">越来越多的组织正在使用数据分析来解决问题并改进与活动相关的决策。教育界也不例外，因为随着虚拟学习环境（VLE）和学习管理系统（LMS）的普及，如今可以获得大量由学习者与这些工具互动而产生的学习数据。</p>
         <p class="indent">学习分析（Learning Analytics，LA）是一个学科领域，定义是“测量、收集、分析并报告学习者及其环境的相关数据，目的是为了理解并优化学习及其环境”<sup>4</sup>。</p>
         <p class="indent">根据需要解决的不同问题，通常分为四种类型的分析：</p>
         <ul>
              <li>描述性分析：过去发生了什么？</li>
              <li>诊断性分析：为什么过去会发生某事？</li>
              <li>预测性分析：未来最有可能发生什么？</li>
              <li>处方性分析：对这些结果进行干预应采取哪些行动？</li>
         </ul>
         <h3 style="text-align: left">它是什么？</h3>
         <p class="no-indent">推荐系统的可视化。目前该领域的研究很活跃。我们将针对文献中经常出现的问题进行总结。每个问题都指向了主要针对学习者或教师的一系列工具。这些师生是LA应用程序大多数最终用户群体的代表。</p>
         <h3 style="text-align: left">预测并提高学生学习成果</h3>
         <figure id="attachment_81" aria-describedby="caption-attachment-81" style="width: 200px" class="wp-caption alignright">
              <img class="size-medium wp-image-79" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-Purdue-LA-200x300.jpg" alt="" width="200" height="300" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-Purdue-LA-200x300.jpg 200w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-Purdue-LA-65x97.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-Purdue-LA-225x337.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-Purdue-LA.jpg 351w" sizes="(max-width: 200px) 100vw, 200px" />
              <figcaption id="caption-attachment-81" class="wp-caption-text">图1：普渡大学学生仪表板</figcaption>
         </figure>
         <p class="no-indent">LA的一个标志性应用是失败预测。</p>
         <p class="indent">学习指标是从数字痕迹中自动计算出来的，学习者可以通过直接访问这些指标来调整自己的学习策略。</p>
         <p class="indent">第一个实验是在美国的普渡大学进行的，实验使用了一个基于名为交通信号灯（Signal）的仪表板设计的移动应用程序<sup>1</sup>。</p>
         <p class="indent">每个学生都可以通过应用程序对自己的学习进度指标进行监控。</p>
         <p class="indent">图1是仪表板的截图。</p>
         <p class="indent">在早期的预警系统（EWS）中，该指标也可以发送给教师。</p>
         <p class="indent">这是法国的国家远程教育中心（CNED）正在进行的研究的选择<sup>2</sup>。</p>
         <p class="indent">EWS的目标是尽早给予负责监控学生的导师提醒，以便实施适当的补救措施。</p>
         <h3 style="text-align: left">分析学生学习过程</h3>
         <figure aria-describedby="caption-attachment-81" style="width: 404px" class="wp-caption alignleft">
              <img class="wp-image-80" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-300x225.jpg" alt="" width="404" height="303" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-300x225.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-1024x767.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-768x575.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-1536x1150.jpg 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-65x49.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-225x169.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran-350x262.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page-2-efran.jpg 2012w" sizes="(max-width: 404px) 100vw, 404px" />
              <figcaption class="wp-caption-text">图2：e-FRAN METAL项目仪表板</figcaption>
         </figure>
         <p class="no-indent">LA技术可以对一个学习者或一组学习者（一个班级）的学习行为建模。该模型可用于在LA应用程序中展示学习者的学习过程，提供额外信息，使教师能够检测到学业失败，从而进一步改进培训材料和方法。此外，分析学生的学习过程也是一种观察学习者的投入度的方式。例如，如图2所示<sup>3，</sup>在项目e-FRAN METAL中，指标汇总在与一组中学教师共同设计的仪表板中。</p>
         <h3 style="text-align: left">个性化学习路径</h3>
         <p class="no-indent">个性化学习路径存在于学习推荐系统或自适应学习系统中。推荐系统旨在向每个学习者提供最佳资源或适当学习行为的建议，有助于实现教育目标。</p>
         <p class="indent">一些系统侧重于首先通过系统为教师提出验证建议，来让他们参与其中。自适应学习系统可以让学习者通过不断调整学习路径以适应学习者的体验，通过更个性化和自定进度的方式发展技能和知识的学习。</p>
         <h3 style="text-align: left">它有效吗？</h3>
         <p class="no-indent">在文献中，反馈主要集中在学生身上，包括那些在高校中的学生。通常观察显示学习者的表现有所提升（例如，在美国普渡大学，成绩等级A和B提高了10%）。对于教师来说，去评估LA带来的影响会更复杂。基于技术接受模型（TAM）的研究表明，教师对使用LA持积极看法。我们在一项研究中再现了对最终优势、劣势、机会和威胁的分析（SWOT）<sup>5</sup>（见图3）。</p>
         <figure id="attachment_922" aria-describedby="caption-attachment-922" style="width: 1024px" class="wp-caption aligncenter">
              <img class="wp-image-922 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3-1024x206.png" alt="" width="1024" height="206" />
              <figcaption id="caption-attachment-922" class="wp-caption-text">图3：LA接受度的SWOT分析<sup>5</sup></figcaption>
         </figure>
         <p class="no-indent">在威胁和劣势的部分中包含的一些关注点构成了学习分析研究协会（SoLAR）社区反思的基础，为 LA 应用程序推荐一种基于设计伦理的方法 (Drashler-16)。这些建议汇总在八个关键词清单中：确定的、解释、合法化、参与、同意、匿名化、技术、外部（DELICATE）。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Arnold, K. 和 Pistilli, M<em>., Course signals at Purdue: Using learning analytics to increase student success</em>, LAK2012, ACM International Conference Proceeding Series, 2012.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Ben Soussia, A., Roussanaly, A., Boyer, A., <em>Toward An Early Risk Alert In A Distance Learning Context</em>, ICALT, 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup> Brun, A., Bonnin, G., Castagnos, S., Roussanaly, A., Boyer, A., <em>Learning Analytics Made in France: The METALproject</em>, IJILT, 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4</sup> Long, P., and Siemens, G., 1st International Conference on Learning Analytics and Knowledge, Banff, Alberta, February 27–March 1, 2011.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5</sup> Mavroudi, A., <em>Teachers’ Views Regarding Learning Analytics Usage Based on the Technology Acceptance Model,</em> TechTrends. 65, 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-data-based-systems-part-1" title="AI说（AI-Speak）：基于数据的系统，第1部分">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：基于数据的系统，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">17</p>
         </header>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <h3 style="text-align: left"><strong>课堂中的决策</strong></h3>
              </header>
              <div class="textbox__content">
                   <p>作为一名教师，你可以接触到许多种类的数据。无论是具体的数据，如出勤和表现记录，还是无形的数据，如学生的肢体语言。请思考你在职业生涯中做出过的一些决策：<em>是哪些数据帮助你做出这些决策的？</em></p>
                   <p>有的技术应用程序可以帮助你可视化数据或处理数据。人工智能系统通过使用数据进行个性化学习，能做出辅助你教学和管理课堂的预测和决策：<em>你有哪些需求是技术可以做出解答的吗？如果有，这样的系统可能需要哪些数据来完成任务？</em></p>
              </div>
         </div>
         <figure id="attachment_802" aria-describedby="caption-attachment-802" style="width: 264px" class="wp-caption alignleft">
              <img class="wp-image-802" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.1-e1717734293570.png" alt="" width="264" height="469" />
              <figcaption id="caption-attachment-802" class="wp-caption-text">来源: Kelleher, J.D, Tierney, B, Data Science, London, 2018 and Kitchin, R, Big Data, new epistemologies and paradigm shifts, Big Data &amp; Society, 2014</figcaption>
         </figure>
         <p class="indent no-indent">教育系统一直在生成数据——学生的个人数据、学术记录、出勤数据等等。通过数字化和AIED应用可以记录和存储更多的数据：鼠标点击、打开的页面、时间戳和键盘敲击<sup>1</sup>。随着以数据为中心的思维方式成为社会常态，会自然地产生有关如何处理所有这些数据来做一些相关的事情的问题。我们是否能给学习者带来更个性化的反馈？我们是否能为教师设计出更好的可视化和通知工具？<sup>2</sup></p>
         <p class="indent">无论使用什么技术，必须要满足课堂中的真实需求。在确定需求后，我们可以关注可用的数据并询问与期望的结果相关的数据有哪些。这涉及到揭示让教育者做出精巧决策的因素。这些因素能否通过可用数据来捕捉？解决需求的最佳方式是数据和基于数据的系统吗？这样使用数据会产生哪些可能的后果？<sup>3</sup></p>
         <p class="indent">机器学习让我们可以将许多问题交给数据本身<sup>4</sup>。机器学习应用程序是根据数据进行训练的，它们通过操作数据来工作。它们发现模式，做出概括，并将其存储为模型——可用于回答未来问题的数据<sup>4</sup>。它们做出的决策和预测，以及对学生学习产生的影响都是以数据形式呈现。因此，理解人工智能工作方式的重要一环就是了解程序员、机器和用户是如何处理数据的。</p>
         <h3 style="text-align: left">关于数据</h3>
         <p class="no-indent"><strong>数据</strong>通常是关于一个在现实世界存在的实体——一个人、一个物品或一个事件。每个实体都可以通过多个<strong>属性</strong>（<strong>特征</strong>或<strong>变量</strong>）来进行描述<sup>5</sup>。例如，姓名、年龄和所属班级是学生的一些属性。这些属性的集合就是我们关于学生所拥有的数据。虽然这些数据并不是真实存在的个体，但它们确实能告诉我们一些关于他们的信息。在教育系统中收集、使用和处理的数据被称为<strong>教育数据<sup>1</sup></strong>。</p>
         <p class="indent">一个<strong>数据集</strong>是按行和列来进行排列的一系列数据。一个班级的出勤记录是一个数据集。在这种情况下，每一行记录一名学生。每一列可能是他们在某天或某课程中的出席或缺席情况。因此，每一列记录一个属性。</p>
         <p><a href="https://www.bilibili.com/video/BV1xi421v7Dh/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 数据：其形状和大小多种多样 (Data: it comes in many shapes and sizes (1/2)</a></p>
         <p><img class="alignright wp-image-1058 size-medium" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-300x300.png" alt="" width="300" height="300" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-300x300.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-1024x1024.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-150x150.png 150w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-768x768.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-65x65.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-225x225.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018-350x350.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240823163018.png 1080w" sizes="(max-width: 300px) 100vw, 300px" /></p>
         <p class="no-indent">数据的创建是通过选择属性并进行测量：每一条数据都是人类决策和选择的结果。因此，数据的创建是一个主观的、片面的，有时是混乱的过程，容易出现技术上的困难<sup>4,5</sup>。此外，我们选择测量或者不测量对预期结果会产生很大影响。</p>
         <p class="indent"><strong>数字痕迹</strong>是学生活动的记录，如鼠标点击、查看页面产生的数据、交互的时间或在数字系统中的按键信息<sup>1</sup>。<strong>元数据</strong>是描述其它数据的数据<sup>5</sup>。<strong>派生数据</strong>是根据其它数据计算或推断出来的数据：每个学生的个人成绩是数据，班级平均分就是派生数据。通常，在获得有用的见解，发现模式和做出预测方面，派生数据更有用。机器学习应用程序可以创建派生数据，并将其与元数据的数据痕迹相联系起来，创建出详细的<a href="ai-speak--the-tech-behind-recommendation" data-cke-saved-href="ai-speak--the-tech-behind-recommendation">学习者模型</a>，促进个性化学习<sup>1</sup>。</p>
         <p class="indent">为了使任何基于数据的应用程序成功运行，应仔细选择属性并进行正确的测量。在教育背景下，应检查发现的模式是否有意义。如果设计和维护得当，基于数据的系统会非常有价值。</p>
         <p><a href="https://www.bilibili.com/video/BV1xZ421p7c1/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 数据：其形状和大小多种多样 (Data: it comes in many shapes and sizes (2/2) </a></p>
         <div>
         </div>
         <div>
         </div>
         <div>
         </div>
         <div class="textbox textbox--sidebar" style="text-align: left">
              <a href="https://pressbooks.pub/aiforteachers/chapter/more-on-big-data/" target="_blank" rel="noopener">检查你是否具备（大）数据素养</a>
         </div>
         <p class="no-indent" style="text-align: left">本章旨在介绍一些有关数据和基于数据的技术的基础知识，但数据素养也非常重要，值得开展专门的培训，并长期提供支持和更新<sup>1</sup>。</p>
         <h3 style="text-align: left">你应该了解的法律</h3>
         <p class="no-indent">由于数据存储成本的大幅降低，我们可以保存更多的数据和元数据，且能保留更长的时间<sup>6</sup>。这可能导致隐私泄露和权利侵犯。<strong>通用数据保护条例（GDPR）</strong>这样的法律明确规定禁止此类做法，并给予欧盟公民更多权利去管控他们的个人数据。它们在所有欧盟成员国提供法律上可执行的数据保护规定。</p>
         <figure id="attachment_837" aria-describedby="caption-attachment-837" style="width: 378px" class="wp-caption alignleft">
              <img class="wp-image-837" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.3-1-e1717745971175.png" alt="" width="378" height="672" />
              <figcaption id="caption-attachment-837" class="wp-caption-text">来源: “GDPR &amp; ePrivacy Regulations” by dennis_convert licenced under CC BY 2.0. To view a copy of this licence, visit https://creativecommons.org/licenses/ by/2.0/?ref=openverse</figcaption>
         </figure>
         <p class="indent">根据GDPR，个人数据是指任何与已识别或可识别的个人（<strong>数据主体</strong>）有关的信息。学校除了与处理其数据的公司开展合作外，还存储了大量有关学生、家长、员工、管理层和供应商的个人信息。作为数据控制者，他们必须保密，安全地存储数据，并需要有程序保护正确使用所有的个人数据<sup>1</sup>。</p>
         <p class="indent">GDPR确立的权利包括：</p>
         <ul>
              <li style="text-align: justify">公民拥有强制性<strong>访问权：</strong>能够（轻松地）知道收集了哪些他们的数据</li>
              <li style="text-align: justify">公民的<strong>知情权</strong>：了解被收集的数据的用途</li>
              <li style="text-align: justify"><strong>删除权：</strong>允许已被平台收集数据的公民提出从该平台构建的数据集中删除该数据的诉求（并且允许出售给他人）</li>
              <li style="text-align: justify"><strong>解释权</strong>：每当任何会对公民产生影响的自动决策过程需要说明时，应提供相应的解释</li>
         </ul>
         <p class="no-indent">尽管如此，GDPR也允许在“合法利益”<sup>7</sup>下收集某些数据，并且允许无限期、无需同意地使用派生、聚合或匿名化数据<sup>5</sup>。新的《<strong>数字服务法》</strong>限制将个人数据用于定向广告目的<sup>7</sup>。除此之外，<strong>欧盟-美国隐私盾（EU-US Privacy Shield）</strong>加强了欧盟公民的数据保护权利，来应对他们的数据被转移到欧盟以外地区的情况<sup>5</sup>。</p>
         <p class="indent">请参考<a href="https://www.liberties.eu/en/stories/gdpr-for-dummies/44076" target="_blank" rel="noopener" data-cke-saved-href="https://www.liberties.eu/en/stories/gdpr-for-dummies/44076">GDPR入门</a>，这是由欧洲公民自由联盟（Liberties）的独立专家进行的分析。欧洲公民自由联盟是一个保护欧盟公民人权的监督机构。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup><a href="https://education.ec.europa.eu/news/ethical-guidelines-on-the-use-of-artificial-intelligence-and-data-in-teaching-and-learning-for-educators">E<em>thical guidelines on the use of artificial intelligence and data in teaching and learning for educators</em></a><em><span class="s2">, </span></em>European Commission, October 2022.</p>
         <p class="hanging-indent"><sup>2</sup> du Boulay, B., Poulovasillis, A., Holmes, W., Mavrikis, M., <em>Artificial Intelligence And Big Data Technologies To Close The Achievement Gap</em>, in Luckin, R., ed. Enhancing Learning and Teaching with Technology, London: UCL Institute of Education Press, pp. 256–285, 2018.</p>
         <p class="hanging-indent"><sup>3 </sup>Hutchinson, B., Smart, A., Hanna, A., Denton, E., Greer, C., Kjartansson, O., Barnes, P., Mitchell, M., <em><a href="https://doi.org/10.1145/3442188.3445918">Towards Accountability for Machine Learning Datasets: Practices from Software <span class="s1">Engineering and Infrastructure</span></a>,</em> Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, Association for Computing Machinery, New York, 2021.</p>
         <p class="hanging-indent"><sup>4 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <a href="https://fairmlbook.org/">Fairness and machine learning Limitations and <span class="s1">Opportunities</span></a>, MIT Press, 2023.</p>
         <p class="hanging-indent"><sup>5 </sup>Kelleher, J.D, Tierney, B, <em>Data Science</em>, MIT Press, London, 2018.</p>
         <p class="hanging-indent"><sup>6</sup> Schneier, B., Data and Goliath: The Hidden Battles to Capture Your Data and Control Your World, W. W. Norton &amp; Company, 2015.</p>
         <p class="hanging-indent"><sup>7</sup> Kant, T., <em>Identity, Advertising, and Algorithmic Targeting: Or How (Not) to Target Your “Ideal User.”</em>, MIT Case Studies in Social and Ethical Responsibilities of Computing, 2021.</p>
         <hr />
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-data-based-systems-part-2" title="AI说（AI-Speak）：基于数据的系统，第2部分">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：基于数据的系统，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">18</p>
         </header>
         <p class="no-indent">设计实施一个以数据为中心的项目可以分解为六个步骤。这些步骤之间有很多来回往复。为确保正确，整个过程可能需要多次迭代。</p>
         <p class="indent">要使在课堂上有效，该过程的每一个步骤都需要多学科团队，包括教师、教育学专家和计算机科学家的参与<sup>1</sup>。需要专家来确定需求并设计流程，设计和准备数据，选择机器学习算法，批判性地解释结果并规划如何使用应用程序<sup>2</sup>。</p>
         <h3 style="text-align: left">1) 理解教育背景</h3>
         <p class="no-indent"><img class="alignleft wp-image-807" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.4-e1717735299815.png" alt="" width="298" height="447" />设计AIED工具的第一步是了解课堂上的需求。目标一旦确定，就需要关注如何去实现这些目标：考虑哪些因素和忽略哪些因素。任何基于数据的解决方案都有偏向于易于计算和标准化的现象<sup>3</sup>。因此，做出每个决定都必须经过使用该工具的教师，能够确保所有决定都基于已验证过的理论的教育学专家，和了解算法如何工作的计算机科学家的共同讨论。</p>
         <p class="indent">前两个步骤之间有很多来回往复，因为数据的可用性决定事件的可能性<sup>2</sup>。此外，教育工具的设计还受到法律的限制，这些法律对数据的使用和可使用的算法类型有所限制。</p>
         <h3 style="text-align: left">2) 理解数据</h3>
         <p class="no-indent">一旦确定了目标和有贡献性的因素，焦点就转移到需要什么数据，如何获取和标注数据，如何处理隐私以及如何衡量数据质量<sup>3</sup>。为确保机器学习应用程序的成功，数据集必须足够大，多样化且有着良好的标注。</p>
         <figure id="attachment_927" aria-describedby="caption-attachment-927" style="width: 367px" class="wp-caption alignright">
              <img class="wp-image-927" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809.png" alt="" width="367" height="339" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809.png 680w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809-300x277.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809-65x60.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809-225x208.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/截屏2024-06-21-11.28.58-e1718940806809-350x323.png 350w" sizes="(max-width: 367px) 100vw, 367px" />
              <figcaption id="caption-attachment-927" class="wp-caption-text">改编自Josef Steppan的MnistExamples。根据CC BY-SA 4.0许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-sa/4.0/?ref=openverse">https://creativecommons.org/licenses/by-sa/4.0/?ref=openverse</a></figcaption>
         </figure>
         <p class="indent">机器学习需要数据来训练模型，也需要数据来进行工作或预测。一些机器学习任务，如面部识别和物体识别，已经有很多可供训练的私有和公共数据库。</p>
         <p class="indent">如果提供的数据尚不可用，则可能需要添加现有数据集或重新标注现有数据集以满足项目的需求。否则可能需要从头开始创建和标注专用数据集。学生在使用应用程序时生成的数字痕迹也可以作为数据来源之一。</p>
         <p class="indent">无论如何，都必须仔细识别与问题相关的数据和特征<sup>2</sup>。不相关或冗余的特征可能会使算法发现错误模式并影响其系统的性能<sup>2</sup>。由于机器只能在给定的数据中发现模式，因此对数据集的选择也隐含地定义了问题是什么<sup>4</sup>。如果大量数据可用，就必须借助统计技术来选择一个子集，并对数据进行验证以避免出现错误和偏见。</p>
         <p class="indent">举一个训练数据失败的例子。在早期的计算机视觉中，曾训练出一个模型用于区分俄罗斯和美国坦克的图片。后来，发现它的准确率高是因为俄罗斯坦克的照片是在阴天拍摄的，而美国坦克的照片是在晴天拍摄的<sup>4</sup>。</p>
         <p class="indent">因此，所选的数据集必须要验证其质量，关注它是如何创建的，包含什么，收集、清理和标注、分布和维护的过程是什么<sup>4</sup>。要问的关键问题包括：<em>数据集是否适合其预定目的</em>和<em>数据集是否隐藏危险使模型产生偏见或歧视</em><sup>3</sup>。</p>
         <p><img class="aligncenter wp-image-809" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384.png" alt="" width="297" height="353" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384.png 1700w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-253x300.png 253w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-768x912.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-863x1024.png 863w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-1294x1536.png 1294w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-65x77.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-225x267.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.5-e1717735737384-350x415.png 350w" sizes="(max-width: 297px) 100vw, 297px" /></p>
         <h3 style="text-align: left">3) 准备数据</h3>
         <p class="no-indent">数据准备涉及通过合并来自不同地方的可用数据创建数据集，调整不一致的情况（例如，某些测试分数可能以 1 到 10 分呈现，而其他分数则以百分比形式呈现），并查找缺失值或极端值。然后，通过进行自动化测试来检查数据集的质量。这包括检查隐私是否泄露和未预见的相关性或刻板印象<sup>2</sup>。在这个阶段，数据集也可能被分成训练数据集和测试数据集。前者用于训练模型，后者用于检查性能。在训练数据集上进行测试就像是在考试前一天发放考卷作为家庭作业，学生的考试表现无法反映他们的理解<sup>2</sup>。</p>
         <p><img class="aligncenter wp-image-846" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289.png" alt="" width="287" height="316" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289.png 1700w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-272x300.png 272w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-929x1024.png 929w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-768x847.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-1393x1536.png 1393w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-65x72.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-225x248.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.6-3-e1717746268289-350x386.png 350w" sizes="(max-width: 287px) 100vw, 287px" /></p>
         <h3 style="text-align: left">4) 建模</h3>
         <p class="no-indent"><img class="alignleft wp-image-816" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709.png" alt="" width="327" height="365" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709.png 1700w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-269x300.png 269w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-768x856.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-919x1024.png 919w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-1378x1536.png 1378w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-65x72.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-225x251.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.7-2-e1717736615709-350x390.png 350w" sizes="(max-width: 327px) 100vw, 327px" />在这一步中，算法被用来<a href="ai-speak--machine-learning" data-cke-saved-href="ai-speak--machine-learning">提取数据中的模式</a>并创建<a href="ai-speak--how-youtube-learns-you" data-cke-saved-href="ai-speak--how-youtube-learns-you">模型</a>。通常，会通过测试不同的算法来查看哪种最有效。然后这些模型可以用来预测出新数据。</p>
         <p class="indent">在大多数项目中，初始模型会揭示出数据中的问题，需要在步骤 2 和步骤 3 之间来回往复<sup>2</sup>。只要数据的特征与输出值之间存在强相关性，就存在使用机器学习算法生成良好预测的可能。</p>
         <p class="indent">这些算法通过使用高级统计、计算技术来处理数据。程序员必须调整设置，并尝试不同的算法以取得最佳结果。以检测作弊的应用程序为例：假阳性（false positive）是指未作弊的学生被标记。假阴性（false negative）是指作弊的学生没有被标记。系统设计者可以调整模型，以最大程度地减少假阳性（可能会漏掉一些作弊行为）或假阴性（甚至标记可疑案例）<sup>5</sup>。因此，所做的调整取决于我们希望系统做什么。</p>
         <h3 style="text-align: left">5) 评估</h3>
         <p class="no-indent"><img class="alignright wp-image-818" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585.png" alt="" width="306" height="190" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585.png 1700w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-300x186.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-768x476.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-1024x635.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-1536x952.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-65x40.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-225x140.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.8-e1717736832585-350x217.png 350w" sizes="(max-width: 306px) 100vw, 306px" />在建模阶段，可以调整每个模型以提高训练数据集预测准确性。然后在测试数据集上测试模型，并选择一个模型使用。还要根据这个模型会如何满足教育需求来进行评估：是否满足第1步中设定的目标？有没有任何未预见的问题？质量如何？是否可以改进或以另一种方式完成？是否需要重新设计？主要的目标是确定应用程序是否可以在学校中部署。如果不行，整个过程就需要再一次重复<sup>2</sup>。</p>
         <h3 style="text-align: left">6) 部署</h3>
         <p class="no-indent"><img class="alignleft wp-image-821" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290.png" alt="" width="295" height="282" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290.png 1700w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-300x287.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-768x735.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-1024x980.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-1536x1470.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-65x62.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-225x215.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.9-e1717737032290-350x335.png 350w" sizes="(max-width: 295px) 100vw, 295px" />整个过程的最后一步是了解如何将基于数据的应用程序与学校系统集成，以在技术基础设施和教学实践方面获得最大收益。</p>
         <p class="indent">虽然这是最后一步，但整个过程是迭代性的。部署后，应定期审查模型，检查其是否仍然与背景相一致。需求、过程或数据捕获模式可能会发生变化，影响系统的输出。因此，应根据需要进行审查和更新应用程序。系统应持续监控其对学习、教学和评估带来的影响<sup>6</sup>。</p>
         <p class="no-indent"><sup><img class="aligncenter wp-image-826" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/3.10-e1717737215370.png" alt="" width="447" height="316" /></sup>关于教育者使用人工智能和数据进行教学和学习的伦理指南强调，在人工智能系统的整个生命周期内，甚至部署之前，学校都应该与AI服务提供商保持联系。应该要求提供清晰的技术文档，并说明不清楚之处。应就支持和维护达成协议，并确保供应商遵守所有法律义务<sup>6</sup>。</p>
         <p class="no-indent"><strong>注意：</strong>这里列出的步骤和插图均改编自CRISP-DM数据科学阶段和任务（基于1999年Chapman, Clinton, Kerber等人的研究，图3）<sup>2</sup>。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Du Boulay, B., Poulovasillis, A., Holmes, W., Mavrikis, M., <em>Artificial Intelligence And Big Data Technologies To Close The Achievement Gap</em>, in Luckin, R., ed. Enhancing Learning and Teaching with Technology, London: UCL Institute of Education Press, pp. 256–285, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Kelleher, J.D, Tierney, B, Data Science, London, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Hutchinson, B., Smart, A., Hanna, A., Denton, E., Greer, C., Kjartansson, O., Barnes, P., Mitchell, M., <a href="https://doi.org/10.1145/3442188.3445918"><em>Towards Accountability for Machine Learning Datasets: Practices from Software <span class="s1">Engineering and Infrastructure</span></em></a>, Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, Association for Computing Machinery, New York, 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <em><a href="https://fairmlbook.org/">Fairness and machine learning Limitations and <span class="s2">Opportunities</span></a>, </em>MIT Press, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Schneier, B., <em>Data and Goliath: The Hidden Battles to Capture Your Data and Control Your World</em>, W. W. Norton &amp; Company, 2015.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup><a href="https://education.ec.europa.eu/news/ethical-guidelines-on-the-use-of-artificial-intelligence-and-data-in-teaching-and-learning-for-educators"><em>Ethical guidelines on the use of artificial intelligence and data in teaching and learning for educators</em></a><span class="s1">, </span>European Commission, October 2022.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-what-not-to-do-with-data-issues-of-personal-identity-bias-and-fairness" title="数据相关的问题：个人身份">
         <header>
              <h1 class="chapter-title">数据相关的问题：个人身份</h1>
              <p data-type="subtitle" class="chapter-number">19</p>
         </header>
         <p class="no-indent">通过使用手机和电脑，我们的数据无时无刻不在被记录着。基于信息的记录者以及查看者，我们可以解读这些数据。以谷歌为例，它根据我们在其平台上的活动，创建了我们的数字版身份，即<em>数字身份</em>。根据这些数据，它为我们贴上标签，然后相应地调整我们在其搜索引擎和应用上看到的内容。它将我们推销给可能想要向我们推销的公司。</p>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>活动</strong></p>
              </header>
              <div class="textbox__content">
                   <p>访问你在谷歌、Facebook或Instagram上的“广告设置”配置文件。或者在你经常使用的其他平台上尝试找出它们是否有广告设置以及你是否可以访问它们。这些都是我们数字身份的一部分。</p>
                   <p>讨论问题：</p>
                   <ul>
                        <li>你的“数字身份”是什么样的？它是否反映了你的人口学信息和偏好？你认同这个身份吗？</li>
                        <li>你认为谷歌是如何确定这些偏好的？可能参考了哪些数据？这些偏好的类别会经常变化且是递归的：关联到你的广告偏好可以决定你下一次将被归类于哪种广告偏好。资料收集与分析能告诉我们什么？</li>
                        <li>你是否同意Cheney-Lippold和Bassett学者提出的身份过度简化观点？为什么这会属于伦理问题范畴？</li>
                        <li>从伦理上讲，你认为这些档案会“正确”或是“错误”地获取你的偏好重要吗？</li>
                        <li>你的性别和种族在你被标签化的过程中是否起作用？对此你有怎样的感受？</li>
                   </ul>
              </div>
         </div>
         <p class="no-indent">此活动改编自&#8217;<em><a href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/ https://mit-serc.pubpub.org/pub/identity-advertising-and-algorithmic-targeting">Identity, Advertising, and Algorithmic Targeting: Or How (Not) to Target Your “Ideal User.</a>&#8220;，根据<a href="https://creativecommons.org/licenses/by-nc/4.0/" target="_blank" rel="noopener" data-cke-saved-href="https://creativecommons.org/licenses/by-nc/4.0/">CC BY NC 4.0</a>许可。</em><sup>1</sup></p>
         <p class="indent">谷歌给我们的标签——男性、女性、年轻或年老，与我们的身份、需求或价值观无关。如果某人浏览某些网站（比如五金店）并购买某些物品<sup>2</sup>，他们可能被认定为男性。第二天，如果男性的活动或其他一百万人的活动促成了类似男性行为的改变，那么一个男性可能又会被认定为女性。不同的公司根据他们的兴趣赋予我们完全不同的身份。</p>
         <p class="indent">当我们的学生在与个性化学习软件互动并接受其提供的学习分析时，也会同样经历以上种种。这些系统视角下，他们的数字身份、表现、参与度和满意度之后不仅会被用来评估他们的表现，还会被用来评估他们的同伴、老师、学校和整个教育系统的表现<sup>3</sup>。</p>
         <p class="indent">为什么这会是一个问题呢？</p>
         <ol>
              <li style="font-weight: 400;text-align: justify">这些档案资料通常是基于混乱、不正确的、来自各种来源的数据所构建的，可能非常具有误导性<sup>4</sup>。</li>
              <li style="font-weight: 400;text-align: justify">这些数字身份可以改变学生对自己和他人的看法，老师对每个学生的看法，系统对每个老师的看法，社会对教育和教学法的看法，以及每个人对决策和反馈做出的反应<sup>3</sup>。</li>
              <li style="font-weight: 400;text-align: justify">然而，这些对关于某人是谁做出判断是在他们不知情和未经同意的情况下进行的：由无人能够访问的黑匣子做出。通常不存在对什么数据要被记录，何时何地被记录，以及如何基于它做出决策的控制<sup>4,</sup><sup>1</sup>。学生和老师丧失了他们的表达权和<a href="https://pressbooks.pub/aiforteachers/chapter/ai-aied-and-human-agency/" target="_blank" rel="noopener">人类自主权</a>。</li>
              <li style="font-weight: 400;text-align: justify">被记录的事件发生后很长一段时间内，这些数据和判断往往会作为存储的数据长期保留<sup>4</sup>。</li>
              <li style="font-weight: 400;text-align: justify">对指标的强调，其中学生、老师和员工不断被评估、比较和排名，引发的是焦虑和竞争等，而不是激励和成长<sup>3</sup>。</li>
              <li style="font-weight: 400;text-align: justify">教育可以被自动捕捉和自动分析，才能被赋予更多的重要性；它使我们最终获得的结果和做法可能不同于本来我们所考虑的。</li>
              <li style="font-weight: 400;text-align: justify">进行“数据化”的组织有权定义“什么是‘优质教育’——什么是一个好学生或一个高效的老师<sup>3</sup>”。</li>
         </ol>
         <p class="no-indent">以下是专家建议教师采取的对策：</p>
         <ol>
              <li style="font-weight: 400;text-align: justify"><strong>要考虑到人们的身份、完整性和尊严</strong>：“要尊重人们的内在价值，而不是将其视为数据或达到目的的手段”<sup>5</sup>。人们不仅仅是数据；软件可能给学生贴上标签，以个性化学习路径或将他们进行分组，这些都不是他们真正的身份<sup>5</sup>。</li>
              <li style="font-weight: 400;text-align: justify"><strong>具备数据素养</strong>：学习如何正确处理数据，了解不同基于数据的系统会做什么，如何做，它们推荐的使用方式是什么，以及如何去解读它们生成的信息和做出的决策。</li>
              <li style="font-weight: 400;text-align: justify"><strong>对AIED公司和软件持批判性态度</strong>。对它们的声明提出质疑，要求对其有效性和可靠性的证明，需要验证系统是否遵循您的机构和国家的伦理指南<sup>3</sup>。</li>
              <li style="font-weight: 400;text-align: justify"><strong>监控这些系统对你、你的学生、学生的学习和课堂氛围的影响</strong>。</li>
              <li style="font-weight: 400;text-align: justify"><strong>呼吁系统开放，给予你控制权和凌驾于系统自动决策的能力</strong>，在需要的时候，随时介入、澄清或操控。</li>
         </ol>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Kant, T., <em><a href="https://scalar.usc.edu/works/artificial-intelligence-for-teachers/ https://mit-serc.pubpub.org/pub/identity-advertising-and-algorithmic-targeting">Identity, Advertising, and Algorithmic Targeting: Or How (Not) to Target Your “Ideal User.<span class="s1">” </span></a></em>MIT Case Studies in Social and Ethical Responsibilities of Computing, 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Cheney-Lippold, J., <em>We Are Data: Algorithms and the Making of Our Digital Selves</em>, NYU Press, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Williamson, B., Bayne, S., Shay, S., T<em>he datafication of teaching in Higher Education: critical issues and perspectives</em>, Teaching in Higher Education, 25:4, 351-365, 2020.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Kelleher, J.D, Tierney, B, <em>Data Science</em>, MIT Press, London, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup><a href="https://education.ec.europa.eu/news/ethical-guidelines-on-the-use-of-artificial-intelligence-and-data-in-teaching-and-learning-for-educators"><em>Ethical guidelines on the use of artificial intelligence and data in teaching and learning for <span class="s1">educators</span></em></a>, European Commission, October 2022.</p>
         <p class="hanging-indent"></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-issues-with-data-bias-and-fairness" title="数据相关问题：偏见与公平">
         <header>
              <h1 class="chapter-title">数据相关问题：偏见与公平</h1>
              <p data-type="subtitle" class="chapter-number">20</p>
         </header>
         <p class="no-indent">偏见是对某个身份的偏见，无论是好还是坏，有意还是无意<sup>1</sup>。公平是对这种偏见的反驳：无论身份和处境如何，每个人都应受到公平对待。因此，必须制定并遵循明确的流程，以确保每个人都能受到公平对待，拥有平等的机会<sup>1</sup>。</p>
         <p>以人为本的系统往往包含大量的偏见和歧视。每个人都有自己独特的观点和偏见。这些系统也是黑匣子，其决策（例如如何对答卷进行评分）可能难以理解。但我们已经为此制定了战略并建立了相应的机制来对此类做法进行预警和质疑。</p>
         <p>自动化系统有时被誉为是人类主观性的万灵药：基于数字的算法，它们怎么可能会有偏见呢？基于有缺陷的数据，以及其他因素，算法不仅能够捕捉并学习到关于性别、种族、文化或残疾的现有偏见，它们还可以放大这些已存在的偏见<sup>1,2,3</sup>。即使它们不被专利壁垒所限制，它们也会因为缺乏可解释性而无法被追问其行为的原因。这一点在基于深度神经网络等某些系统中尤为明显。</p>
         <h3 style="text-align: left">AIED系统存在偏见的案例</h3>
         <ol>
              <li style="text-align: justify">当程序员编写基于规则的系统时，他们的个人偏见和刻板印象可能会体现在系统中<sup>1</sup>。</li>
              <li style="font-weight: 400;text-align: justify">基于数据的算法可能不会向女性建议基于STEM专业的职业道路，因为在STEM毕业生的数据库中女性学生较少。女性数学家数量较少，是因为现有的刻板印象和社会规范而导致的，还是由于女性的某种固有属性所导致的？算法无法对这两种情况进行区分。由于现有数据反映了当今的刻板印象，基于这些数据训练的算法也因此复制了现有的不平等和社会动态<sup>4</sup>。进一步的讲，如果实施这些建议，更多的女孩将选择非STEM科目，新的数据也将反映这一点，这就构成了一种自我实现的预言<sup>3</sup>。</li>
              <li style="text-align: justify">在训练数据集中，来自在数据上代表性不足的文化中的学生可能有不同的行为模式和不同的展示动机方式。学习分析会如何为他们计算指标呢？如果数据不能代表所有类别的学生，则根据该数据进行训练的系统可能会惩罚那些行为倾向不是该程序优化奖励的少数人群体。如果我们处理不当，学习算法就会根据多数文化进行泛化，导致对少数群体做出的分析具有很高的错误率<sup>4,5</sup>。这样的决定可能会打击那些能带来多样性、创造力和独特才能以及那些有不同经历、兴趣和动机的人<sup>2</sup>。</li>
              <li style="text-align: justify">一个英国学生被美国的作文批改软件评判。他们会因为自己的拼写错误而受到不利评判。对本来为另一个国家和另一个环境设计和训练的系统来说，处理本地的语言、拼写和口音的变化、当地地理和文化不同时总是很棘手。</li>
              <li style="text-align: justify">一些老师有意或由于社会联系产生的偏见而对在某个班级或地区常见的短语惩罚。如果论文评分软件基于这些老师评分的论文进行训练，它也会生成同样的偏见。</li>
              <li style="text-align: justify">机器学习系统需要一个<a href="https://pressbooks.pub/aiforteachers/chapter/the-flip-side-of-als-some-paradigms-to-take-note-of/" target="_blank" rel="noopener">目标变量和代理变量来进一步优化</a>。我们假设高中考试成绩是学业成绩的代表。该系统现在将进行专门训练，从而获取学生在考场压力和有限环境下表现良好的模式。当为学生推荐资源和练习题时，系统会促进学生提升考试成绩，而不是提升知识量。虽然这在当今的许多教室中可能也是如此，但传统方法至少可以支持多类目标<sup>4</sup>。</li>
              <li style="text-align: justify">自适应学习系统向学生建议资源，从而弥补技能或知识的缺陷。如果这些资源需要进行购买或需要家里有网络才能使用，那么对于那些无法遵循建议的学生来说是不公平的：<em>“当算法为学生给出提示、后续步骤或资源时，我们必须检查它提供的帮助是否公平，因为如果一个群体系统性地没有得到有用的帮助，这就是一种歧视”</em><sup>2</sup>。</li>
              <li style="text-align: justify">根据学生当前的知识水平和喜好进行个性化教育的概念本身可能构成偏见<sup>1</sup>。我们同时是不是也在阻止这个学生探索新的兴趣和选择？这是否会使他或她变得单一化，获取整体技能和知识的机会减少吗？</li>
         </ol>
         <figure id="attachment_638" aria-describedby="caption-attachment-638" style="width: 1024px" class="wp-caption aligncenter">
              <img class="wp-image-638 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch3-page6-bias-scaled-1.jpg" alt="" width="1024" height="724" />
              <figcaption id="caption-attachment-638" class="wp-caption-text">&#8220;&#8216;网络中的数据和算法偏见'&#8221; 由 jennychamux 授权 CC BY 2.0。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/2.0/?ref=openverse">https://creativecommons.org/licenses/by/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <h3 style="text-align: left">教师该如何减少AIED偏见带来的影响？</h3>
         <p class="no-indent">研究人员不断提出并分析过减少偏见的多种方法，但并非所有方法都易于实施。公平比减少偏见更难实现。</p>
         <p class="indent">例如，如果现有数据充满了刻板印象——&#8221;<em>我们是否有义务质疑数据，设计我们的系统使其符合某种公平行为的理念，不管这是否能得到当前可用数据的支持</em><em>？</em>&#8220;<sup>4</sup>。解决办法总是会有争议和反对，一些干预措施在减少一种偏见的同时可能引入另一种偏见！那么，教师对此能做些什么呢？</p>
         <ol>
              <li><strong>质疑卖家</strong> &#8211; 在订阅AIED系统之前，询问用于训练该系统的数据集的类型，它是在哪里、由谁、为谁设计和评估的。</li>
              <li><strong>投资于AIED系统时，不盲目接受指标</strong>。比如百分之五的总体准确率可能掩盖了模型对于少数群体表现不佳的事实<sup>4</sup>。</li>
              <li><strong>查看文档</strong> &#8211; 采取了哪些措施（如果有的话）来检测和对抗偏见并确保公平<sup>1</sup>？</li>
              <li><strong>了解开发者</strong> &#8211; 他们是否仅仅是计算机科学专家？教育研究人员和教师是否也参与其中了？系统是否仅仅基于机器学习，还是整合了学习理论和实践<sup>2</sup>？</li>
              <li><strong>优先选择透明和开放的学习者模型，这允许您修改决策</strong><sup>2</sup>。许多AIED模型具有灵活的设计，这使教师和学生可以监控系统，并可以要求解释或忽略机器的决定。</li>
              <li><strong>检查产品的可访问性</strong>。是否是每个人不论能力如何都能平等地访问它<sup>1</sup>？</li>
              <li><strong>注意使用技术的效果</strong>，了解长期或者短期会对学生产生的影响，并在必要时准备提供帮助。</li>
         </ol>
         <p class="no-indent">尽管AI技术存在问题，我们仍可以对AIED的未来持乐观态度：</p>
         <ul>
              <li>随着对这些主题认识的加深，检测和纠正偏见的方法也在正在研究和试验；</li>
              <li>基于规则和基于数据的系统可以揭示现有教育实践中隐藏的偏见。这样暴露出来的偏见可以随后得到处理；</li>
              <li style="text-align: justify">基于AI系统定制化的潜力，教育的许多方面也许都可以进行定制。资源可以对应学生的知识和经验。也许它们还可以整合本地社区和文化资产，以满足特定的本地需求<sup>2</sup>。</li>
         </ul>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup><a href="https://education.ec.europa.eu/news/ethical-guidelines-on-the-use-of-artificial-intelligence-and-data-in-teaching-and-learning-for-educators">Ethical guidelines on the use of artificial intelligence and data in teaching and learning for <span class="s1">educators</span></a>, European Commission, October 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup>U.S. Department of Education, Office of Educational Technology, <em>Artificial Intelligence and Future of Teaching and Learning: Insights and Recommendations</em>, Washington, DC, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup>Kelleher, J.D, Tierney, B., Data Science, <em>MIT Press</em>, London, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup><em><span class="s1">Barocas, S., Hardt, M., Narayanan, A., </span><a href="https://fairmlbook.org/">Fairness and machine learning Limitations and <span class="s2">Opportunities</span></a>, MIT Press, 2023.</em></p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Milano, S., Taddeo, M., Floridi, L., Recommender systems and their ethical challenges, AI &amp; Soc 35, 957–967, 2020.</p>
    </section>
</div>
<div data-type="part" class="part" id="part-listening-speaking-and-writing">
    <header>
         <h1 class="part-title">听、说与写</h1>
         <p data-type="subtitle" class="part-number">IV</p>
    </header>
    <p class="no-indent">我们是否都惊讶于婴儿学习母语的速度？在最初的快速发展之后，往往需要家人、朋友、老师和陌生人的终生投入来完善这种语言。</p>
    <p class="indent">通过不断的听、说、读、写，可以说，语言随着婴儿的成熟而成长。 这种个人成长很难从个体扩展到一个课堂。 就外语而言，就更难了。</p>
    <p class="indent"><em>老师该如何分配时间与每个学生交谈和纠错，以简化这个过程？</em></p>
    <p class="indent"><em>如果想要AI为个性化学习提供帮助，语言学习难道不是展示其能力的好地方吗？</em></p>
    <section data-type="chapter" class="chapter" id="chapter-translators" title="翻译">
         <header>
              <h1 class="chapter-title">翻译</h1>
              <p data-type="subtitle" class="chapter-number">21</p>
         </header>
         <p class="no-indent">        现如今，在线自动翻译工具已广泛使用，可以轻松翻译多种语言。其中一些翻译工具（如Google Translate）是由互联网巨头开发的，但也有独立的专业工具，例如DeepL。</p>
         <p class="indent">从历史上看，自动翻译始终是人工智能技术发展面临的挑战之一。当对照文本（不同语言版本的同一文本）数据集可用时，基于规则的系统（由专家构建的规则）会被基于统计的机器学习技术所取代。在过去几年中，深度学习技术已成为最先进的技术。</p>
         <p class="indent">几年前，您或许还曾体验过自动翻译工具所带来的乐趣，比如在翻译歌曲或菜单时，它们会给出令人捧腹的译文。然而，时至今日情况已然不同：</p>
         <ul>
              <li>国际性的机构已经着眼于利用自动翻译工具支持多种语言间的沟通；</li>
              <li>大型媒体视频平台也倾向于使用自动翻译，而非人工翻译，以拓宽其受众范围；</li>
              <li>在日常生活和专业领域内，双语人士和翻译专家似乎也都越来越依赖这些工具。</li>
         </ul>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center">发现更多！</p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/some-automatic-translation-vocabulary/" target="_blank" rel="noopener">一些与自动翻译相关的术语</a>
              </div>
         </div>
         <p class="no-indent">      此外，技术的改进仍在持续进行中。翻译的质量在不断提升，将翻译、转录和语音合成相结合，实现无缝多语言交流的解决方案也即将广泛推广。此外，改进仍在继续。翻译质量在不断提高，将翻译与转录和语音合成相结合，并允许无缝多语言交流的解决方案很快也会普及。</p>
         <p class="indent">值得一提的是，即使这些工具并非为教育设计，但它们已然对教育领域产生了深远的影响。</p>
         <h3 style="text-align: left">学生是否在使用自动翻译？</h3>
         <figure id="attachment_404" aria-describedby="caption-attachment-404" style="width: 348px" class="wp-caption alignright">
              <img class="wp-image-404" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch5-page-1-Translation-scaled-1.jpg" alt="" width="348" height="231" />
              <figcaption id="caption-attachment-404" class="wp-caption-text">“不可能的翻译” 由 giopuo 创作，根据 CC BY-NC-SA 2.0 许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse.</a></figcaption>
         </figure>
         <p class="no-indent">        据我们所知，截至今日（2022年12月），没有公开的官方文件或大规模调查来评估这是否是一个问题。在一些论坛<sup>3</sup>和文章中，有讨论提到避免人工智能作弊的可能方法，或者提出过将人工智能引入外语课程的建议。他们大都认为，学生正在普遍使用自动翻译工具。</p>
         <p class="indent">我们在2022年4月进行了一项小型非正式调查，调查对象是使用不同种语言（英语、法语、德语）的教师，他们的技能水平也不同。他们面向的是12-16岁学生的班级。调查在巴黎地区进行，学生和教师都是法国人。结果显示，教师们都遇到了学生一旦离开教室就会使用DeepL或谷歌翻译的情况。</p>
         <p class="indent">以下是我们收到的一些评论：</p>
         <ul>
              <li style="text-align: justify">学生似乎唯一掌握的技能就是复制、粘贴。</li>
              <li style="text-align: justify">即使是成绩更好、更有学习动力的学生也会这样做——他们虽然会尝试自己完成家庭作业，但之后就会用自动翻译工具检查。通常，他们会发现自动翻译的结果比自己的要好得多，于是便保留了机器生成的解决方案。</li>
              <li style="text-align: justify">还有动机的问题，学生们对学习语言的用途提出质疑。</li>
         </ul>
         <p class="no-indent">     上述分析需要开展进一步调查。在不同国家进行广泛的调查会更有帮助。与此同时，与各方利益相关者的讨论使我们能够对以下内容进行思考：</p>
         <ul>
              <li>教师不再能够布置翻译文本的家庭作业。即使是更具创造性的练习，例如就特定主题写一篇论文，也可能导致学生使用自动翻译工具的情况发生——他们可以用自己的语言写论文，然后翻译。</li>
              <li>动机问题至关重要。这不是一个新问题——在2000年，作者和教育工作者争论说，“有些人认为追求外语能力是值得赞扬的努力；但也有人可能认为如果有有效的替代方案存在，这就不再必要”<sup>5</sup>。</li>
         </ul>
         <p>我们的观察结果与论坛或文献所报告的反应相一致<sup>4</sup>。</p>
         <h3 style="text-align: left">自动翻译器能欺骗老师吗？</h3>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center">发现更多！</p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/ai-technology-is-moving-fast/" target="_blank" rel="noopener">AI技术的飞速发展</a>
              </div>
         </div>
         <p class="no-indent">       博客文章似乎表明，即使在后期进行人工校正，教授语言的教师也能识别出自动翻译：Birdsell<sup>1</sup> 设想了一个任务，让日本学生用英语写一篇500字的论文。其中，一些学生必须直接用英文写，写的时候使用常用且可以接受的工具（词典、拼写检查器），而其他学生用日语写，然后使用DeepL将其翻译成英语。有趣的是，他发现老师会给第二组学生更高的分数，但同时也能识别出那些借助DeepL写作的论文。</p>
         <h3 style="text-align: left">机器翻译工具能与文本生成器结合使用吗？</h3>
         <p class="no-indent">        预测事态未来发展的方向还为时尚早，但目前的答案是肯定的。举一个简单的例子，法国的记者使用文本生成器工具（Open-AI playground）来生成一些文本，然后在其之上运行DeepL，他在向社区展示这篇文本时感觉很自在<sup>2</sup>。</p>
         <h3 style="text-align: left">使用自动翻译器是在作弊吗？</h3>
         <p class="no-indent">        这是一个难以回答的问题。当你在互联网<span style="color: #000000">论坛</span><sup>3</sup>上咨询时，你很容易被说服认为这是作弊。学生被告知不要使用这些工具，否则将被指控作弊。但也可以从另一个角度提出论点，教育是教导人们如何灵活使用工具完成任务。那么，为什么不让学生学会使用学校之外的工具呢？</p>
         <p class="indent">本书没有被授权提供最终答案，但我们诚心建议教师对这些工具在学习语言中的使用方式做进一步的探索。</p>
         <h3 style="text-align: left">教师应该如何做？</h3>
         <p class="">      Florencia Henshaw提出了一些观点<sup>4</sup>，但仍有待深入探讨：</p>
         <ul>
              <li>宣称AI并无实际效用（这种立场在论坛中受到一定的支持），却难以完全说服人。因为即便学生们对此表示认同，他们仍然倾向于使用这些AI工具。</li>
              <li>采取零容忍政策是建立在能够有效检测AI使用的基础之上的。今天可能如此<sup>1</sup>，但是否会一直如此还不确定。此外，使用AI属于作弊吗？这与使用眼镜来更好地阅读，或使用独轮车来运输物品有何不同？</li>
              <li>部分使用工具的方法（例如用来查找个别单词）也受到了批评<sup>4</sup>。自动翻译工具之所以有效，是因为它们参考利用了翻译对象的上下文。对于个别（脱离上下文的）单词，它们的表现不如词典。</li>
              <li>在课堂内外以智能方式使用该工具的方法很诱人，但需要做更多的工作来开发对学习情境有真正帮助的活动。</li>
         </ul>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Birdsell, B. J., <em>Student Writings with DeepL: Teacher Evaluations and Implications for Teaching</em>, JALT2021 Reflections &amp; new perspectives 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Calixte, L, November 2022, <a href="https://etudiant.lefigaro.fr/article/quand-l-intelligence-artificielle-facilite-la-fraude-universitaire_463c8b8c-5459-11ed-9fee-7d1d86f23c33/" target="_blank" rel="noopener" data-cke-saved-href="https://etudiant.lefigaro.fr/article/quand-l-intelligence-artificielle-facilite-la-fraude-universitaire_463c8b8c-5459-11ed-9fee-7d1d86f23c33/">https://etudiant.lefigaro.fr/article/quand-l-intelligence-artificielle-facilite-la-fraude-universitaire_463c8b8c-5459-11ed-9fee-7d1d86f23c33/.</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup>Reddit discussion on automatic translation and cheating. <a href="https://www.reddit.com/r/Professors/comments/p1cjiu/foreign_language_teachers_how_do_you_deal_with/" target="_blank" rel="noopener" data-cke-saved-href="https://www.reddit.com/r/Professors/comments/p1cjiu/foreign_language_teachers_how_do_you_deal_with/">https://www.reddit.com/r/Professors/comments/p1cjiu/foreign_language_teachers_how_do_you_deal_with/.</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>4</sup> Henshaw, F. <em>Online Translators in Language Classes: Pedagogical and Practical Considerations</em>, The FLT MAG, 2020, <a href="https://fltmag.com/online-translators-pedagogical-practical-considerations/" target="_blank" rel="noopener" data-cke-saved-href="https://fltmag.com/online-translators-pedagogical-practical-considerations/">https://fltmag.com/online-translators-pedagogical-practical-considerations/.</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>5</sup> Cribb, V. M. (2000). <em>Machine translation: The alternative for the 21st century?</em> TESOL Quarterly, 34(3), 560-569. <a href="https://doi.org/10.2307/3587744" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.2307/3587744">https://doi.org/10.2307/3587744.</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-writing-with-ai" title="使用AI写作">
         <header>
              <h1 class="chapter-title">使用AI写作</h1>
              <p data-type="subtitle" class="chapter-number">22</p>
         </header>
         <h2 class="chapter-author">Giuseppe Città 和 Manuel Gentile</h2>
         <p class="no-indent">         我们长期以来习惯于在计算机上使用文字软件（例如 Microsoft Word、Google Docs、Pages、LibreOffice）进行写作，采纳这些工具提供的语法建议并获益。 如果有人认为，这些工具从未使您避免犯下明显的错误，请举手。🙂</p>
         <p class="indent">但是，这些工具引起的转变不局限于仅仅纠正一些打字错误；它还唤起了一种完全不同的写作方式，产生了更为深远的影响。数字写作使我们能够重现曾经写的内容，并对此进行修改，能更有效地表达我们想要传达的内容。</p>
         <p class="indent">用更具技术性的术语来讲，我们已经从线性写作转变为采用迭代的方式。根据近期的研究，数字工具为写作过程带来的转变提高了生成文本的质量。</p>
         <h3 style="text-align: left">AI时代下的写作</h3>
         <p class="no-indent">        无论如何，写作及相关思维形式的进化过程并未停止。近年来，随着AI的爆炸式增长，这一进程显著加速。Grammarly、Wordtune、Ludwig、ProWritingAid等工具的设计不仅仅是为了文本的语法校正，它们在整个写作过程中支持着用户，通过激发写作风格的改进、查重等来支持用户。</p>
         <p class="indent">认识到学校如何做，都不可能避免受此类创新的影响，是远远不够的。文献中提到越来越多的旨在利用此类软件的教育干预措施，证实了这一点。一些学者提议，有必要使用这些工具来培养学生利用外部信息来源的能力，发展正确的释义技能，从而避免抄袭问题。许多类似的工具可以支持教师来评估学生创作的文本，及时分析每个学生的优点和缺点。此外，这些工具可以让学生自己评估写作能力，从而增进元认知过程并加速学习。</p>
         <h3 style="text-align: left">并非所有闪光的都是金子……</h3>
         <p class="no-indent">        显然，这些创新存在潜在问题。首先，你可能已经理解了所有这些深度学习机制的基础是构建模型的源数据。有限的或不正确的训练数据可能会导致偏见。此外，这些工具所产生/预期的文本可能普遍同质化。这可能会导致学生创造水平受到相应的限制（或在评估的情况下受到惩罚）。最后，这些工具主要处理英语语言；因此，非英语语境的使用可能要差很多。话虽如此，由于创新的速度很快，我们很快也会看到类似的其他语言的工具出现。</p>
         <h3 style="text-align: left">展望未来</h3>
         <p class="no-indent">       与写作过程相关的主要认知过程之一，是从长时记忆中检索我们想要表达内容所必需的信息。由此可以轻易地推测，这些工具将如何通过即时、简化地访问比我们自己的记忆更广泛的“记忆”来支持这一过程。</p>
         <p class="indent">最后，文本生成过程的巨大进步为我们指引了一个未来，在这个未来中，这些工具可以以更加积极的形式支持写作过程。</p>
         <p class="indent">我们的文本写作可能会以现在还无法想象的方式进一步改变。然而，挑战将始终保持不变——知道如何清楚地使用我们手上的工具，并相应地调整我们的教学方式。你准备好了吗？</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-deep-neural-networks" title="AI说（AI-Speak）：深度神经网络">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：深度神经网络</h1>
              <p data-type="subtitle" class="chapter-number">23</p>
         </header>
         <h3 style="text-align: left">机器学习走向深度</h3>
         <p class="no-indent">        人类的知识广泛多变，本质上难以捕捉。正如乔姆斯基所说，人类的大脑之所以能够吸收和处理知识，是因为它是一个“极为高效甚至优雅的系统，只需要少量的信息即可运作；它寻求的不是推断数据点之间的粗暴关联（brute correlations)，而是创造解释<sup>1</sup>。”</p>
         <p class="indent">机器学习是通过在大量数据中找到模式来实现这一点。但在此之前，专家和程序员必须坐下来编写与当前问题相关的数据特征，并将这些特征作为“参数”<sup>2,3</sup>输入给机器。正如我们之前所见，系统的性能在很大程度上取决于数据和参数的质量，而数据和参数的质量并不总是可以直接确定。</p>
         <p class="indent">深度神经网络或深度学习是机器学习的一个分支，旨在通过以下方式克服这一问题：</p>
         <ul>
              <li>在训练阶段从数据中提取其自身的参数；</li>
              <li>使用多层来构建参数之间的关系，从最外层的简单表示逐渐过渡到更复杂和抽象的表示。这使得它能够比传统的机器学习算法更好地完成某些事<sup>2</sup>。</li>
         </ul>
         <p class="no-indent">       大多数强大的机器学习应用越来越多地使用深度学习。其中包括我们在本书中介绍的搜索引擎、推荐系统、语音转录和翻译。可以毫不夸张地说，深度学习推动了人工智能在多项任务中的成功。</p>
         <figure id="attachment_907" aria-describedby="caption-attachment-907" style="width: 575px" class="wp-caption aligncenter">
              <img class="wp-image-907" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/5.1.png" alt="" width="575" height="482" />
              <figcaption id="caption-attachment-907" class="wp-caption-text">来源 : Goodfellow, I.J., Bengio, Y., Courville, A., Deep Learning, MIT Press, 2016.</figcaption>
         </figure>
         <p class="no-indent">        “深度”指的是层次如何堆叠在彼此之上去创建网络。“神经”反映了设计的某些方面受到生物大脑的启发。尽管如此，它们为我们自己的思维过程提供了一些见解，但这些都是严格的数学模型，与任何生物部分或过程都不相似<sup>2</sup>。</p>
         <h3 style="text-align: left">深度学习的基础</h3>
         <p class="no-indent">        当人类看照片时，我们会自动识别出对象和面孔。但对于算法来说，照片只是像素的集合。从混乱的颜色和亮度到人脸识别，这是一个过于复杂而难以执行的转变。</p>
         <p class="indent">深度学习通过将过程分解为第一层中的简单表示来实现这一点——例如，通过对比相邻像素的亮度来记录图像各个区域中边缘的存在或缺失。第二层采用边缘集合来搜索更复杂的实体——例如角和轮廓，忽略边缘位置的微小变化<sup>2,3</sup>。第三层利用轮廓和角来寻找部分对象。慢慢地，复杂性逐渐提升，直到最后一层能够足够好地组合不同的部分以识别面孔或识别对象。</p>
         <p><img class="aligncenter wp-image-908" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/5.2.png" alt="" width="499" height="418" /></p>
         <p class="no-indent">        在每一层中，并不是由程序员来指定需要考虑什么，而是在训练过程中从数据中学习得到的<sup>3</sup>。通过将这些预测与训练数据集中的实际输出进行对比测试，以略微不同的方式调整每一层的功能，从而每次能获得更好的结果。如果一切运行正确，并且有足够的高质量数据，网络应该发展成能忽略照片中不相关的部分，例如实体的具体位置、角度和光线，并将那些使实体能被识别出的部分归零。</p>
         <p class="indent">值得注意的是，尽管我们使用边缘和轮廓来理解过程，但实际上在每层中展现的却是一组数字，这些数字可能与我们理解的事物相对应，也可能不对应。不变的是抽象性和复杂性的增加。</p>
         <h3 style="text-align: left">网络设计</h3>
         <p class="no-indent">        一旦程序员决定使用深度学习来处理任务并<a href="https://pressbooks.pub/aiforteachers/chapter/ai-speak-data-based-systems-part-2/" target="_blank" rel="noopener">准备数据</a>，他们必须设计所谓的神经网络架构。他们必须选择层数（网络的深度）和每层的参数数量（网络的宽度）。接下来，他们必须决定如何在层与层之间建立连接——是否将每一层的每个单元都与前一层的每个单元相连接。</p>
         <p class="indent">通过实验通常可以找到给定任务的理想架构。层数越多，每层需要的参数就越少，网络在处理一般数据时表现得更好，但优化起来就更困难。连接较少意味着参数较少、计算量也较少，但同时也减少了网络的灵活性<sup>2</sup>。</p>
         <h3 style="text-align: left">网络训练</h3>
         <p class="no-indent">       让我们以一个进行监督学习的前馈神经网络为例。在这里，信息从一层向更深的层前进，没有循环的反馈。对于所有机器学习技术来说，目标在于找出输入与输出之间的连接——哪些参数结合在一起，以及它们如何结合在一起以产生观察到的结果。我们假设一个连接输入x与输出y的关系f，然后使用网络找到一组参数θ，这些参数为预测输出和实际输出提供最佳匹配。</p>
         <div class="textbox">
              <p style="text-align: center">关键问题：预测的y=f (x, θ)，对于哪个θ？</p>
         </div>
         <p class="no-indent">        这里y的预测是最终产品，数据集x是输入。在面部识别中，x通常是图像中的像素集，y可以是人的名字。在网络中，各层就像装配线上的工人，每个工人处理给定的任务并将其传递给下一个工人。在装配线上，第一个“工人”接收输入并进行略微转换，然后交给第二个。第二个继续做同样的事情后传递给第三个，依此类推，直到输入被转换为最终产品。</p>
         <p class="indent">在数学上，函数f被分解为许多函数f1, f2, f3&#8230; 其中f= &#8230;.f3(f2(f1(x)))。靠近输入的层使用f1进行计算转换输入参数，下一层使用f2计算，依此类推。在这过程中，程序员可能会介入，根据他们对问题的了解程度来帮助选择正确的函数族。</p>
         <p>&nbsp;</p>
         <p><img class="aligncenter wp-image-909" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/5.3.png" alt="" width="500" height="419" /></p>
         <p class="no-indent">        每一层的工作是对重要性的等级进行分配——赋予其接收的每个参数的权重。这些权重就像最终定义该层中预测输出和输入之间的关系的旋钮<sup>3</sup>。在典型的深度学习系统中，我们正在研究数亿个这样的旋钮和数亿个训练示例。由于我们既没有定义也无法在输入和输出之间的层中看到输出和权重，这些也因此被称为隐藏层。</p>
         <p class="indent">在上面讨论的对象识别示例中，第一个工人的工作是检测边缘并将其传递给第二个工人，后者检测轮廓等等。</p>
         <p class="indent">在训练过程中，将预测输出与实际输出进行比较。如果两者之间有很大差异，则必须大幅更改每一层分配的权重。如果没有较大差异，则只需要进行略微的更改。这项工作分为两部分。首先是计算预测和输出之间的差异。然后，另一个算法计算如何更改每一层的权重，由输出层开始，在这种情况下，信息从更深的层向后流动。因此，在训练过程结束时，网络已经准备好了其权重和函数来处理测试数据。其余的过程与传统机器学习相同。</p>
         <p>&nbsp;</p>
         <p><img class="alignnone wp-image-1060" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-300x155.jpg" alt="" width="370" height="191" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-300x155.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-1024x529.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-768x397.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-65x34.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-225x116.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533-350x181.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240823171533.jpg 1326w" sizes="(max-width: 370px) 100vw, 370px" /></p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup>Chomsky, N., Roberts, I., Watumull, J., <em>Noam Chomsky: The False Promise of ChatGPT</em>, The New York Times, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup>Goodfellow, I.J., Bengio, Y., Courville, A., <em>Deep Learning</em>, MIT Press, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup>LeCun, Y., Bengio, Y., Hinton, G., <em>Deep learning</em>, Nature 521 521, 436–444 (2015).</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-slug-415" title="AI说（AI-Speak）：自然语言处理">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：自然语言处理</h1>
              <p data-type="subtitle" class="chapter-number">24</p>
         </header>
         <p class="no-indent">        过去 50 年来，自然语言处理（NLP）一直是人们长期研究的课题。 这促成了我们日常使用的许多工具的开发：</p>
         <ul>
              <li>文字处理器</li>
              <li>自动语法和拼写校正</li>
              <li>自动补齐</li>
              <li><a href="https://pressbooks.pub/aiforteachers/chapter/optical-character-recognition/" target="_blank" rel="noopener">光学字符识别（OCR）</a></li>
         </ul>
         <p class="no-indent">       最近，聊天机器人、家庭助理和自动翻译工具在各个领域产生了巨大影响。</p>
         <figure id="attachment_414" aria-describedby="caption-attachment-414" style="width: 394px" class="wp-caption alignleft">
              <img class="wp-image-414" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch5-page-3-sign-language-scaled-1.jpg" alt="" width="394" height="263" />
              <figcaption id="caption-attachment-414" class="wp-caption-text">“手语学习” 由 daveynin 拍摄，根据 CC BY 2.0 许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/2.0/?ref=openverse">https://creativecommons.org/licenses/by/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="indent">长时间以来，研究和产业因语言的内在复杂性而停滞不前。20世纪末，由专家编写的某种语言语法可能多达50,000条规则。这些<strong>专家系统</strong>表明，技术可以带来变革，但成熟强大的解决方案开发起来过于复杂。</p>
         <p class="indent">另一方面，<strong>语音识别</strong>需要能够利用声学数据并将其转换为文本。鉴于可能遇到众多种类的发言者，这确实是一项艰巨的任务！</p>
         <p class="indent">研究人员明白，如果我们有了目标语言的模型，事情会变得更容易。如果我们知道语言的词汇以及句子是如何形成的，那么就可以轻易地从一组候选句子中找到与给定话语相匹配正确的句子，或者从一组可能的单词序列中生成有效的翻译。</p>
         <p class="indent">另一个关键方面是<strong>语义</strong>。我们为解决语言问题所做的大部分工作都是肤浅的。算法将根据一些本地语法规则产生答案。如果最终文本毫无意义，那便就此作罢。当我们阅读一些学生的文本时，可能会发生类似的情况——我们可以在没有真正理解课文内容的情况下就能纠正错误！将意义与文本关联起来，可能的话还要与口头句子关联，这是一个真正的挑战。</p>
         <p><a href="https://www.bilibili.com/video/BV1Yx4y1E7MA/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 编辑距离 (Edit distance)</a></p>
         <p class="no-indent">        2008年有一个令人惊讶的结果<sup>1</sup>。一个独特的<strong>语言模型</strong>可以从大量数据中学习并用于各种语言任务。事实上，这个独特的模型的表现优于为特定任务训练的模型。</p>
         <p class="indent">该模型是一个<a href="https://pressbooks.pub/aiforteachers/chapter/deep-neural-networks/" target="_blank" rel="noopener">深度神经网络</a>。但深度远不如今天使用的模型，却足以让研究界和产业界相信，机器学习，更具体地说，深度学习将成为NLP许多问题的答案。</p>
         <p class="indent">从那时起，自然语言处理不再遵循模型驱动的方法，而几乎都是基于数据驱动的方法。</p>
         <p>&nbsp;</p>
         <p class="indent">传统上，主要的语言任务可以分解为两类 &#8211; 模型构建任务和解码任务。</p>
         <h3 style="text-align: left">模型构建</h3>
         <p class="no-indent">       为了可以转录、回答问题、生成对话或翻译，你需要能够知道“Je parle Français”是否确实是法语句子。就像口语一样，人们并不总是准确遵循语法规则，所以上述问题的答案必定是概率性的。一个句子可以<em>或多或少</em>是法语。这允许系统产生不同的候选句子（作为声音的转录或句子的翻译），并为每个候选句子的概率进行打分。我们可以得出分数最高的句子，或者将分数与其他信息源结合（我们可能还对句子的内容感兴趣）。</p>
         <p class="indent">语言模型可以做到这一点，概率是根据机器学习算法构建的。当然，数据越多越好。对于某些语言，有大量数据可以用来构建语言模型。对于其他语言，情况并非如此，通常是资源不足的语言。</p>
         <p class="indent">在翻译的情况下，我们希望不是两个而是三个模型：每种语言的一个语言模型，以及另一个翻译模型，告诉我们语言片段的更好翻译可以是什么。当数据稀缺时，这些模型难以形成。如果为常见的语言对构建模型更容易，那么对于不常一起使用的语言（如葡萄牙语和斯洛文尼亚语）则不是这样。一种典型的解决方法是使用<em>中枢语言</em>（通常是英语）进行翻译——从葡萄牙语翻译成英语，然后从英语翻译成斯洛文尼亚语。随着错误的累积，这将导致较差的结果。</p>
         <h3 style="text-align: left">解码</h3>
         <p class="no-indent">       解码是算法获取输入序列（可以是信号或文本）并通过查阅模型做出决策的过程。该决策通常是输出文本。这里有一些算法考虑——在许多情况下，转录和翻译需要实时发生，减少时间延迟是一个关键问题。所以，AI对此还有很大的发展空间。</p>
         <h3 style="text-align: left">端到端</h3>
         <p class="no-indent">        如今，分别构建组件并稍后组合的方法已被<em>端到端方法</em>所取代。在这种方法中，系统将通过一个独特的模型来转录/翻译/解释输入。目前，这样的模型是通过深度神经网络训练的，这些网络非常的庞大。据报道，当前最大的GPT3模型包含上亿个参数！</p>
         <figure id="attachment_911" aria-describedby="caption-attachment-911" style="width: 357px" class="wp-caption alignleft">
              <img class="wp-image-911" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/5.png" alt="" width="357" height="266" />
              <figcaption id="caption-attachment-911" class="wp-caption-text">Chervinskii，维基共享资源，根据 CC BY-SA 4.0 许可证授权。要查看此许可证的副本，请访问 https://creativecommons.org/licenses/by/2.0/?ref=openverse。</figcaption>
         </figure>
         <p class="indent">让我们试着理解这个过程背后的直觉。假设我们有一些数据，这些原始数据可以以某种方式进行编码。但编码可能是冗余的，甚至可能是昂贵的。现在再让我们构建一个特定的机器，称之为自动编码器（见左图）。这台机器将能够接收文本，将其压缩成一个小向量（这是编码器部分），然后解压缩向量（解码器部分），并得出一个与原始文本在某种程度上接近的文本。这个机制的想法是使中间向量具有意义，拥有两个理想属性——一个相对较小的向量，“包含”了初始文本中的信息。</p>
         <h3 style="text-align: left">未来</h3>
         <p class="no-indent">可能很快就会推出的端到端过程的例子，将具有执行以下任务的能力——它将听到您说的语言，转录您的文本，将其翻译成您不知道的语言，训练语音合成系统根据您的声音，用您自己的声音说出新句子中的相应文本。这里有两个由西班牙瓦伦西亚理工大学的研究人员制作的视频示例，视频中使用了说话者自己的声音模型来进行配音。</p>
         <p><a href="https://www.bilibili.com/video/BV1ew4m1q782/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 博士答辩演示 4：零样本扬声器的开放教育资源录音应用 (Zero-shot Speaker Adaptation for OER dubbing)</a></p>
         <p><a href="https://www.bilibili.com/video/BV1cT421i7A5/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 博士答辩演示 1：瓦伦西亚理工大学的跨语言语音克隆 (Cross-lingual Voice Cloning at UPV)</a></p>
         <h3 style="text-align: left">对教育的一些影响</h3>
         <p class="no-indent">       自然语言处理的稳步进展引人注目。十年前，我们还会嘲笑AI给出的翻译。但今天，我们越来越难以发现明显的错误。语音识别和字符识别技术也在快速改进。</p>
         <p class="indent">语义挑战仍然存在，回答需要深入理解文本的问题仍然不太正确。但事情正在朝着正确的方向发展。这意味着教师们如下的期待很快就会成为现实的，如果它们还没有实现！</p>
         <ul>
              <li>一个学生将拿到一个复杂的文本并（通过AI）获得一个简化版本；文本甚至可以是个性化的，并使用学生习惯的术语、词汇和概念；</li>
              <li>一个学生将能够找到一个文本并复制它，获得一个内容相同但无法被防抄袭工具检测到的文本；</li>
              <li>世界各地制作的视频都可以通过自动配音以各种语言来进行观看。这意味着我们的学生将除了接触到用我们的语言制作的学习材料，也将接触到最初为其他文化中的学习系统所设计的材料；</li>
              <li>写论文或作文可能会成为过去，因为工具将可以就任何主题进行写作。</li>
         </ul>
         <p class="no-indent">      很明显，人工智能还远远称不上完美。专家会发现，即使语言正确，思想的流动也会出现问题。但让我们面对现实吧，在教育过程中，我们的学生要多长时间才能达到这样的水平？</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Collobert, Ronan, and Jason Weston. <em>A unified architecture for natural language processing: Deep neural networks with multitask learning</em>. Proceedings of the 25th international conference on COLIN DE LA HIGUERA AND JOTSNA IYER Machine learning. 2008. <a href="http://machinelearning.org/archive/icml2008/papers/391.pdf" target="_blank" rel="noopener" data-cke-saved-href="http://machinelearning.org/archive/icml2008/papers/391.pdf">http://machinelearning.org/archive/icml2008/papers/391.pdf</a>. 注意：此文献引用是出于历史原因而给出的。但读起来很难！</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-aied-and-human-agency" title="AI、AIED与人类能动性">
         <header>
              <h1 class="chapter-title">AI、AIED与人类能动性</h1>
              <p data-type="subtitle" class="chapter-number">25</p>
         </header>
         <h2 class="chapter-author">Wayne Holmes</h2>
         <p class="no-indent">        人工智能（AI）经常被指控威胁人类的能动性（参见在<a href="https://www.pewresearch.org/internet/2018/12/10/artificial-intelligence-and-the-future-of-humans/" target="_blank" rel="noopener">人工智能与人类的未来<sup>1</sup></a>中报告的979位“专家”的观点摘要）。这在教育中应用AI（AIED）时尤其如此，包括我自己的研究。例如，在<a href="https://rm.coe.int/artificial-intelligence-and-education-a-critical-view-through-the-lens/1680a886bd" target="_blank" rel="noopener">欧盟委员会的报告</a>中，我们写道，几乎所有AIED工具采用的方法都是“优先考虑记忆而非思考，优先了解事实而非批判性参与，从而破坏了学习者的能动性和稳健的学习”<sup>2</sup>。然而，虽然这样的说法很容易提出，而且我也支持这一点，但很少有人能适当地解释它们。因此，这就是这篇简短论述的意图：探讨“人类能动性”到底是什么意思，以及考虑AI和AIED的影响。</p>
         <p class="indent">广义上讲，人类能动性是个体独立行动的能力，基于自己的信念、价值观和目标在不同选项中做出选择。换句话说，它是人类做出决定，发起并实施影响其生活和周围世界的行动的能力。它可以涉及多个维度，包括意图性（有特定目标或目的地有意识地行动）、自主性（独立、自我决定、以及能做出反映自己偏好、价值观和目标的选择和决定的自由）、适应性（学习、改变行为并成功应对不断变化的环境的能力）和责任性（伦理和道德维度的能动性——对自己的决定和行为的后果负责）。</p>
         <p class="indent">人类能动性对于个人成长和成功的生活，至关重要。它使个体能够掌握自己的生活，并影响周围的世界。它培养了一种控制感和自我效能感，并与更高水平的心理福祉相关联。当个体感到他们能够控制自己的生活，并做出有意义的选择，换句话说，当他们感到他们拥有真正的能动性时，他们更有可能体验到满足和成就感。正如一位研究人类能动性的知名学者的解释：“除非人们相信他们的行动可以产生期望的效果，否则他们几乎没有开展行动或面对困难坚持下去的动力。”<sup>3</sup>。</p>
         <p class="indent">在教育背景下，人类能动性指的是学生和教师做出选择、自主行动以及在课堂情境中掌控教学和学习的能力。重点是，个体在塑造教育过程、决定学习什么、如何学习以及为什么学习时的作用。教育背景下的人类能动性涉及多个考虑因素。例如，当学生不应被视为知识的被动接受者，而被视为学习过程中的积极参与者，并且有自主权去探索感兴趣的话题、提出问题、确定和设定自己的学术目标以及对自己的学习负责时，学生的能动性可以得到增强。增强学生能动性，还包含促进解决问题和批判性思维技能（围绕现实世界问题），以及自我调节技能（如时间管理、任务设定优先级和自我监控进度），所有这些对于培养独立和自我导向的个体、以及学术和终身成功都是宝贵的。最后，虽然教师在支持和增强学生能动性方面发挥着核心作用，但教育背景中的人类能动性还包括教师自身的能动性，承认他们的学科、教学专业知识、专业性，使他们能够做出最佳的教学决策支持他们的学生。</p>
         <p class="indent">下一个问题是，AI对人类能动性的影响是什么？每个潜在的影响都有积极和消极的一面。例如，一些AI技术可以承担重复性任务，也许可以使人们专注于工作中更具创造性的方面，让他们决定如何最好地分配自己的时间和精力，从而增强能动性。另一方面，使用AI技术来执行常见任务，可能导致人类丧失某些技能或专业知识。随着时间的推移，随着他们越来越依赖AI，这反而可能减少个体可用的选择，从而削弱他们的能动性。同样，经常有人认为，AI赋能技术可以做出个性化用户与个性化服务（如在线视频和购物平台）的互动，提供根据他们的偏好量身定制的建议，从而增强他们的能动性。然而，用更加批判的眼光看，这种服务提供的个性化通常更多地符合提供者及其广告商的需求，而不是用户。这意味着个人的能动性掩盖了现实 &#8211; 即个人能动性的减少，因为用户被引导朝特定方向发展。此外，基于AI的数据分析可以提供宝贵的见解，且这些见解在其他情况下可能不易获得，可以增强人类的决策和能动性。然而，众所周知，AI系统继承并延续了其训练数据中存在的偏见。这可能导致不公平和歧视性的结果，这不可避免地通过对机会的限制来破坏人类能动性。AI技术在实践中的使用方式，可能对人类能动性产生其他负面影响。例如，AI监控（或监视）和AI控制决策制定的广泛使用引发了重要的隐私问题，限制了行动选择，并可能导致一种对技术的无力感或依赖感，所有这些都可能削弱个体能动性。</p>
         <p class="indent">下一个问题是，AIED对学生和教师能动性的影响是什么？存在很多可能。首先，如果学生频繁地与AI技术互动，他们可能会过于依赖所提供的内容推荐、即时反馈或“解决方案”。因此，他们可能错过了发展批判性思维、独立解决问题、自我反思、自我调节和元认知技能的机会，所有这些都可能减少学生实现自主学习的全部好处的能动性。其次，大多数 AIED 系统提供了高度规范性的学习路径，几乎没有给学生留下探索自己兴趣的空间。这可能通过规定学生学习的内容、时间和方式限制了学生的能动性，也可能会减少他们接触不同观点和新颖探究领域的机会。第三，AIED 系统通常会追踪学生的行为，导致一种被监视和自主权受到限制的感觉，并有可能破坏学生的隐私，导致学生会更谨慎地表达自己。第四，人工智能驱动的推荐可能会无意中缩小学生的愿望，限制他们实现自主目标的能力。第五，用于评估的AI技术过分强调标准化测试（因此不可避免地导致教学以考试为导向）。此外，任何AI系统都无法理解或捕捉学生作业中的细微差别，从而减少了学生在评估过程中的能动性，并可能阻碍创造性或非传统思维。</p>
         <p class="indent">最后，关于教师，AI技术在课堂上的使用不可避免地影响课程选择、学习内容和教学方法。这可能会降低教师发挥的作用，并使他们感到自己的专业判断被技术低估或取代。无论如何，AIED工具可能会降低教师所需的技术要求，将他们变成技术辅助者和行为监控者。这完全误解了优秀教师所做的事情。它还可能削弱教师与学生建立有意义的关系的能动性，而这对于有效的教育至关重要。最后，依赖AI生成的指标（有时因为自上而下的指令）可能会给教师带来压力，让他们遵循数据驱动的决策过程，可能会导致他们对整体学生发展的关注减少。</p>
         <p class="indent">最后一个问题是，随着强大的AI技术在课堂上的应用越来越广泛，需要采取措施来确保学生和教师的能动性。简而言之，需要给予教师尊重他们能动性的机会，让他们能够做出符合他们专业专长和学生特定需求的决策。与此同时，学生需要有机会发展他们的批判性思维、自我调节和元认知技能，并发展他们的意图性、自主性、适应性和责任性——无论是使用还是不使用适当的、有效的和安全的AI技术。</p>
         <p>.</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup>Anderson et al., <em>Artificial intelligence and the future of humans</em>, Pew Research Center, 2018</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup>Holmes et al., <em>Artificial intelligence and Education, A critical view through the lens of human rights, democracy and the rule of law</em>, Council of Europe, p. 34, 2022</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup>Bandura, A., <em>Toward a Psychology of Human Agency: Pathways and Reflections</em>, Perspectives on Psychological Science, 13(2), 130-136, 2018</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-homogenisation-invisibility-and-beyond-towards-an-ethical-ai" title="同质化、隐形化及其超越：走向符合伦理的AI">
         <header>
              <h1 class="chapter-title">同质化、隐形化及其超越：走向符合伦理的AI</h1>
              <p data-type="subtitle" class="chapter-number">26</p>
         </header>
         <h3 style="text-align: left">同质化</h3>
         <p class="no-indent">       在机器学习的数据集、基准（测试集）和算法的创建中，需要投入大量的金钱、计算资源、时间和努力。对于深度学习和大模型而言尤其如此。因此，共享这些创建的资源在这个生态系统中是有意义的。这就是我们经常使用的许多机器学习系统的情况。即使最终产品不同、由不同公司创建而成，方法论、数据集、机器学习库和评估往往是共享的<sup>1</sup>。因此，有理由认为，在相似情况下，它们的输出应该是相似的。</p>
         <p class="indent">如果输出的是教育决策，这会引起人们的担忧，例如学生可能会被不公平地拒绝接受每一个教育机会<sup>1</sup>。但是，算法同质化是否构成不公正，只能根据具体情况来判断<sup>1</sup>。</p>
         <p class="indent">另一方面，如果系统的任务是帮助学生写作，它将使写作风格、词汇乃至思维模式的标准化成为焦点。在这些情况下，使用的语言模型是根据其训练数据集来预测最可能的文本。这些数据集如果不在系统之间共享，也会以类似的方式构建，通常基于公共互联网数据。即使这些数据经过了偏见、歧视和极端内容的筛选，它也只代表了一个小的生态系统，并不能代表世界上思想、文化和实践的多样性。基于深度学习并用于短信和电子邮件的预测文本系统，已经被证明会改变人们的写作方式。写作倾向于变得“更简洁、更可预测、更少色彩”<sup>2</sup>。</p>
         <h3 style="text-align: left">隐形性</h3>
         <p class="no-indent">        在训练数据中重复的词语序列会渗透到大型语言模型的输出中。因此，数据库创建者的价值观具有限制替代性意见和多元化的思想表达的能力。如果没有适当的教学干预，这反过来可能会限制学生的创造力和原创性，不仅导致公式化写作，而且最终导致人们批判性思维能力变差，从而导致整个世界变得不那么丰富多彩<sup>3</sup>。</p>
         <p class="indent">与机器学习的许多负面影响紧密相关的，包括上述的同质性，是技术已经变得如此先进，以至于人机界面无缝且几乎不可见。无论是浏览器地址栏中内置的搜索引擎，还是直观的文本预测，在书写、预测和选择建议之间没有时间间隔。我们经常在技术的影响下行事，而没有意识到或没有选择停下来重新思考现况并做出自己的决定。此外，当我们习惯性地使用它来做决定时，我们倾向于完全忘记它的存在<sup>4</sup>。“一旦我们习惯了技术，我们就不再关注它们，而是通过技术来查看我们使用它们而促进的信息和活动”。这引起了人们对人类<strong>能动性</strong>、透明度和信任的严重担忧，特别是对于年轻人来说，专家建议界面应该更加明显，甚至难以操作<sup>4</sup>。</p>
         <h3 style="text-align: left">迈向超越：合乎伦理的AI</h3>
         <p class="no-indent">在这本书的每个部分，我们都讨论了AI教育、伦理和社会影响，特别是基于数据的AI。<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual/" target="_blank" rel="noopener">数据和隐私、内容的可靠性和用户自主权</a>、<a href="https://pressbooks.pub/aiforteachers/chapter/what-not-to-do-with-data-issues-of-personal-identity-bias-and-fairness/" target="_blank" rel="noopener">对个人身份的影响</a>、<a href="https://pressbooks.pub/aiforteachers/chapter/issues-with-data-bias-and-fairness/" target="_blank" rel="noopener">偏见和公平</a>以及<a href="https://pressbooks.pub/aiforteachers/chapter/ai-aied-and-human-agency/" target="_blank" rel="noopener">人类<strong>自主</strong>性</a>都在各自的页面中讨论。搜索引擎特有的问题在<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual/" target="_blank" rel="noopener">搜索视角背后：搜索对个人和社会的影响</a>中讨论，与自适应系统相关的问题在<a href="https://pressbooks.pub/aiforteachers/chapter/the-flip-side-of-als-some-paradigms-to-take-note-of/" target="_blank" rel="noopener">ALS的另一面</a>中处理，而特定于生成性AI的问题在<a href="https://pressbooks.pub/aiforteachers/chapter/the-degenerative/" target="_blank" rel="noopener">退化章节</a>中讨论。在本书的多处，我们研究了可以在课堂上采取的解决具体问题的补救措施。我们希望，一旦我们拥有伦理和可靠的教育AI系统，这些措施将变得不那么繁重。这种伦理AI将按照伦理规范和原则开发、部署和使用<sup>5</sup>，将会负责人和具有灵活性。</p>
         <p class="indent">由于我们将很多权力让渡给AI模型及其程序员、销售商和评估者，要求他们保持透明、承担责任，在出现问题时进行纠正，这都是合理的<sup>6</sup>。我们需要服务级别的协议，明确概述“支持和维护服务以及解决报告问题的步骤”<sup>5</sup>。</p>
         <p class="indent">一个有灵活性的AI会接受它的缺陷，会预料到它们，并且尽管有缺陷也能正常工作。有灵活性的人工智能系统会以可预测的方式产生故障，并有协议来处理这些故障<sup>6</sup>。</p>
         <p class="indent">在教育中，合乎伦理的AI应该遵循以用户为中心的设计原则，并考虑教育的所有方面<sup>7</sup>。教师将能够检验它的功能，理解其给出的解释，覆盖其决定或轻易地暂停其使用<sup>8</sup>。这些系统将减轻教师的工作量，为他们提供对学生的详细见解，并支持他们提高教育的覆盖范围和质量<sup>8</sup>。它们不会对用户或环境造成伤害，将增强学习者和教师的社会和情感福祉<sup>5</sup>。</p>
         <p class="indent">这一天到来之前，教师必须努力发展并参与由同事和教育工作者组成的社区，以提高对问题的认识，分享经验和最佳实践，并能判断可靠的人工智能提供商。他们还可以让学生和家长参与讨论和决策，以更好地解决不同的问题并营造一个信任和友爱的环境。作为教师最好的方式就是尽最大努力去了解 AIED 的最新趋势并在可能的时间和地点获取相应能力<sup>5</sup>。</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Bommasani, R., et al, <em>Picking on the Same Person: Does Algorithmic Monoculture lead to Outcome Homogenization?</em>, Advances in Neural Information Processing Systems, 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Varshney, L., <em>Respect for Human Autonomy in Recommender System</em>, 3rd FAccTRec Workshop on Responsible Recommendation, 2020.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, UNESCO, Paris, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Susser, D., <em>Invisible Influence: Artificial Intelligence and the Ethics of Adaptive Choice Architectures</em>, Proceedings of the 2019 AAAI/ACM Conference on AI, Ethics, and Society, Association for Computing Machinery, New York, 403–408, 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup><a href="https://education.ec.europa.eu/news/ethical-guidelines-on-the-use-of-artificial-intelligence-and-data-in-teaching-and-learning-for-educators">Ethical guidelines on the use of artificial intelligence and data in teaching and learning for <span class="s1">educators</span></a>, European Commission, October 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>Schneier, B., <em>Data and Goliath: The Hidden Battles to Capture Your Data and Control Your World</em>, W. W. Norton &amp; Company, 2015.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>Tlili, A., Shehata, B., Adarkwah, M.A. et al, <em>What if the devil is my guardian angel: ChatGPT as </em><em>a case study of using chatbots in education</em>, Smart Learning Environments, 10, 15 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>8 </sup>U.S. Department of Education, Office of Educational Technology, <em>Artificial Intelligence and Future of Teaching and Learning: Insights and Recommendations</em>, Washington, DC, 2023.</p>
    </section>
</div>
<div data-type="part" class="part" id="part-personalising-learning">
    <header>
         <h1 class="part-title">个性化学习</h1>
         <p data-type="subtitle" class="part-number">V</p>
    </header>
    <p>YouTube是否曾向您展示过一个视频，关于一个您可能与某人谈论过的话题，或者阅读了某个相关话题的内容，但没有在YouTube上搜索它？然而，它就在那里，在为您推荐的视频列表中。</p>
    <p class="indent">也许YouTube突出了一个您之前不知道、而现在已经迷上的话题？</p>
    <p class="indent">“为什么这个视频平台似乎比一些朋友更了解你？”</p>
    <p class="indent">“它是如何在它拥有的8亿个视频中挑选出你可能感兴趣的视频？”</p>
    <p class="indent">“是否有可能利用软件的个性化技能来帮助学习者更好地学习？”</p>
    <p class="indent">“YouTube和Netflix、亚马逊产品推荐、谷歌新闻、Facebook好友建议以及您的课堂背后有什么共同点？”</p>
    <p>&nbsp;</p>
    <p class="indent">请继续阅读&#8230;</p>
    <section data-type="chapter" class="chapter" id="chapter-a-note-on-personalisation" title="关于个性化的说明">
         <header>
              <h1 class="chapter-title">关于个性化的说明</h1>
              <p data-type="subtitle" class="chapter-number">27</p>
         </header>
         <h3 style="text-align: left">个性化学习</h3>
         <p class="no-indent"><img class="alignright wp-image-844" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1.png" alt="" width="329" height="233" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1.png 4973w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.1-350x247.png 350w" sizes="(max-width: 329px) 100vw, 329px" />每位教师都会个性化地进行教学——哪怕仅仅是增加一个额外的例子，或在必要时给予个别关注。从某种意义上说，教学本身就是一种个性化行为，这与电视播放的课程等不同。教师会改变他们的课程，以便学生能理解他们所学的内容。他们帮助学生将新知识或技能与他们已经知道的、个人观察和社会经验相结合。他们帮助学习者从他们学习的内容中取得收获。</p>
         <p class="indent">个性化学习是指根据学生的需求、能力和文化背景创造不同的学习环境和体验<sup>1</sup>。当然，个性化的范围和程度是有所不同的。专家们已经确定了个性化的六个维度——为什么学、如何学、学什么、何时学、谁来学和在哪里学<sup>2</sup>。</p>
         <p><img class="aligncenter wp-image-1063" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-850x1024.png" alt="" width="441" height="532" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-850x1024.png 850w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-249x300.png 249w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-768x925.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-65x78.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-225x271.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637-350x422.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240828104637.png 903w" sizes="(max-width: 441px) 100vw, 441px" /></p>
         <p><a href="http://www.penmendonca.com">www.penmendonca.com</a> @MendoncaPen，经Technology-enhanced personalised learning: untangling the evidence, Stuttgart: Robert Bosch Stiftung, 2018许可转载。</p>
         <figure id="attachment_876" aria-describedby="caption-attachment-876" style="width: 326px" class="wp-caption alignright">
              <img class="wp-image-876" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917.jpg" alt="" width="326" height="209" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917.jpg 784w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917-300x192.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917-768x492.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917-65x42.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917-225x144.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240607173917-350x224.jpg 350w" sizes="(max-width: 326px) 100vw, 326px" />
              <figcaption id="caption-attachment-876" class="wp-caption-text">Essa, A., <em>下一代自适应学习系统的可能未来</em>, Smart Learning Environments, 3, 16, 2016的个别化指导学习收益，根据CC BY 4.0许可。访问 <a href="https://creativecommons.org/licenses/by/4.0/">https://creativecommons.org/licenses/by/4.0/</a></figcaption>
         </figure>
         <p class="no-indent">一对一辅导是个性化的典范。20世纪60年代，本杰明·布鲁姆（Benjamin Bloom）发现，一般学生在接受个性化辅导后会表现得更好。他还发现，个别关注能缩小高分和低分学生之间的学习差距。在现实课堂中，即使只有十个学生，要让每个学生都受益于定制的教学内容也需要花费大量的精力。真正的个性化几乎是不可能的。即使教师知道学生在学习上有缺口，也可能因为时间限制而无法弥补。因此，即使教师尽了最大的努力，教育系统也会不断流失学生。</p>
         <p><img class="aligncenter wp-image-845" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2.png" alt="" width="261" height="464" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2.png 2392w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-169x300.png 169w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-576x1024.png 576w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-768x1366.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-864x1536.png 864w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-1152x2048.png 1152w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-65x116.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-225x400.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.2-350x622.png 350w" sizes="(max-width: 261px) 100vw, 261px" /></p>
         <p class="no-indent">这正是技术可以提供帮助的地方。</p>
         <h3 style="text-align: left">技术增强的个性化学习</h3>
         <p class="no-indent">技术可以用来使学习过程定制化。在这里，技术包括从移动应用程序、在线平台，到独立学习系统的任何类型<sup>2</sup>。现在，人工智能、数据访问、数据挖掘技术、云计算和价格低廉的硬件已经使应用变得无缝和实用，这种方法也更加有效。</p>
         <p class="indent">精密设计的技术不仅仅可以帮助克服上述的障碍。当技术与传统课堂结合起来，无论是家庭作业还是偶尔的课堂作业，它都能帮助学习者获得和练习一项常规技能。这样的技术可以增加在课堂上用于互动、关注个体学生和解决问题的时间。此外，还可以监控家庭作业的完成情况——观察学生的进展如何以及他们在哪些地方遇到了困难<sup>3</sup>。</p>
         <p><img class="aligncenter wp-image-847" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3.png" alt="" width="282" height="501" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3.png 2392w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-169x300.png 169w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-576x1024.png 576w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-768x1366.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-864x1536.png 864w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-1152x2048.png 1152w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-65x116.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-225x400.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-20.3-350x622.png 350w" sizes="(max-width: 282px) 100vw, 282px" /></p>
         <div class="textbox textbox--sidebar textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title">练习</p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/other-terms-related-to-personalised-learning/" target="_blank" rel="noopener" data-cke-saved-href="too-many-terms">点击这里获取关于混合和其他类型学习的定义，这些通常与个性化一起被</a><a href="https://pressbooks.pub/aiforteachers/chapter/other-terms-related-to-personalised-learning/" target="_blank" rel="noopener" data-cke-saved-href="too-many-terms">讨论</a><a href="https://pressbooks.pub/aiforteachers/chapter/other-terms-related-to-personalised-learning/" target="_blank" rel="noopener" data-cke-saved-href="too-many-terms">。</a>
              </div>
         </div>
         <p class="no-indent">有时，对于一节课的某些部分，软件可能会做得更好。设想在数学课上的三维可视化、语言课上的发音练习或解释人体细胞内部过程的动画。</p>
         <p class="indent">所有AI教育解决方案都可以在不同程度上帮助个性化学习。在本章中，我们讨论了自适应学习系统的使用。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Groff, J., <em>Personalized Learning: The State of the Field &amp; Future Directions</em>, Center for Curriculum Redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Holmes, W., Anastopoulou, S., Schaumburg, H &amp; Mavrikis, M., <em>Technology-enhanced personalised learning: untangling the evidence</em>, Stuttgart: Robert Bosch Stiftung, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup> Feldstein, M., Hill, P., <em>Personalized Learning: What It Really Is and Why It Really Matters</em>, Educause Review, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4</sup> Taylor, D., Yeung, M., Bashet, A.Z., <em>Personalized and Adaptive Learning</em>, Innovative Learning Environments in STEM Higher Education pp 17–34, Springer Briefs in Statistics, 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-adaptive-learning-systems" title="自适应学习系统">
         <header>
              <h1 class="chapter-title">自适应学习系统</h1>
              <p data-type="subtitle" class="chapter-number">28</p>
         </header>
         <p class="no-indent">假设你的学生正在做题库中的题目。想象每位学生旁边都坐着一个人。他们观察学生在找到解决方案的过程中遵循的步骤。</p>
         <p class="indent">“学生是否在某个概念上遇到了困难？”</p>
         <p class="indent">“他们似乎有什么误解？”</p>
         <p class="indent">“也许他们很沮丧，需要一点鼓励？”</p>
         <p class="no-indent">导师会给出提示，指出他们遗漏的地方。</p>
         <p class="indent">也可能学生觉得问题太简单，开始感到无聊。在这种情况下，导师会布置另一个更具挑战性的问题。</p>
         <p class="indent">导师甚至可能启发学生提问，使学生反思自己的表现。所有这一切都会让您随时了解学生的学习进度。</p>
         <figure id="attachment_109" aria-describedby="caption-attachment-109" style="width: 323px" class="wp-caption alignleft">
              <img class="wp-image-106" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-1024x768.png" alt="" width="323" height="242" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-1024x768.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-1536x1152.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student-350x263.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-watching-student.png 2048w" sizes="(max-width: 323px) 100vw, 323px" />
              <figcaption id="caption-attachment-109" class="wp-caption-text">《教学机器的日记》由 [ Ed ] 著作，根据 CC BY-NC-SA 2.0 许可授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent"><strong>智能辅导系统（ITS）</strong>旨在模仿这位导师的角色<sup>1</sup>。它们是一种自适应学习系统（ALS），可指导学生逐步解决问题。它们会根据需要给出提示和反馈。因此，智能辅导系统更适合数学等问题和解决思路清晰的学科<sup>2</sup>。不过最近的智能辅导系统也开始应用于其他科目。</p>
         <h3 style="text-align: left">自适应系统和学习</h3>
         <p class="no-indent">自适应学习的发生伴随着数字工具和系统创建个性化学习路径——为了学习特定内容或技能而执行的活动序列。学习路径取决于每个人的优势、劣势和学习速度<sup>3,4</sup>。</p>
         <p class="indent">机器适应于学生的想法可以追溯到20世纪50年代。随着最近技术的发展，现在有了无限的可能性。这些自适应学习系统可以用于不同的目的——解决问题、学习概念和/或评估学生。</p>
         <p>&nbsp;</p>
         <p class="no-indent"><img class="aligncenter wp-image-850" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1.png" alt="" width="589" height="331" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1.png 4253w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-300x169.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-1024x576.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-768x432.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-1536x864.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-2048x1152.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-65x37.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-225x127.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.1-350x197.png 350w" sizes="(max-width: 589px) 100vw, 589px" />目前市场上有许多自适应学习系统。还有一些制作工具可以帮助您创建一个自适应学习系统，而无需任何编码知识。虽然创建自适应学习系统可能需要大量时间和资源，但教师不需要改变课程计划或风格来适应课程。无论其类型和形式如何，用于创建自适应学习系统的技术千差万别——并非所有系统都一样！</p>
         <p class="indent">在选择系统时，您需要看它的适应性如何，它能使学习的哪些部分个性化，以及是否允许教师进行定制。除此之外，还有一些重要的实际问题，如需要什么设备，多少费用以及培训是否包含在费用中。</p>
         <h3 style="text-align: left">自适应学习系统的类型</h3>
         <p class="no-indent">智能导学系统（见上文）是个性化和交互式的。它们对学习进行实时评估。在微观层面上，它们会在学生解决问题时调整反馈。在宏观层面上，它们决定接下来展示什么问题——就像Youtube推荐接下来观看哪个视频一样。简单的导学系统使用决策树作为提供反馈的规则。其他系统则超越了预定规则，使用机器学习来调整自己的行为<sup>1</sup>。</p>
         <p class="no-indent"><img class="wp-image-858 aligncenter" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2.png" alt="" width="412" height="309" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2.png 2268w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-1024x768.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-1536x1152.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-2048x1536.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-21.2-350x263.png 350w" sizes="(max-width: 412px) 100vw, 412px" /></p>
         <figure aria-describedby="caption-attachment-109" style="width: 336px" class="wp-caption alignright">
              <img class="wp-image-109" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-1024x768.png" alt="" width="336" height="252" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-1024x768.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-300x225.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-768x576.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-1536x1152.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-65x49.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-225x169.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton-350x263.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch4-page2-TM-robot-newton.png 2048w" sizes="(max-width: 336px) 100vw, 336px" />
              <figcaption class="wp-caption-text">《教学机器的日记》由 [ Ed ] 著作，根据 CC BY-NC-SA 2.0 许可授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">自适应学习系统可以超越导学系统。例如，探索性学习系统让学生探索学习环境，并选择他们感兴趣的内容。基于游戏的系统以游戏的形式包装一切。当学生掌握了一个级别的知识后，他们就会进入下一个级别。</p>
         <p class="indent">无论哪种类型，所有自适应学习系统都应该为学习者提供支持，直到他们能够独立完成任务<sup>6</sup>。它们应该鼓励推理并支持决策，还应该能够向教师和学生解释它们的决策。</p>
         <p class="indent">在选择和使用自适应学习系统时，甚至在决定是否使用它时，专家建议始终从学习出发<sup>2</sup>。询问“需要满足学生的什么需求？哪种工具适合这项工作？如何为不同的学生提供不同的支持”<sup>5</sup>？研究表明，短期使用这些系统对学生学习没有显著影响。如果使用一整个学年或更长时间，效果会更好<sup>7</sup>。如果您决定使用自适应学习系统，请准备好支持学生并指导他们的学习，要有耐心，并随时准备尝试、失败和重试<sup>2,5</sup>。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Groff, J., <em>Personalized Learning: The state of the field and future directions</em>, Center for curriculum redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Holmes, W., Anastopoulou S., Schaumburg, H &amp; Mavrikis, M., <em>Technology-enhanced personalised learning: untangling the evidence</em>, Stuttgart: Robert Bosch Stiftung, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Taylor, D., Yeung, M., Bashet, A.Z., <em>Personalized and Adaptive Learning</em>, Innovative Learning Environments in STEM Higher Education pp 17–34, SpringerBriefs in Statistics, 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Becker, S. et al, <em>NMC Horizon Report: 2018 Higher Education Edition</em>, Educause, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Feldstein, M., Hill, P., <em>Personalized Learning: What It Really Is and Why It Really Matters</em>, Educause Review, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6</sup> Wood, D., Bruner, J., Ross, G., <em>The role of tutoring in problem-solving</em>, The Journal of Child Psychology and Psychiatry, 1976.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7</sup> Alkhatlan, A., Kalita, J.K., <em>Intelligent Tutoring Systems: A Comprehensive Historical Survey with Recent Developments</em>, International Journal of Computer Applications 181(43):1-20, 2019.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-how-youtube-learns-you-part-1" title="AI说（AI Speak）：Youtube是如何了解你的，第1部分">
         <header>
              <h1 class="chapter-title">AI说（AI Speak）：Youtube是如何了解你的，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">29</p>
         </header>
         <h3 style="text-align: left">模型与推荐</h3>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><strong>活动</strong></p>
              </header>
              <div class="textbox__content">
                   <p><img class="alignnone wp-image-856" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828.png" alt="" width="403" height="445" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828.png 1539w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-271x300.png 271w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-926x1024.png 926w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-768x849.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-1390x1536.png 1390w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-65x72.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-225x249.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-22.1-e1717747533828-350x387.png 350w" sizes="(max-width: 403px) 100vw, 403px" /></p>
                   <p class="no-indent">以上这些是居住在法国南特的John Doe和Tom Harry两位男士的信用卡交易记录。他们正在寻找这个周末可以做的事情。你会向他们推荐什么？</p>
                   <p class="indent">可选列表：</p>
                   <ol>
                        <li>新开的汉堡王门店</li>
                        <li>橄榄油品鉴活动</li>
                        <li>行李箱在线商店</li>
                        <li>河边音乐会</li>
                        <li>婴儿游泳课</li>
                   </ol>
              </div>
         </div>
         <p class="no-indent">推荐系统的历史至少和旅游指南和十佳榜单一样久远。虽然《卫报2022年度最佳书籍》推荐给每个人的书单都是一样的，但当你为自己选择时，你可能会根据个人偏好选择其中几本，并改变阅读的顺序。</p>
         <p class="indent">如何为陌生人推荐选项？在上面的活动中，你可能尝试根据给定的信息来想象他们的个性：你会做出判断并应用刻板印象。然后，一旦你对他们的“类型”有了一个想法，你就从列表中选择了可能（或不可能）与他们相关的事物。亚马逊、Netflix和Youtube等推荐软件也遵循类似的过程。</p>
         <p class="indent">如今，人们在搜索信息或寻找在线内容时，他们都会使用某种个性化推荐系统<sup>1,2</sup>。Youtube的主要功能是从平台上所有可用的视频中建议用户观看什么。对于已登录的用户，它使用他们过去的活动来创建一个模型，或一个人格类型。一旦为John建立了一个模型，它就可以看看还有谁与他的模型相似。然后，它会向John推荐与他观看过的视频相似的视频，以及与他相似的其他人观看过的视频类似的视频。</p>
         <h3 style="text-align: left">什么是模型？</h3>
         <p class="indent no-indent">模型可以用来模拟任何事物，从用户到视频，再到孩子必须学习的课程。模型是世界的简化表示，因此机器可以尝试理解它：</p>
         <p><a href="https://www.bilibili.com/video/BV12y411h7JW/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 模型 (Models)</a></p>
         <h3 style="text-align: left">Youtube是如何了解你的</h3>
         <p class="no-indent">所有的推荐问题都涉及一个代理问题：“推荐什么”对于算法来说太过笼统和模糊。<a href="https://en.wikipedia.org/wiki/Netflix_Prize" target="_blank" rel="noopener" data-cke-saved-href="https://en.wikipedia.org/wiki/Netflix_Prize">Netflix询问开发者，</a>考虑到用户A对其他视频的打分，用户A会给视频B评定什么评分。Youtube则询问特定用户在特定情境下的观看时间。选择询问什么和预测什么，对显示什么样的推荐有很大影响<sup>3</sup>。正确的预测将带来好的推荐。预测本身基于具有相似品味的其他用户<sup>4</sup>。也就是说，模型相似的用户。</p>
         <h3 style="text-align: left">用户模型</h3>
         <p class="no-indent">Youtube将推荐任务分为两类，并分别使用不同的模型<sup>3</sup>。不过，在这里我们采用更简单的解释。</p>
         <p class="indent">为了创建用户模型，其开发者必须要问：哪些数据与视频推荐相关。用户之前看过什么？他们迄今为止的评论、评分和明确偏好是什么？他们搜索了什么？Youtube使用的是隐性信号而非显性信号，因为后者更容易获得<sup>3</sup>。用户是仅仅点击了视频还是观看了它？如果是，观看了多久？用户对以前的推荐反应如何<sup>1</sup>？哪些被忽略了？除了对这些问题的直接回答之外，在用户是新用户或未登录时，性别、语言、地区和设备类型等人口统计学信息也非常有价值<sup>3</sup>。</p>
         <p class="indent">一旦有了每个用户的模型，我们就可以对用户进行比较，并使用这些信息进行推荐。</p>
         <h3 style="text-align: left">视频模型</h3>
         <p class="no-indent">我们也可以使用既相似又不同的视频。Youtube会查看特定视频的相关信息——标题和描述、视频质量、观看人数（观看次数）、点赞人数、收藏人数、评论人数或分享人数、上传时间以及订阅母频道的用户数量<sup>1</sup>。</p>
         <p><a href="https://www.bilibili.com/video/BV1bt421K7s9/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 我与视频之间的距离是多少？(What is the distance between a video and me?)</a></p>
         <p class="no-indent">用户接下来要观看的视频，还取决于一个视频是否是系列中的一集，或播放列表中的一个项目。如果用户正在了解一个新艺术家，他或她可能会从最受欢迎的歌曲转向小众市场。此外，用户可能不会点击缩略图质量差的视频<sup>1,3</sup>。所有这些信息也都会进入模型。</p>
         <p class="indent">推荐系统的构建模块之一是从一个视频转到相关视频列表。在这种情况下，我们将相关视频定义为用户接下来可能会观看的视频<sup>3</sup>。我们目标是从数据中发掘最大价值，从而给出更好的推荐<sup>4</sup>。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Davidson, J., Liebald, B., Liu, J., Nandy, P., Vleet, T., <em>The Youtube Video Recommendation System</em>, Proceedings of the 4th ACM Conference on Recommender Systems, Barcelona, 2010.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Spinelli, L., and Crovella, M., <em>How YouTube Leads Privacy-Seeking Users Away from Reliable Information</em>, In Adjunct Publication of the 28th ACM Conference on User Modeling, Adaptation and Personalization (UMAP ’20 Adjunct), Association for Computing Machinery, New York, 244–251, 2020.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Covington, P., Adams, J., Sargin, E., <em>Deep neural networks for Youtube Recommendations</em>, Proceedings of the 10th ACM Conference on Recommender Systems, ACM, New York, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Konstan, J., Terveen, L., <em>Human-centered recommender systems: Origins, advances, challenges, and opportunities</em>, AI Magazine, 42(3), 31-42, 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-how-youtube-learns-you-part-2" title="AI说（AI Speak）：Youtube是如何了解你的，第2部分">
         <header>
              <h1 class="chapter-title">AI说（AI Speak）：Youtube是如何了解你的，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">30</p>
         </header>
         <h3 style="text-align: left">流程</h3>
         <p class="no-indent">在谷歌，<a href="https://pressbooks.pub/aiforteachers/chapter/deep-neural-networks/" target="_blank" rel="noopener">深度神经网络</a>正在被用于机器学习<sup>2</sup>。基于视频模型，Youtube的神经网络会选取与用户已观看视频相似的视频。然后，它尝试根据给定的用户模型预测每个新视频的观看时间，并根据预测结果对它们进行排名。这样做的目的是展示排名靠前的10到20个视频（具体数量取决于设备的显示限制）。</p>
         <p class="indent">这个过程类似于我们之前学习的<a href="ai-speak--machine-learning" target="_blank" rel="noopener" data-cke-saved-href="ai-speak--machine-learning">机器学习模型</a>。首先，机器根据程序员给出的用户模型和视频模型提取特征。它通过训练数据学习给每个特征赋予何种权重，从而正确预测观看时间。然后，一旦经过测试有效，它就可以开始预测和推荐。</p>
         <p><img class="wp-image-860 aligncenter" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971.png" alt="" width="414" height="271" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971.png 1998w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-300x196.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-1024x669.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-768x502.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-1536x1003.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-65x42.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-225x147.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-350x229.png 350w" sizes="(max-width: 414px) 100vw, 414px" /></p>
         <p>&nbsp;</p>
         <h3 style="text-align: left">训练</h3>
         <p class="no-indent">在训练过程中，系统会接收到数百万个正面和负面的示例。正面示例是用户点击了视频并观看了一段时间。负面示例是用户没有点击视频或观看时间不长<sup>2</sup>。</p>
         <p class="indent">网络吸收了在“<a href="ai-speak--how-youtube-learns-you" target="_blank" rel="noopener" data-cke-saved-href="ai-speak--how-youtube-learns-you">Youtube是如何了解你的，第1部分</a>”中的模型部分所讨论的用户特征和视频特征。它通过检查是否能正确预测给定视频和用户的观看时间来调整每个输入特征的权重。</p>
         <p class="indent">大约有十亿个参数（每个特征的权重）需要在数千亿个示例中学习<sup>2</sup>。网络还可能学会忽略某些特征，并将其权重降至零。因此，算法创建或嵌入的模型可能与开发者的设想大相径庭。</p>
         <h3 style="text-align: left">测试</h3>
         <p class="no-indent">网络训练完成后，它就会在已有数据上进行测试和调整。除了预测的准确性，程序员还必须根据一系列价值判断来调整系统的输出。<img class="alignright wp-image-930" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897.png" alt="" width="300" height="166" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897.png 1998w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-300x166.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-1024x566.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-768x425.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-1536x849.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-65x36.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-225x124.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162044-1-e1718947423897-350x194.png 350w" sizes="(max-width: 300px) 100vw, 300px" />如果显示与已观看的视频过于相似，则不会非常吸引人。一个好的推荐到底意味着什么？展示多少相似视频，引入多少多样性——既与其他视频相关，也与用户历史相关。要覆盖用户的多少兴趣？哪种类型的推荐能为用户带来即时满足，哪类推荐有助于用户的长期使用<sup>1,3</sup>？这些都是需要考虑的重要问题。</p>
         <p>&nbsp;</p>
         <p class="indent">测试结束后，将对推荐进行实时评估。每组预测视频的总观看时间将被测量<sup>2</sup>。用户观看推荐视频的时间越长，模型就越成功。需要注意的是，仅仅查看视频的点击量不足以作为评估的充分依据。Youtube根据有多少推荐视频被观看了相当长的时间、会话长度、首次长时间观看前的时间以及有推荐视频的登录用户比例来评估其推荐器<sup>1</sup>。</p>
         <h3 style="text-align: left">界面</h3>
         <p class="no-indent">现在，我们将探讨如何向观众展示推荐内容。应该展示多少视频？最佳的推荐方式是否应该一次性展示，还是应该保留一些以后再展示<sup>3</sup>？如何显示缩略图和视频标题？还应该显示哪些其他信息？用户可以控制哪些设置<sup>1</sup>？这些问题的答案决定了Youtube如何让二十亿用户保持兴趣。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Davidson, J., Liebald, B., Liu, J., Nandy, P., Vleet, T., <em>The Youtube Video Recommendation System</em>, Proceedings of the 4th ACM Conference on Recommender Systems, Barcelona, 2010.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> Covington, P., Adams, J., Sargin, E., <em>Deep neural networks for Youtube Recommendations</em>, Proceedings of the 10th ACM Conference on Recommender Systems, ACM, New York, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Konstan, J., Terveen, L., <em>Human-centered recommender systems: Origins, advances, challenges, and opportunities</em>, AI Magazine, 42(3), 31-42, 2021.</p>
         <p class="hanging-indent" style="text-align: left">4 Spinelli, L., and Crovella, M., <em><a href="https://doi.org/10.1145/3386392.3399566" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1145/3386392.3399566">How YouTube Leads Privacy-Seeking Users Away from Reliable Information</a></em>, In Adjunct Publication of the 28th ACM Conference on User Modeling, Adaptation and Personalization (UMAP ’20 Adjunct), Association for Computing Machinery, New York, 244–251, 2020.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-how-adaptive-systems-learn-the-learner-part-1" title="AI说（AI-Speak）：自适应系统如何了解学习者，第1部分">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：自适应系统如何了解学习者，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">31</p>
         </header>
         <p><img class="alignleft wp-image-852" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1.png" alt="" width="375" height="667" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1.png 2392w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-169x300.png 169w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-576x1024.png 576w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-768x1366.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-864x1536.png 864w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-1152x2048.png 1152w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-65x116.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-225x400.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.1-350x622.png 350w" sizes="(max-width: 375px) 100vw, 375px" /></p>
         <p class="no-indent">在审视一个自适应学习系统时，很难判断它在哪里进行自适应<sup>1</sup>。在不同的系统中，使用的技术以及其用途也有所变化。</p>
         <p class="indent">然而，所有自适应学习系统都知道它们在教谁（关于学习者的知识）、教什么（关于领域的知识）以及如何教（关于教学法的知识）<sup>2</sup>。</p>
         <p class="indent">理想的自适应学习系统会以多种方式进行自我调整。在外部循环中，学习活动的顺序会被调整——类似于Youtube调整推荐视频列表。外部循环还可以对学习方法和难度级别进行个性化调整。</p>
         <p class="indent">在内部循环中，自适应学习系统会监控每个活动中的逐步进展。如果有误解，它会调整反馈和提示以纠正错误概念。如果学生在回忆之前学过的概念时遇到问题，它也可能指向额外的学习内容。一些专家认为，内部循环最好由教师来完成：为特定主题和任务编制所有的规则，这成本高、耗时长。而且教师的知识和经验总是胜过机器<sup>3</sup>。</p>
         <h3 style="text-align: left">自适应系统如何了解学习者</h3>
         <p class="no-indent">就像所有推荐问题一样（参见<a href="ai-speak--how-youtube-learns-you" target="_blank" rel="noopener" data-cke-saved-href="ai-speak--how-youtube-learns-you">Youtube是如何了解你的，第1部分</a>），自适应学习系统将任务分解为一个或多个可以由机器回答的代理问题。同样，关于询问什么问题，预测什么的选择对显示的推荐有很大影响。</p>
         <p class="indent">推广材料中经常提到多重目标：提高成绩、就业能力和投入度。鉴于系统的专有性质，通常系统中编码的问题是什么，优化的目标是什么，以及如何区分短期目标和长期目标（例如，在进入下一个级别之前掌握特定内容）是不清楚的<sup>4</sup>。</p>
         <p class="indent">在使用机器学习的时候，无论选择的目标是什么，预测本身都是基于具有相似技能水平和偏好的其他学习者，也即模型相似的学习者。</p>
         <h3 style="text-align: left">学习者模型</h3>
         <p class="no-indent">在创建学生模型时，开发人员询问会哪些学生特征与学习过程相关。与教师可以直接观察学生并调整方法不同，机器仅限于可以由它们收集和处理的数据。</p>
         <p class="indent">学生模型中考虑的典型特征：</p>
         <ul>
              <li><strong>学生知道什么 &#8211; 他们的知识水平、技能和错误概念<sup>5,2,6</sup>。</strong> 这些通常是通过评估推断出来的。例如，学生提交的数学问题的答案<sup>1</sup>。然后将这些已有知识与他们在学习阶段结束时需要知道的内容进行比较。</li>
              <li><strong>学生偏好哪种学习：学习过程和偏好<sup>5,6</sup>。</strong> 例如，学生在正确回答一个问题之前尝试的次数，查阅的资料类型，他们对某项活动的评分<sup>1</sup>，或者最能吸引他们的材料——图像、音频或文本<sup>2</sup>。自适应学习系统还可以记录<strong>何时以及如何学到的技能以及哪些教学法效果最佳<sup>6</sup>。</strong></li>
              <li><strong>学生是否感到有动力：</strong>学生的<strong>感受和情绪</strong>可以直接记录下来，也可以从语音、面部表情、眼动追踪、身体语言、生理信号或它们的组合中间接提取。然后可以使用这些信息将学生从抑制学习的负面状态（如无聊或挫败感）中转移到积极状态（如投入或享受）<sup>7</sup>。</li>
              <li>关于<strong>认知方面，如记忆、注意力、解决问题的技能、决策能力、情境分析和批判性思维能力<sup>5。</sup></strong></li>
              <li>他们如何<strong>沟通和协作<sup>5</sup></strong>？例如，他们是否在其他学生的动态上发表评论，以及如何与他人讨论以解决问题<sup>1</sup>。</li>
              <li>关于元认知技能，比如<strong>自我调节、自我解释、自我评估和自我管理</strong><sup>5</sup>，<strong>寻求帮助</strong>，<strong>意识到并能够控制自己的思考的能力。</strong>例如，他们如何选择学习目标，使用已有知识或有意选择解决问题的策略<sup>5</sup>。</li>
         </ul>
         <p class="indent">这些数据会变化，需要记录和更新。模型还包含<strong>静态特征，如年龄、性别、母语和电子邮件身份<sup>2</sup>。</strong></p>
         <p class="indent">大多数自适应学习系统都是基于与学生的互动来创建学习者模型的。一些还从其他网站，尤其是社交媒体上获取信息。一旦为每个学习者创建了模型，机器就会计算出哪些学生彼此相似，并估计某个学生从某个活动、示例或问题中受益的概率<sup>3</sup>。</p>
         <h3 style="text-align: left">领域模型</h3>
         <p class="no-indent"><img class="alignleft wp-image-853" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2.png" alt="" width="400" height="284" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2.png 3872w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-300x213.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-1024x726.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-768x545.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-1536x1090.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-2048x1453.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-225x160.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-24.2-350x248.png 350w" sizes="(max-width: 400px) 100vw, 400px" />我们可以在自适应学习系统中的学习对象和Youtube上的视频之间做一个粗糙的类比。一门学科可以被分解为概念和技能；这些概念和技能被称为知识单元（knowledge units, KUs），是学习者需要掌握的知识<sup>3</sup>。每个知识单元都有一组学习对象，通过这些对象可以学习内容，并通过一组活动来评估学习效果。有些作者将学习对象进一步细分为学习活动；我们在此不做细分。</p>
         <p class="indent">学习对象可以是要阅读的文本、视频、一组问题、互动活动（从简单的填空到基于情景的学习活动）、交互式动画等<sup>1 </sup>。这些学习对象提供了学习者需要了解的知识，而评估活动则表明学习者是否掌握了这些知识<sup>3</sup>。领域模型包含学习对象的所有特征，包括相关的知识单元和评估。学习者接下来学习的内容也将取决于知识单元之间的相互关系。</p>
         <p class="indent">这些知识单元需要进入模型：学习对象A和B可能都是学习对象D的先决条件。因此，在D之前必须先掌握A和B。一些知识单元之间存在着顺序，它们告诉我们如何学习<sup>3</sup>。相反，如果学生正确解决了与D相对应的问题，那么可以肯定他或她也掌握了A和B。</p>
         <p class="indent">学科专家可以提供其中的一些关系，其他推论机器自己可以学习，它可以预测掌握知识单元的概率。这种掌握涉及到系统知道学习者已经掌握了A和B，因为他回答了D的问题。然后系统可以利用这些信息以及学习者和领域模型的其他特征，来推荐学习路径和学习对象。</p>
         <p class="no-indent"><img class="aligncenter wp-image-854" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3.png" alt="" width="567" height="402" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3.png 3872w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-300x213.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-1024x726.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-768x545.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-1536x1090.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-2048x1453.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-225x160.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CH-24.3-350x248.png 350w" sizes="(max-width: 567px) 100vw, 567px" />学习对象的其他特征可能包括活动的难度级别、受欢迎程度和评分。与Youtube推荐一样，这里的目标是从可用的数据中尽可能多地提取信息。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> EdSurge, <em>Decoding Adaptive</em>, Pearson, London, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Alkhatlan, A., Kalita, J.K., <em>Intelligent Tutoring Systems: A Comprehensive Historical Survey with Recent Developments</em>, International Journal of Computer Applications 181(43):1-20, March 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Essa, A., <em><a href="https://doi.org/10.1186/s40561-016-0038-y" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1186/s40561-016-0038-y">A possible future for next generation adaptive learning systems</a></em>, Smart Learning Environments, 3, 16, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Bulger M., <em>Personalised Learning: The Conversations We’re Not Having</em>, Data &amp; Society Working Paper, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Chrysafiadi, K., Virvou, M., <em>Student modeling approaches: A literature review for the last decade</em>, Expert Systems with Applications, Elsevier, 2013.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>Groff, J., <em>Personalized Learning: The state of the field and future directions</em>, Center for curriculum redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>du Boulay, B., Poulovasillis, A., Holmes, W., Mavrikis, M., <em>Artificial Intelligence And Big Data Technologies To Close The Achievement Gap</em>, In: Luckin, Rose ed. Enhancing Learning and Teaching with Technology. London: UCL Institute of Education Press, pp. 256–28, 2018.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-speak-how-adaptive-systems-learn-the-learner-part-2" title="AI说（AI-Speak）：自适应系统如何学习学习者，第2部分">
         <header>
              <h1 class="chapter-title">AI说（AI-Speak）：自适应系统如何学习学习者，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">32</p>
         </header>
         <h3 class="heading_font heading_weight clearboth" style="text-align: left">过程</h3>
         <p class="no-indent">近年来，机器学习不论是作为唯一技术还是与其他方法结合使用，越来越多地被应用于自适应系统中<sup>2</sup>。在使用过程中，机器学习的主要作用是基于一系列特征（包括评估结果和在此过程中生成的新数据）创建和更新学生模型<sup>1</sup>。</p>
         <p class="indent">在外部循环中，在训练数据的帮助下，通过分配适当的权重而创建模型。这是帮助推荐有效学习内容的特征<sup>2</sup>。（参见<a href="ai-speak--machine-learning" data-cke-saved-href="ai-speak--machine-learning">机器学习是如何工作的</a>）。就像Youtube中的新推荐一样。这些模型用于定期推荐新的学习路径以反映学生的进步和不断变化的兴趣。在基于机器学习的自适应学习系统中，学习的路径数量可以达到数万亿<sup>3</sup>。</p>
         <p><img class="wp-image-860 aligncenter" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971.png" alt="" width="447" height="292" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971.png 1998w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-300x196.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-1024x669.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-768x502.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-1536x1003.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-65x42.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-225x147.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信图片_20240607162034-e1717748584971-350x229.png 350w" sizes="(max-width: 447px) 100vw, 447px" /></p>
         <p class="no-indent" style="text-align: left">在内部循环中，机器学习用于提供适当的反馈，发现错误，推断知识空缺并评估知识单元的掌握情况。在进行一项学习活动时，学生可能会犯错误。机器学习可以用来预测哪些错误是由哪些知识缺失引起的。如果解题的一个步骤是正确的，机器学习还可以预测哪些知识单元已经成功掌握<sup>2</sup>。</p>
         <p class="indent"><span style="font-size: 14pt">自适应系统中使用的其他技术涉及较少的自动化和更多明确的书面推断规则<sup>2</sup>。</span></p>
         <p>它们需要大量的编程时间和额外的努力，才能准确捕捉决策过程中的所有标准。此外，其结果通常不能从一个内容领域推广到另一个内容领域，或从一个问题推广到另一个问题。</p>
         <p class="indent">应用机器学习的工具使用大量有关学生实际学习表现的数据集，并能够随着时间的推移为学生创建动态的学习路径<sup>1</sup>。如同所有机器学习应用程序一样，在投入课堂使用之前需要进行训练和测试<span style="font-size: 14pt">。</span></p>
         <figure id="attachment_878" aria-describedby="caption-attachment-878" style="width: 610px" class="wp-caption aligncenter">
              <img class="wp-image-878" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2.jpg" alt="" width="610" height="672" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2.jpg 867w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2-272x300.jpg 272w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2-768x846.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2-65x72.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2-225x248.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-2-350x386.jpg 350w" sizes="(max-width: 610px) 100vw, 610px" />
              <figcaption id="caption-attachment-878" class="wp-caption-text">来自EdSurge，《解码自适应》，皮尔森，伦敦，2016年，根据CC BY 4.0许可。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/4.0/">https://creativecommons.org/licenses/by/4.0/</a></figcaption>
         </figure>
         <h3 style="text-align: left">教学模型</h3>
         <p class="no-indent">在Youtube的案例中，我们看到关于什么是好的推荐有很多价值判断。如一组推荐需要覆盖多少用户兴趣，有多少视频应该与已观看的视频相似，为了多样性需要添加多少新内容（见<a href="ai-speak--how-youtube-learns-you-part-2" target="_blank" rel="noopener" data-cke-saved-href="ai-speak--how-youtube-learns-you-part-2">Youtube是如何了解你的，第2部分</a>）。自适应学习系统涉及对掌握一个知识单元意味着什么和如何达到掌握的判断：教学法和学习者的日常体验<sup>4</sup>。</p>
         <p class="indent">在自适应学习系统的情况下，这些关于学习者如何取得进步的判断和指导应该基于经过验证的教学理论。这些都将纳入教学模型，并结合领域模型和学习者模型，帮助机器选择一套合适的活动。</p>
         <p class="indent">教学模型回答的问题是：下一步应该向学生呈现一个概念、一个活动还是一个测试？难度级别如何？他们如何评估学习并提供反馈？哪些地方需要更多的脚手架<sup>5</sup>？（注：脚手架是提供关于概念和程序、使用的策略以及如何反思、计划和监控学习的支持机制。）教学模型决定了活动的广度和深度——甚至决定了是否继续进行自适应学习系统还是寻求老师的帮助<sup>3</sup>。</p>
         <figure id="attachment_881" aria-describedby="caption-attachment-881" style="width: 1024px" class="wp-caption aligncenter">
              <img class="wp-image-881 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-1024x724.jpg" alt="" width="1024" height="724" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-1024x724.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-300x212.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-768x543.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-65x46.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-225x159.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1-350x247.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/26-3-1.jpg 1536w" sizes="(max-width: 1024px) 100vw, 1024px" />
              <figcaption id="caption-attachment-881" class="wp-caption-text">来自EdSurge，《解码自适应》，皮尔森，伦敦，2016年，根据CC BY 4.0许可。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/4.0/">https://creativecommons.org/licenses/by/4.0/</a></figcaption>
         </figure>
         <h3 style="text-align: left">交互界面</h3>
         <p class="no-indent">这里呈现推荐、学习者进度、表现和目标等其他数据。其中的关键问题是：</p>
         <ul>
              <li>如何提供内容？</li>
              <li>一次推荐多少内容？</li>
              <li>哪些是直接分配的内容，哪些是推荐的内容？</li>
              <li>有哪些支持资源？</li>
              <li>是否可以提供小组活动？</li>
              <li>应该允许多少自主权？</li>
              <li>学生能否改变自己的偏好？</li>
              <li>老师能否改变学习路径？</li>
              <li>向老师展示哪些数据？</li>
              <li>老师是否参与其中？</li>
         </ul>
         <h3 style="text-align: left">评估</h3>
         <p class="no-indent">当自适应学习系统投入使用时，大多数系统会根据程序员设定的标准来监控自己的性能。就像任何AI工具一样，数据可能存在偏见。系统得出的推断可能并不精确。随着时间的推移，学生过去的数据将变得不那么相关<sup>6</sup>。因此，老师也必须监控系统的性能，并在必要时提供学习指导和纠正措施。</p>
         <p class="indent">老师和同伴也必须提供灵感并提示替代资源。十多年来，商业内容提供商和在线零售公司主导了推荐系统的研究工作。因此，重点一直是提供可以提升推广效果的推荐。&#8221;意外的惊喜&#8221;<sup>7</sup>和少有人走的路的诱惑可以激发持久的学习。遗憾的是，这些不是基于机器的个性化学习的强项。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> EdSurge, <em>Decoding Adaptive</em>, Pearson, London, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Chrysafiadi, K., Virvou, M., <em>Student modeling approaches: A literature review for the last decade</em>, Expert Systems with Applications, Elsevier, 2013.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Essa, A., <em><a href="https://doi.org/10.1186/s40561-016-0038-y" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1186/s40561-016-0038-y">A possible future for next generation adaptive learning systems</a></em>, Smart Learning Environments, 3, 16, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Groff, J., <em>Personalized Learning: The state of the field and future directions</em>, Center for curriculum redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Alkhatlan, A., Kalita, J.K., <em>Intelligent Tutoring Systems: A Comprehensive Historical Survey with Recent Developments</em>, International Journal of Computer Applications 181(43):1-20, March 2019.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>du Boulay, B., Poulovasillis, A., Holmes, W., Mavrikis, M., <em>Artificial Intelligence And Big Data Technologies To Close The Achievement Gap</em>, In: Luckin, Rose ed. Enhancing Learning and Teaching with Technology. London: UCL Institute of Education Press, pp. 256–28, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>Konstan, J., Terveen, L., <em>Human-centered recommender systems: Origins, advances, challenges, and opportunities</em>, AI Magazine, 42(3), 31-42, 2021.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-the-flip-side-of-als-some-paradigms-to-take-note-of" title="自适应学习系统的另一面：一些值得关注的范式">
         <header>
              <h1 class="chapter-title">自适应学习系统的另一面：一些值得关注的范式</h1>
              <p data-type="subtitle" class="chapter-number">33</p>
         </header>
         <p class="no-indent">尽管自适应学习系统具有巨大潜力，但仍有许多问题尚未得到解答。目前还没有足够的研究或课堂实践的文献来帮助解决这些问题：</p>
         <ul>
              <li style="text-align: justify">推荐系统用于向Netflix用户推荐电影。它们帮助消费者在亚马逊上正确选择音响扬声器。但它们真的能改善课堂上每个学生的学习效果吗<em><sup> </sup></em><em><sup>1</sup></em>？</li>
              <li style="text-align: justify">一直关注绩效和个性化是否会影响学生的心理健康<sup>2</sup>？</li>
              <li style="text-align: justify">个性化要求学生有很强的自律性和自我调节能力。他们必须自己开始工作，直到完成指定的所有任务。所有学生都能在没有帮助的情况下做到这一点吗<sup>2</sup>？</li>
              <li style="text-align: justify">我们如何在个性化与社会学习机会之间取得平衡<sup>3</sup>？</li>
              <li style="text-align: justify">我们如何从将自适应学习系统作为单一学科的支持，转变为系统地、跨主题和跨学科地使用这些系统<sup>2</sup>？要实现这种适应性整合，需要对课程进行哪些改革<sup>3</sup>？</li>
              <li style="text-align: justify">所需的基础设施如何？对于数据和隐私以及偏见和增强的刻板印象，我们需要做些什么<sup>3</sup>？</li>
         </ul>
         <p class="indent">在开发自适应学习系统时，会直接或隐含地使用一些规则。这些也会导致一些后果。</p>
         <h3 style="text-align: left">自适应学习系统范式1：经典不败</h3>
         <p class="no-indent">机器学习系统在预测或推荐某事时做了什么？它们使用学生的过去经历、偏好和表现来选择向他们推荐什么；它们回顾过去以预测未来。因此，这些系统总是偏向于过去<em><sup>4</sup>。“</em>机器学习在静态和稳定的世界中表现最佳。在这样的世界里，过去看起来就像未来一样”<em><sup>5</sup></em>。基于机器学习模型的自适应学习系统或多或少也是这么做的，但现在增加了教学方面的考虑。</p>
         <p class="indent">因此，这些系统无法考虑到正常情况下的波动，如COVID大流行、健康问题和其他问题。它们可能难以考虑年轻人的年龄、成长、新技能的掌握和个人发展。</p>
         <p class="indent">学生行为是否可预测？在一个过去行之有效的公式变得枯燥、重复并阻碍进步之前，我们能重复多少次<sup>6</sup>？即使可以预测，仅仅让学生接触他们喜欢和感到舒适的内容是否明智？多少新奇的东西会使人不知所措、适得其反<sup>6</sup>？</p>
         <p>决定推荐的活动应该有多大的相似性？一次应该引入多少新类型的活动？以及何时推动学生面对挑战和探索新兴趣会才是有成效的？这是很难决定的。答案不仅仅在于学生的过去。</p>
         <h3 style="text-align: left">自适应学习系统范式2：显性反映隐性</h3>
         <p class="no-indent">即使用过去来预测未来是可靠的，过去本身也可能难以被准确捕捉。Youtube如何知道用户喜欢某个视频？如果他们在观看后点击了“赞”按钮或订阅了母频道，那就比较容易了。但这样明确的行为往往很少见。推荐系统不得求助于隐性的信号，但这些信号不一定能完全反映事实<sup>4</sup>。例如，Youtube使用用户观看视频的时间作为隐性信号，表明用户喜欢该视频并希望观看类似内容。但是，仅仅因为在某人的电脑上一个视频被播放到了最后，并不意味着这个人喜欢它，甚至观看了它<sup>7</sup>。</p>
         <p class="indent">自适应学习系统如何记录反馈呢？例如，为了判断学生在活动期间是否专心，系统可能会记录他们点击数字资源的次数，以及他们访问这些资源的时间和持续时间。但这些并不能准确反映学生的注意力水平<sup>1</sup>。</p>
         <p class="indent">例如，如果学生清楚知道该如何完成一个活动，他们可能会查阅一些资源，并迅速找到关键点。一个不太清楚的学生可能会打开所有列出的资源并花时间浏览，但没有学到太多<sup>1</sup>。第一个学生有可能被错误地标记为缺乏动力，并被要求做额外的工作。</p>
         <p class="indent">此外，机器学习模型只能注意到两件事的发生——学生点击资源和在相关练习中得了高分。它们无法推断学生之所以得高分，是因为他们查阅了资源——它们可以推断出相关性，但无法推断因果关系<sup>5</sup>。</p>
         <p class="indent">对自适应学习系统的一些不公平期望是教师会介入并纠正这些错误。在其他系统中，教师甚至没有选项让他们这样做。</p>
         <h3 style="text-align: left">自适应学习系统范式3：一切都可以用一个问题来替代</h3>
         <p class="no-indent">推荐系统无法处理多重目标。自适应学习系统的目标通常以单一问题的形式提出，即代理问题（the surrogate question）。用户给电影的评分是多少，他们观看视频的时间有多长，学生在测验中的得分如何，他们多大程度上满足了机器用来衡量专注度的标准……然后，系统被训练来实现这些目标，并根据是否达到这些目标进行测试。它们的性能不断被调整，以最大限度的提高与这些目标相关的分数。</p>
         <p class="indent">如果以测验得分为目标，就会以某种方式推荐某些学习内容。这样，考试成绩就是要解决的代理问题。如果目标仅仅是让他们点击更多资源，推荐将会量身定制，促使他们这么做。在这种情况下，使资源具有足够的吸引力就是问题所在。</p>
         <p class="indent">代理问题的选择对自适应学习系统的工作方式至关重要。更重要的是，与自适应学习系统作为客观系统的宣传相反，在为推荐选择代理问题时，艺术多于科学<sup>4</sup>。</p>
         <h3 style="text-align: left">并非所有技术都是高科技</h3>
         <p class="no-indent">正如我们所见，自适应学习系统的开发需要做出许多决策——测量哪些数据，如何使用这些数据来评估反馈和其他信息，优化哪些目标以及使用什么算法来优化这些目标。参与这些决策的通常是程序员、数据科学家、金融和营销专家。在开发过程中，教师和教育专家的参与很少，而且通常是在设计过程之后才参与<sup>2</sup>。产品在被学校采用之前没有经过实地测试，其宣称的有效性通常基于推荐和传闻，而不是科学研究<sup>2</sup>。</p>
         <p class="indent">因此，学校需要什么以及熟悉什么对软件公司正在开发什么影响不大。成本、可用性和基础设施对学校的购买能力有重大影响。在决定是否使用或如何使用某一特定产品时，必须牢记这一点。也许最好不要将它们全部视为自适应学习系统或AI，而是目标、设计和能力截然不同的单个系统。</p>
         <p class="indent">自适应学习系统作为一个整体，可以用于个性化反馈、教学支持和练习。它们可以发现学习中的不足，并在编程和设计允许的范围内加以弥补。它们无法检测“可教的时刻”，或何时应该利用课堂气氛引入一个新的想法或例子。而使学习变得神奇并帮助在学生的脑海中留下关于课程的深刻影响，这完全是人类教师的专长。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> Bulger M., <em>Personalised Learning: The Conversations We’re Not Having</em>, Data &amp; Society Working Paper, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Groff, J., <em>Personalized Learning: The state of the field and future directions</em>, Center for curriculum redesign, 2017.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Holmes, W., Anastopoulou S., Schaumburg, H &amp; Mavrikis, M., <em>Technology-enhanced personalised learning: untangling the evidence</em>, Stuttgart: Robert Bosch Stiftung, 2018.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Covington, P., Adams, J., Sargin, E., <em>Deep neural networks for Youtube Recommendations</em>, Proceedings of the 10th ACM Conference on Recommender Systems, ACM, New York, 2016.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <em><a href="https://fairmlbook.org/" target="_blank" rel="noopener" data-cke-saved-href="https://fairmlbook.org/">Fairness and machine learning Limitations and Opportunities</a>, </em>MIT Press, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>Konstan, J., Terveen, L., <em>Human-centered recommender systems: Origins, advances, challenges, and opportunities</em>, AI Magazine, 42(3), 31-42, 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>Davidson, J., Liebald, B., Liu, J., Nandy, P., Vleet, T., <em>The Youtube Video Recommendation System</em>, Proceedings of the 4th ACM Conference on Recommender Systems, Barcelona, 2010.</p>
    </section>
</div>
<div data-type="part" class="part" id="part-on-generative-ai">
    <header>
         <h1 class="part-title">关于生成式人工智能</h1>
         <p data-type="subtitle" class="part-number">VI</p>
    </header>
    <p class="no-indent">        一些教育工作者一直梦想着技术能解决教育所有问题。然而，实际实现的却是学生解决所有作业和考试问题的梦想。</p>
    <p class="indent">每天都有新的文章、播客或政策建议发布，讨论如何应对生成式人工智能。学校和学区谈论如何使他们的教室免受ChatGPT的影响。工会正在罢工，以保护他们的工作，也就是使那些欢欣鼓舞的学生们未来的工作，免受这个被认为能聊天、绘画和变出“奇迹”的生成式人工智能的影响。是的，这一切都在一些专家发出世界末日警告的同时发生。<br />
     我们希望这一章能帮助你理解这项颠覆性技术的可能优势和缺点。</p>
    <section data-type="chapter" class="chapter" id="chapter-an-introduction-to-generative-ai" title="生成式和对话式人工智能的介绍">
         <header>
              <h1 class="chapter-title">生成式和对话式人工智能的介绍</h1>
              <p data-type="subtitle" class="chapter-number">34</p>
         </header>
         <h2 class="chapter-author">John Hurley 和 Michael Hallissy</h2>
         <h3 style="text-align: left">历史</h3>
         <p class="no-indent">在2022年11月下旬，ChatGPT在全世界推出，这是一个基于GPT-3.5的<a href="https://pressbooks.pub/aiforteachers/chapter/415/" target="_blank" rel="noopener">语言模型</a>的人工智能（AI）聊天机器人系统。它使用自然语言处理（NLP）来生成对话<sup>1</sup>。ChatGPT是一系列此类工具中的最新成员，但与以往的工具不同，它吸引了公众的兴趣和想象力。由于其生成类人文本的能力，以及在教育、工作场所和日常生活中的潜在应用和影响，它在发布一周内就拥有了超过一百万的用户。ChatGPT可以回答问题并协助您完成撰写电子邮件、论文和代码等任务<sup>2</sup>。</p>
         <p class="indent">GPT-3（生成式预训练变换器-3）是一个大型语言模型（LLM），在大量数据（4990亿数据点 &#8211; 800GB数据）上通过<a href="https://pressbooks.pub/aiforteachers/chapter/deep-neural-networks/" target="_blank" rel="noopener">深度学习</a>训练出来的。这个模型比以往任何模型都要大上百倍<sup>3</sup>。ChatGPT可通过该模型实现类人对话。一个大型语言模型经过训练，可以预测句子中的下一个单词，这与文本消息自动完成功能的工作方式有些类似。它将继续这一过程来生成更多文本。</p>
         <figure id="attachment_893" aria-describedby="caption-attachment-893" style="width: 1024px" class="wp-caption alignnone">
              <img class="wp-image-893 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-1024x316.png" alt="" width="1024" height="316" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-1024x316.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-300x93.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-768x237.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-65x20.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-225x69.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1-350x108.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/34-1.png 1536w" sizes="(max-width: 1024px) 100vw, 1024px" />
              <figcaption id="caption-attachment-893" class="wp-caption-text">生成式人工智能（AI）时间线</figcaption>
         </figure>
         <p class="no-indent">自其问世以来，生成式AI工具的创建和发展取得了取得了许多进展。我们在上面的图示中捕捉了其中的一些。在2022年11月之前，很少有人知道什么是生成式人工智能。突然之间，像ChatGPT这样的术语成为了许多人的日常术语，尤其是教育界人士。种种迹象表明，这些技术将继续发展，并对教育领域的所有人变得更有用。</p>
         <h3 style="text-align: left">生成式AI &#8211; 它们是什么？</h3>
         <p class="no-indent">生成式AI系统以图像、文本、音频、视频等形式创建新内容：</p>
         <ul>
              <li style="list-style-type: none">
              <ul>
                   <li>图像：生成式AI可以基于现有图像创建新图像，例如基于某人的面部创建新肖像，或基于现有风景创建新景观；</li>
                   <li>文本：生成式AI可用于撰写新闻文章、诗歌甚至剧本。它可以将文本从一种语言翻译成另一种语言；</li>
                   <li>音频：生成式AI可以生成新的音乐曲目、音效和配音<sup>4</sup>。</li>
              </ul>
               </li>
         </ul>
         <p>各种可能性还在不断增加，但让我们先来问问一些生成式AI工具，ChatGPT的名字是怎么来的。</p>
         <h3 style="text-align: left">但名字有何含义？</h3>
         <p class="no-indent">生成式AI工具有多种用途，所以让我们给几个工具 &#8211; Bing Chat、ChatGPT 3.5和Google Bard以下提示：</p>
         <div class="textbox shaded">
              <h5 style="text-align: left">你是AI教育的专家。想象你正在向10到14岁的儿童解释ChatGPT是什么以及它是如何得名的，解释为什么它包含“chat”这个词，并展示一些它在教育中可以如何使用的例子。将你的输出写成一篇有说服力的文章，解释ChatGPT</h5>
         </div>
         <p class="indent" style="text-align: left">这是Bing Chat创建的：</p>
         <div class="textbox">
              <h5 style="text-align: left"><em>“ChatGPT”这个名字来自于“chat”和“GPT”两个词。“Chat”意味着以友好和非正式的方式与某人交谈。“GPT”代表“生成式预训练变换器”，是一种表明ChatGPT非常擅长创建</em><em>文本、图像和声音等</em><em>新事物的高级说法。</em></h5>
         </div>
         <p class="indent" style="text-align: left">这是ChatGPT创建的：</p>
         <div class="textbox">
              <h5 style="padding-left: 40px;text-align: left"><em>现在，你可能想知道为什么它叫ChatGPT。之所以叫‘Chat’，是因为它喜欢与人聊天。你可以输入一个问题或一个话题，它会尽力给你一个有意义的答案。这有点像和一个无所不知的朋友交谈！此外，它还非常擅长用不同的语言聊天，这使它对全世界的孩子们都非常有帮助。</em></h5>
              <h5 style="padding-left: 40px;text-align: left"><em>‘GPT’部分有点复杂。它的意思是“生成式预训练变换器”，但你不需要记住这个绕口令。基本上，这意味着ChatGPT通过阅读大量的书籍、文章和网站来学习，就像你在学习时一样。就像它上了很长时间的学，成为了各种学科的专家一样！</em></h5>
         </div>
         <p class="indent" style="text-align: left">这是Bard创建的：</p>
         <div class="textbox">
              <h5 style="padding-left: 40px;text-align: left"><em>ChatGPT是一种称为大型语言模型的人工智能（AI）。这意味着它在大量的文本和代码数据集上接受了训练，因此能够生成文本、翻译语言、编写不同类型的创意内容，并以信息丰富的方式回答你的问题。</em></h5>
              <h5 style="padding-left: 40px;text-align: left"><em>那么，为什么ChatGPT会包含“chat”这个词呢？嗯，因为它的设计目的就是与人进行对话！你可以向ChatGPT提出任何问题，它会尽力以全面和有帮助的方式回答它们。你甚至可以通过让它写故事、诗歌或甚至代码来与ChatGPT进行有趣的互动。</em></h5>
         </div>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>发现更多！</strong></p>
              </header>
              <div class="textbox__content">
                   你听说过<a href="https://pressbooks.pub/aiforteachers/chapter/understanding-the-debates-about-the-possible-dangers-of-ai/" target="_blank" rel="noopener">关于生成式人工智能的辩论</a>吗？
              </div>
         </div>
         <p class="no-indent">这些工具允许我们编写提示，然后与ChatBot进行对话（对话式人工智能）。我们在教科书中提到了这些工具可以如何帮助教师、学生和管理人员开展教育和培训的一系列方式。这些方式可以让你进行对话，所以想想这些方式可以通过哪些方式帮助你或你的学习者——你可以就你需要研究的课题进行对话，或为面试做准备，或为课程或论文出谋划策。比较和对比它们各自创建的成果，然后挑选出适合你的目的最佳片段，这很有趣。</p>
         <p class="indent">当把人的能力和机器的能力结合起来时，这些工具可以“增强”或帮助你变得更有创造力、生产力和效率。所以一定要记得批判性地评估它产生的内容。因此，请尽情学习如何与这些工具进行对话，看看它们能产生什么效果，是否对你和你的学生有用。</p>
         <h3 style="text-align: left">数字中的生成式人工智能<sup>5</sup></h3>
         <p class="no-indent">下图<sup>6</sup>显示了ChatGPT从2022年11月到2023年5月的崛起。它在发布后的第一周就获得了一百万用户。值得注意的是，Netflix花了3.5年时间达到类似的里程碑，Twitter则花了两年时间<sup>7</sup>。</p>
         <figure id="attachment_894" aria-describedby="caption-attachment-894" style="width: 612px" class="wp-caption aligncenter">
              <img class="wp-image-894" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536.jpg" alt="" width="612" height="488" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536.jpg 1108w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-300x239.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-1024x816.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-768x612.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-65x52.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-225x179.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142536-350x279.jpg 350w" sizes="(max-width: 612px) 100vw, 612px" />
              <figcaption id="caption-attachment-894" class="wp-caption-text">ChatGPT统计数据由tooltester提供，根据CC BY 4.0许可。要查看此许可的副本，请访问<a href="https://creativecommons.org/licenses/by/4.0/https://creativecommons.org/licenses/by/2.0/?ref=openverse">https://creativecommons.org/licenses/by/4.0/https://creativecommons.org/licenses/by/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">虽然ChatGPT在2023年5月达到了顶峰，但它的受欢迎程度依然不减，其他生成式人工智能工具如Bing Chat和Bard也在受到关注。就Bing Chat而言，当微软在2023年3月收购ChatGPT时，它开始变得更受欢迎，而Bard的受欢迎程度则随着时间推移而继续增长。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup><a href="https://www.forbes.com/sites/bernardmarr/2022/12/21/chatgpt-everything-you-really-need-to-know-in-simple-terms/?sh=16674aadcbca" target="_blank" rel="noopener">https://www.forbes.com/sites/bernardmarr/2022/12/21/chatgpt-everything-you-really-need-to-know-in-simple-terms/?sh=16674aadcbca</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup><a href="https://www.zdnet.com/article/what-is-chatgpt-and-why-does-it-matter-heres-everything-you-need-to-know/" target="_blank" rel="noopener">https://www.zdnet.com/article/what-is-chatgpt-and-why-does-it-matter-heres-everything-you-need-to-know/</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup><a href="https://hai.stanford.edu/news/how-large-language-models-will-transform-science-society-and-ai" target="_blank" rel="noopener">https://hai.stanford.edu/news/how-large-language-models-will-transform-science-society-and-ai</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup><a href="https://www.weforum.org/agenda/2023/02/generative-ai-explain-algorithms-work/" target="_blank" rel="noopener">https://www.weforum.org/agenda/2023/02/generative-ai-explain-algorithms-work/</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup><a href="https://research.aimultiple.com/generative-ai-applications/" target="_blank" rel="noopener">https://research.aimultiple.com/generative-ai-applications/</a></p>
         <p class="hanging-indent" style="text-align: left"><span style="font-size: 12.6933px">6 </span><a href="https://www.tooltester.com/en/blog/chatgpt-statistics/" target="_blank" rel="noopener">https://www.tooltester.com/en/blog/chatgpt-statistics/</a></p>
         <p class="hanging-indent" style="text-align: left"><span style="font-size: 12.6933px">7 </span><a href="https://bootcamp.uxdesign.cc/chatgpt-vs-bing-chat-which-is-better-2e46fa821d7d" target="_blank" rel="noopener">https://bootcamp.uxdesign.cc/chatgpt-vs-bing-chat-which-is-better-2e46fa821d7d</a></p>
         <p class="hanging-indent" style="text-align: left"></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-generative-for-the-classroom" title="面向课堂的生成式AI，第1部分">
         <header>
              <h1 class="chapter-title">面向课堂的生成式AI，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">35</p>
         </header>
         <p class="no-indent">“当有人建议你尝试使用生成式人工智能工具进行某项活动时，你会怎么做？当你有一个活动的想法，但不确定如何调整改进时，你会怎么做？”</p>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>发现更多！</strong></p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/generative-ais-where-should-a-teacher-use-them/" target="_blank" rel="noopener">阅读我们为什么暂时没有把学生包括在内</a>
              </div>
         </div>
         <p class="no-indent">在此，我们的目标是帮助你评估、选择和开展这类活动。</p>
         <p class="indent">由于这项技术发展迅速，且其性能随着学科和环境的变化而变化，因此无法事先列出教师需要询问的所有问题。我们仅希望能让你按照已发布指南推荐的思路开始工作，这些思路得到了研究和案例研究的支持。</p>
         <p class="indent">请注意，在本书中，我们仅关注教师而非学生与生成式人工智能互动的活动。图框中提供的链接中解释了我们这么做的原因。</p>
         <p><img class="aligncenter wp-image-933 size-full" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4.png" alt="" width="4430" height="3132" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-350x247.png 350w" sizes="(max-width: 4430px) 100vw, 4430px" /></p>
         <p class="no-indent">即使你不相信生成式人工智能工具应该在教育中占有一席之地，我们也建议你至少尝试一项使用生成技术的活动。它可能会帮助你：</p>
         <ul>
              <li>了解使用生成式人工智能提供的工具能做什么以及不能做什么；</li>
              <li>重新构思或安排课程元素，特别是在决定哪些作业可以做，哪些作业不可以做时。例如，ChatGPT可以有效帮助学生写作文<sup>1</sup>，因此布置标准作文作为家庭作业可能是徒劳的。你可能需要使用多种评估方法，如小组项目、实践活动和口头报告，而不是简单的“是”或“否”问题<sup>1</sup>；</li>
              <li>了解这项技术的局限性，以便使用它们激励学生发挥自己的想象力和创造力<sup>2</sup>；</li>
              <li>当具有更先进功能的下一代技术出现时，不会感到落后；</li>
              <li>利用它们减轻你的工作负担，并探索以前可能过于困难或耗时的新课题；</li>
              <li>利用新流派的思维方式和学习方法；</li>
              <li>帮助研究和开发这些工具在教育领域的应用<sup>3</sup>。</li>
         </ul>
         <p class="no-indent">同时，鉴于技术和方法的新颖性，我们强烈建议您将任何活动的具体情况及其演变记录在日记里。这将帮助您监控和评估每项活动的短期和长期效果，并与同事讨论你所观察到的情况。</p>
         <h3 style="text-align: left">关于教学法和实践的问题</h3>
         <p class="no-indent">任何人都可以为课堂提出活动建议。他们可能来自技术界，对课堂情况了解不多。或者，这可能是一个适合大学生但不适合青少年的想法。即使活动适合你的课堂，如果没有可靠的教学理论和课堂实证支持，长期来看可能会产生一些意外。因此，我们鼓励你带着对教学法和实用性的疑问去开展任何活动。</p>
         <p>&nbsp;</p>
         <p><img class="aligncenter wp-image-933" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4.png" alt="" width="734" height="519" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.2-4-350x247.png 350w" sizes="(max-width: 734px) 100vw, 734px" /></p>
         <h3 style="text-align: left">关于生成式AI的问题</h3>
         <p class="no-indent">生成式AI应用的核心是大语言模型（LLM）或图像模型（扩散模型）。正如语言学家诺姆·乔姆斯基（Noam Chomsky）所说，“大致而言，它们[大语言模型]处理海量数据，寻找其中的模式，并变得越来越擅长生成统计上可能的输出，例如看似人类的语言和思维<sup>4</sup>。”BERT、BLOOM、GPT、LLaMA和PaLM都是大语言模型。对应的图像深度学习模型称为扩散模型。Stable Diffusion和Midjourney是流行的例子。</p>
         <p class="indent">母公司或第三方都可能对大语言模型(LLM)进行进一步训练(微调)以完成特定任务，如回答问题和总结文章。或者,他们可能对LLM或聊天机器人进行少量提示编程或大量编程，并将结果作为应用程序包发布（Chatpdf、Elicit、Compose AI、DreamStudio、NightCafe、PhotoSonic、Pictory）。</p>
         <p class="indent">为了制作ChatGPT，OpenAI对GPT3和GPT4进行了微调。它使用了提示-响应样本和内容可接受性规则。谷歌研究团队用科学和数学数据训练了PaLM，从而得到了Minerva。该语言模型随后在解决定量推理问题的语言模型应用中取得了最先进的结果。它能够解决近三分之一的本科层次物理、生物、化学和经济学等科学领域的问题，以及其他需要定量推理的科学领域<sup>5</sup>。</p>
         <p class="indent">针对教育用途对Ed-GPT等语言模型进行微调<sup>2  </sup>，还需要进一步工作，如添加学科知识和去偏差。</p>
         <p class="indent">语言模型是否已针对特定任务进行了微调，将影响其在该任务上的效能<sup>6</sup>。整套模型是由单一公司提供（OpenAI的ChatGPT），还是由另一家公司进一步开发，都将影响安全性和数据隐私。在探索使用哪种模型时，最好同时了解核心模型的成功之处和局限性，以及谁对它做了什么。</p>
         <p><img class="aligncenter wp-image-934" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3.png" alt="" width="733" height="518" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.3-350x247.png 350w" sizes="(max-width: 733px) 100vw, 733px" /></p>
         <p>&nbsp;</p>
         <h3 style="text-align: left">关于它是否适合你和你的课堂的问题</h3>
         <p class="no-indent">一个活动可能会实现其所有目标，所使用的生成式AI工具可能是最好和最符合伦理标准的，但活动仍然需要进行调整，以适应你的课堂。就像任何AI工具一样，你可能需要进行多次迭代才能实现你的目标<sup>2</sup>。你可能需要对提示技巧和输出结果的批判性评估进行培训和练习<sup>1</sup>。此外，整个体验应该让你受益匪浅，并符合你作为教师的价值观。</p>
         <p><img class="aligncenter wp-image-935" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4.png" alt="" width="733" height="518" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-34.4-350x247.png 350w" sizes="(max-width: 733px) 100vw, 733px" /></p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Tlili, A., Shehata, B., Adarkwah, M.A. et al, <em>What if the devil is my guardian angel: ChatGPT as a case study of using chatbots in education</em>, Smart Learning Environments, 10, 15 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, UNESCO, Paris, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Becker, B., et al, <em>Programming Is Hard – Or at Least It Used to Be: Educational Opportunities and Challenges of AI Code Generation</em>, Proceedings of the 54th ACM Technical Symposium on Computer Science Education V. 1 (SIGCSE 2023), Association for Computing Machinery, New York, 500–506, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Chomsky, N., Roberts, I., Watumull, J., <em>Noam Chomsky: The False Promise of ChatGPT</em>, The New York Times, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Lewkowycz, A., Andreassen, A., Dohan, D. et al, <em>Solving Quantitative Reasoning Problems with Language Models</em>, Google Research, 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>Enkelejda, K., et al, <em>Chatgpt for Good? on Opportunities and Challenges of Large Language Models for Education</em>, EdArXiv, 2023.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-generative-ai-for-the-classroom-part-ii" title="面向课堂的生成式AI，第2部分">
         <header>
              <h1 class="chapter-title">面向课堂的生成式AI，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">36</p>
         </header>
         <h3 style="text-align: left">使用生成式AI进行活动的一些想法</h3>
         <h3 style="text-align: left">1. 在课程中使用生成式AI进行课程计划与设计</h3>
         <p class="no-indent">您是否想要重新设计您的一些课程，引入新主题，开展新活动以及在如何评估这些活动结果的评分标准方面获得新思路<sup>1,2</sup>？您是否想尝试一种新的教学方法，使用新技术和材料<sup>3</sup>？聊天机器人可能为上述所有问题提供帮助。您可以指导软件编写课程计划初稿、学习目标、活动指导、项目和科学实验以及讨论提示<sup>4</sup>。</p>
         <p class="no-indent"><strong>提示：</strong>最好事先明确要涵盖哪些话题和方法，以及课程或课程将实现的目标——无论是针对的概念还是程序，以及要采取哪种教学方式<sup>2</sup>。</p>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent"><strong>来源：</strong>在ChatGPT中考察科学教育：生成式AI的探索性研究<sup>5</sup></p>
                   <p class="no-indent"><strong>活动：</strong>创建教学单元</p>
                   <p class="no-indent"><strong>生成式AI工具：</strong>ChatGPT</p>
                   <p class="no-indent"><strong>使用的提示：</strong>使用5Es模型创建一个教学单元，该单元对于那些对可再生能源和非可再生能源具有深刻理解的七年级学生具有挑战性。同时为那些遇到困难的学生提供支持和脚手架。</p>
                   <p class="no-indent"><strong>反思：</strong>作为一个起点，作者发现ChatGPT的回答很有用。为了满足学生的需求、课程和获取资源，必须对其进行调整。他建议教育工作者应删除无益的部分，并在有帮助的部分上继续进行构建。尽管输出内容需要精炼，但他认为许多教师会发现它很有用，特别是那些刚开始职业生涯的教师，因为他们可能还没有建立广泛的资源。</p>
                   <p class="no-indent">&#8220;我特别对其生成一个以5Es模型为基础的科学单元的能力印象深刻，即使其中一些输出看起来有点宽泛并需要进一步的精炼<em>。</em>&#8220;</p>
              </div>
         </div>
         <h3 style="text-align: left">2. 使用生成式AI准备引人入胜、多模式和包容性的主题内容</h3>
         <p>您可以使用生成式AI应用来：</p>
         <ul>
              <li>添加与当地现象、语言和文化相关的内容；</li>
              <li>插入具有解释性和吸引力的图片和视频<sup>3</sup>；</li>
              <li>创建并加入故事，强化文字内容；</li>
              <li>绘制概念图；</li>
              <li>突出、转述和总结课程的相关部分，并澄清词汇<sup>6</sup>；</li>
              <li>通过展示模拟演示和举例说明其他科目的例子，使数学和科学变得不那么抽象。这也可以用于手工艺教育，其中可视化可以帮助开发和探索想法<sup>7</sup>；</li>
              <li>提供翻译，以帮助使用少数语言的学习者<sup>2</sup>。</li>
         </ul>
         <p class="no-indent"><strong>提示：</strong>Midjourney和其他图像创建工具经常有专门的论坛，人们在那里发布他们的作品、建议、提示和提示制作技巧<sup>7</sup>。这对于刚开始探索这项技术的教师很有帮助。</p>
         <h3 style="text-align: left">3. 使用生成式AI创建示例、练习题和测验</h3>
         <p class="no no-indent">生成式AI可以：</p>
         <ul>
              <li>生成表格和其他形式的数据，用于示例和练习；</li>
              <li>创建练习题和答案，特别是用于巩固基础技能和知识水平较低的部分<sup>8</sup>。这些可以作为学生在解决作业问题遇到困难时的参考<sup>9</sup>；</li>
              <li>生成答案的解释。这似乎很有效，特别是对于生成编程代码的解释<sup>9</sup>；</li>
              <li>为数学或编程中的同一问题生成多种解决方案。这有助于学生学习不同的方法和视角，并分析不同方法的优缺点<sup>9</sup>。即使提供的解决方案是错误的，如果明确标出，也可能有帮助。</li>
         </ul>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent"><strong>来源：</strong>在ChatGPT中考察科学教育：生成式人工智能的探索性研究<sup>5</sup>。</p>
                   <p class="no-indent"><strong>活动：</strong>创建测验。</p>
                   <p class="no-indent"><strong>生成式AI工具：</strong>ChatGPT。</p>
                   <p class="no-indent"><strong>使用的提示：</strong>生成一个七年级水平的关于可再生能源和非可再生能源概念的测验，并附上答案。</p>
                   <p class="no-indent"><strong>反思：</strong>作者发现，ChatGPT生成的多项选择题能够评估学生对该主题的理解。他说，“教育工作者需要批判性地评估任何资源&#8230; 教师的专业知识、经验和对学生的了解仍然是做出合理教学决策的关键。”</p>
              </div>
         </div>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent"><strong>来源：</strong>在ChatGPT中考察科学教育：生成式人工智能的探索性研究<sup>5</sup>。</p>
                   <p class="no-indent"><strong>活动：</strong>创建评分标准。</p>
                   <p class="no-indent"><strong>生成式AI工具：</strong>ChatGPT。</p>
                   <p class="no-indent"><strong>使用的提示：</strong>创建一个评分量规，供七年级学生来自我评估他们对可再生能源和非可再生能源的学习情况（后续的格式要求：使这个评分量规更容易以整洁的格式复制到Word中）。</p>
                   <p class="no-indent"><strong>输出：</strong></p>
                   <figure id="attachment_901" aria-describedby="caption-attachment-901" style="width: 1024px" class="wp-caption aligncenter">
                        <img class="wp-image-901 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-1024x381.jpg" alt="" width="1024" height="381" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-1024x381.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-300x112.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-768x286.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-65x24.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-225x84.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116-350x130.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616143116.jpg 1099w" sizes="(max-width: 1024px) 100vw, 1024px" />
                        <figcaption id="caption-attachment-901" class="wp-caption-text">由ChatGPT生成的评分标准输出，来自《在ChatGPT中考察科学教育：生成式人工智能的探索性研究》</figcaption>
                   </figure>
                   <p class="no-indent"><strong>反思：</strong>作者发现，ChatGPT能够创建自己的评分标准——理解、研究、批判性思维和参与。每个标准都标注了等级，但每个标准的指标过于模糊。</p>
              </div>
         </div>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent"><strong>来源：</strong>机器人来了：探索OpenAI Codex对入门编程的影响<sup>10</sup>。</p>
                   <p class="no-indent"><strong>活动：</strong>为一个问题生成多种解决方案。</p>
                   <p class="no-indent"><strong>生成式AI工具：</strong>Codex（Codex可以根据提示用多种编程语言生成代码）。</p>
                   <p class="no-indent"><strong>使用的提示：</strong>各种来源和考试题目中要求学生编写代码的问题描述。</p>
                   <p class="no-indent"><strong>输出</strong>:</p>
                   <figure id="attachment_546" aria-describedby="caption-attachment-546" style="width: 321px" class="wp-caption aligncenter">
                        <img class="wp-image-546" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-3-result.png" alt="" width="321" height="282" />
                        <figcaption id="caption-attachment-546" class="wp-caption-text">学生在监考测试（测试1和测试2）中的成绩，以及Codex的得分（标记为红色星号），摘自《机器人来了：探索OpenAI Codex对入门编程的影响》</figcaption>
                   </figure>
                   <p><strong>反思：</strong>作者发现，Codex对同一提示给出了一系列不同的代码，“而最终倾向于对每个答案采用预期的方法”。</p>
              </div>
         </div>
         <h3 style="text-align: left">4 提高可访问性</h3>
         <p class="no-indent">作为最后一个例子，我们强烈建议您探索生成式AI，以增加对某些有身体或学习障碍学生的可访问性，特别是那些有听力或视力障碍的学生。生成式AI可以提供原文字幕、翻译字幕和音频描述<sup>2</sup>。根据联合国教科文组织的《生成式人工智能在教育和研究中的应用指南》，“GenAI模型还可以将文本转换为语音，将语音转换为文本，使视力、听力或语言障碍的人能够访问内容、提问并与同伴交流”<sup>2</sup>。它还可以帮助您验证所创建的内容是否包容和可访问<sup>4</sup>。</p>
         <h3 style="text-align: left">质疑输出</h3>
         <p class="no-indent">如果您决定使用生成式AI，您必须注意其失败和缺点，并随时纠正它们，包括：</p>
         <ul>
              <li style="text-align: justify">内容中的不准确性：语言模型不是知识库或搜索引擎。即使是最新的模型也会幻想事实和引用虚构的资料来源。错误会悄悄出现，特别是当使用语言模型进行数学和定量推理时。即使专门为这些学科进行微调，模型也可能产生错误的答案、计算错误和幻想“数学事实”<sup>11</sup>。甚至编程可能也很棘手，因为生成的代码可能存在语法错误和安全问题<sup>9</sup>。</li>
              <li style="text-align: justify">产生偏差的原因之一是，这些模型所依据的训练数据中充满了偏差。即使是进行修正的EdGPT，也可能仍然包含一些偏差<sup>2</sup>。</li>
              <li style="text-align: justify">性能可能会因使用的提示和用户历史记录而有很大差异，有时候甚至毫无缘由。</li>
         </ul>
         <p><img class="aligncenter wp-image-902" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1.png" alt="" width="733" height="518" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1.png 4430w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-300x212.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-1024x724.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-768x543.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-1536x1086.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-2048x1448.png 2048w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-65x46.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-225x159.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/CN-35.1-350x247.png 350w" sizes="(max-width: 733px) 100vw, 733px" /></p>
         <p class="no-indent">虽然生成式AI可以减轻教师的工作负担并帮助完成某些任务，但它基于从大量在线数据构建的统计模型。这些数据不能取代现实世界、其背景和关系。ChatGPT无法提供背景情况，也无法解释影响学生日常生活的因素<sup>4</sup>。它不能为现实世界的挑战提供新的想法或解决方案<sup>2</sup>。</p>
         <p class="indent">最后，它的性能并不接近人类大脑的能力，尤其是人类大脑对有限数据的理解和处理能力。生成式AI“最深的缺陷是缺乏任何智能最关键的能力：不仅要说出实际情况是什么、过去是什么情况和未来将是什么情况——那些是描述和预测——而且也要说出现在不是什么状况、可能是什么情况和不可能是什么情况<sup>12</sup>。”</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Tlili, A., Shehata, B., Adarkwah, M.A. et al, <em>What if the devil is my guardian angel: ChatGPT as a case study of using chatbots in education</em>, Smart Learning Environments, 10, 15 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, UNESCO, Paris, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Enkelejda, K., et al, <em>Chatgpt for Good? on Opportunities and Challenges of Large Language Models for Education</em>, EdArXiv, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Trust, T., Whalen, J., &amp; Mouza, C., <em><a href="https://citejournal.org/volume-23/issue-1-23/editorial/editorial-chatgpt-challenges-opportunities-and-implications-for-teacher-education" target="_blank" rel="noopener">Editorial: ChatGPT: Challenges, opportunities, and implications for teacher education</a>,</em> Contemporary Issues in Technology and Teacher Education, 23(1), 2023.</p>
         <p><sup>5</sup> Cooper, G., <em>Examining Science Education in ChatGPT: An Exploratory Study of Generative Artificial Intelligence</em>, Journal of Science Education and Technology, 32, 444–452, 2023.</p>
         <p><sup>6</sup> Kohnke, L., Moorhouse, B. L., &amp; Zou, D., <em>ChatGPT for Language Teaching and Learning</em>, RELC Journal, 54(2), 537-550, 2023.</p>
         <p><sup>7</sup> Vartiainen, H., Tedre, M., <em>Using artificial intelligence in craft education: crafting with text-to-image generative models</em>, Digital Creativity, 34:1, 1-21, 2023.</p>
         <p><sup>8</sup> Bhat,S., et al, <em>Towards automated generation and evaluation of questions in educational domains</em>, Proceedings of the 15th International Conference on Educational Data Mining, pages 701- 704, Durham, United Kingdom, 2022.</p>
         <p><sup>9</sup> Becker, B., et al, <em>Programming Is Hard – Or at Least It Used to Be: Educational Opportunities and Challenges of AI Code Generation</em>, Proceedings of the 54th ACM Technical Symposium on Computer Science Education V. 1 (SIGCSE 2023), Association for Computing Machinery, New York, 500–506, 2023.</p>
         <p><sup>10</sup> Finnie-Ansley, J., Denny, P. et al, <em>The Robots Are Coming: Exploring the Implications of OpenAI Codex on Introductory Programming</em>, Proceedings of the 24th Australasian Computing Education Conference (ACE ’22), Association for Computing Machinery, New York, 2022.</p>
         <p><sup>11</sup> Lewkowycz, A., Andreassen, A., Dohan, D. et al, <em>Solving Quantitative Reasoning Problems with Language Models</em>, Google Research, 2022.</p>
         <p><sup>12</sup> Chomsky, N., Roberts, I., Watumull, J., <em>Noam Chomsky: The False Promise of ChatGPT</em>, The New York Times, 2023.</p>
         <p class="hanging-indent">&lt;!&#8211;</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-of-assignments-and-assessments-2" title="ChatGPT及其对学校作业的潜在影响">
         <header>
              <h1 class="chapter-title">ChatGPT及其对学校作业的潜在影响</h1>
              <p data-type="subtitle" class="chapter-number">37</p>
         </header>
         <h2 class="chapter-author">John Hurley 和 Michael Hallissy</h2>
         <h3 style="text-align: left">AI的黎明</h3>
         <p class="no-indent">自ChatGPT<sup>1</sup>于2022年11月下旬推出以来，人们对AI技术，特别是像ChatGPT<sup>2</sup>这样的生成式AI工具对教育的潜在影响，进行了大量的猜测和讨论。这是一系列工具中最新的一种，许多人认为它有潜力颠覆我们学校中许多传统做法，特别是我们布置家庭作业的方法，而这些作业通常在课堂外、在家中完成。人们担心，像ChatGPT这样的AI工具会帮助学生作弊，如通过为学生写作论文，将文本从一种语言翻译成另一种语言，或在没有任何学生输入的情况下完成数学测评。但这是一种新的概念吗？一些国家和学区甚至最初禁止使用ChatGPT，但值得庆幸的是，他们现在正在撤销决定，并考虑如何让教师使用ChatGPT和其他生成式AI工具（如Bard、Midjourney和Bing Chat）<sup>3</sup>。</p>
         <figure id="attachment_148" aria-describedby="caption-attachment-148" style="width: 1024px" class="wp-caption aligncenter">
              <img class="wp-image-148 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-1024x759.png" alt="" width="1024" height="759" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-1024x759.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-300x222.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-768x569.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-65x48.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-225x167.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352-350x259.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch6-page-4-homework-e1700658500352.png 1382w" sizes="(max-width: 1024px) 100vw, 1024px" />
              <figcaption id="caption-attachment-148" class="wp-caption-text">裁剪自CyberMacs的《女性力量，书写未来——一个雄心勃勃的年轻学生利用女孩力量释放她的潜力，并在她的笔记本电脑上书写未来》，根据CC BY-NC-SA 2.0许可证授权。要查看此许可证的副本，请访问<a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <h3 style="text-align: left">让我们反思</h3>
         <p class="no-indent">这不是第一次，未来也不是最后一次，新技术将迫使我们考虑它们可能对教学、学习和评估实践有什么影响。在21世纪初，人们曾讨论过如何使用互联网进行搜索，通常只需要点击几次后就能获得答案。</p>
         <p class="indent" style="text-align: left">例如，随着互联网成为日常生活不可或缺的一部分，教育中出现了一个问题：当答案唾手可得时，我们该如何评估学习<sup>4</sup>？</p>
         <p class="indent">所以，让我们不要忘记，几十年来，互联网一直在影响着我们为学生布置家庭作业的方式。学生们可以在互联网上搜索某个主题，并将答案复制粘贴到他们的学校报告或演示文稿中。在此之前，人们曾讨论过文字处理器对学校写作过程的影响，以及计算器对数学教学和学习的使用。今天，谁还会考虑在不使用文字处理器进行写作，或在不使用数学计算器的情况下进行计算呢？我们已经将重点转移到更深层次的学习上——有了文字处理器，我们可以专注于起草，而在数学中，我们正在超越单纯的计算。有经验、有能力的教师将做出这些决定，并将这些技术融入到他们的课堂中。</p>
         <h3 style="text-align: left">对ChatGPT的恐惧</h3>
         <p class="no-indent">但许多人认为新的生成式AI工具， 如ChatGPT，会改变游戏规则，如上所述，一些学校系统<sup>5</sup>和高等教育机构甚至禁止使用它们，称“虽然该工具能够快速轻松地回答问题，但它无法培养批判性思维和解决问题的能力，而这些能力对于学业和终身成功至关重要”<sup>6</sup>。其他人则持不同观点，建议我们应该张开怀抱接受这些工具，并将它们创造性地融入我们的课堂，以便学生有机会发展这些批判性思维技能。哥伦比亚大学教师学院的数字创新副院长拉莉塔·瓦苏德文（Lalitha Vasudevan）认为，对于这些新数字工具，学校需要做出艰难的决定。她说，“这些决定应该在提高学生学习的范围内做出”<sup>7</sup>。这种观点日益增长，许多教育界人士认为，我们需要教育教师和学生如何最好地使用这些工具。</p>
         <p class="indent">生成式AI工具可以根据我们的提示快速给出答案，但这些答案并没有针对学生的学习进行优化<sup>8</sup>。它们可以将这些答案包装得很漂亮，但往往它们是错误的或包含错误的元素。因此，我们需要教育我们的教师和学生对它们产生的内容提出质疑。通过这种方式，我们可以使用这些工具来发展那些我们希望学生拥有的关键素养。因此，它们可以对我们如何设计和使用学生的家庭作业产生积极影响。</p>
         <h3 style="text-align: left">家庭作业的目的</h3>
         <p class="no-indent">让我们首先问一问，家庭作业的目的是什么？学校分配家庭作业有着悠久的历史，教师通常会引用以下原因<sup>9</sup>：</p>
         <ul>
              <li>家庭作业教会学生责任感；</li>
              <li>家庭作业为学生提供了练习和提炼技能的机会；</li>
              <li>家庭作业往往是家长的要求；</li>
              <li>家庭作业的数量常常被等同于严谨性和教师质量;；</li>
              <li>家庭作业是一种成长的仪式。</li>
         </ul>
         <p class="no-indent">然而，有关家庭作业对学生学习和家庭生活影响的研究结果<sup>9</sup>并不十分正面，有研究还发现家庭作业可能有负面影响。因此，教师应该始终考虑的关键问题是，“这项家庭作业会带来什么样的学习效果<em>？</em>”在提出这个问题时，教师还应该考虑新技术的发展，并考虑这些工具可能对作业的完整性产生怎样的影响。我们应该考虑以下因素：</p>
         <p class="indent">将来，家庭作业也许会有所不同。但就像搜索引擎、文字处理器和计算器一样，学校无法忽视技术的快速发展。最好的办法是是拥抱并适应变化，而不是抵抗（并且无法阻止）它<sup>10</sup>。</p>
         <p class="indent">有人甚至建议，像ChatGPT这样的工具可以为那些在家里没有太多支持或正在学习不同语言的学生提供更公平的竞争环境。其他人则建议，AI实际上可以提高标准，超越掌握知识，让学生进行更深层次的学习<sup>8</sup>。因此，生成式AI有潜力让我们创造新的评估形式，挑战我们的学习者，使他们成为更具批判性的学习者。</p>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>练习</strong></p>
              </header>
              <div class="textbox__content">
                   考虑一下如何可以以创造性的方式与学生一起使用ChatGPT（或其他生成式AI工具），使他们的家庭作业或课堂评估更有意义？
              </div>
         </div>
         <p class="no-indent">越来越多的人认为，像ChatGPT这样的生成式AI工具可以节省教师的时间，从而让他们更好地规划和设计学习活动，同时也帮助学生克服“空白页”的挑战。因为生成式AI工具擅长输出文本，教师和学生可以使用它们生成多种类型的内容，包括：</p>
         <ul>
              <li>教师的教案构思</li>
              <li>论文</li>
              <li>博客文本</li>
              <li>诗歌或歌词</li>
              <li>演示文稿</li>
              <li>计算机代码</li>
              <li>解决数学问题</li>
         </ul>
         <p class="no-indent">不过，请记住，虽然它们可以将这些包装得很精致，但它们可能并不总是准确或适当的。因此，我们需要批判性地审视它们的输出结果，然后决定哪些内容我们可以保留，哪些内容应该舍弃。归根结底，这些工具将继续存在，我们需要“教”我们的教师和学生相关知识，以便他们可以决定如何在各自的情境中最好地使用它们。这些工具清单及其功能仍在不断发展中，我们仍然不确定它们改变我们的教学、学习和评估的潜力。最终，还是要由教师决定这些工具对他们和他们的学习者是否有用。是时候开始使用这些工具了，以便了解它们是否可以节省你的时间，是否可以帮助你的学生发展在21世纪生活和工作所需的关键能力。</p>
         <p class="indent">要开始思考其他可能性，你可能想要查看<a href="https://nexus-education.com/blog/unleashing-the-power-of-chat-gpt-in-education/#" target="_blank" rel="noopener">这篇博客</a>，看看他们分享的一些想法，并考虑这些是否适用于你的情况。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup><a href="https://tinyurl.com/3sr2hy6y" target="_blank" rel="noopener">https://tinyurl.com/3sr2hy6y</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>2 </sup><a href="https://www.edweek.org/technology/with-chatgpt-teachers-can-plan-lessons-write-emails-and-more-whats-the-catch/2023/01" target="_blank" rel="noopener">https://www.edweek.org/technology/with-chatgpt-teachers-can-plan-lessons-write-emails-and-more-whats-the-catch/2023/01</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup><a href="https://www.nytimes.com/2023/06/26/technology/newark-schools-khan-tutoring-ai.html?action=click&amp;module=RelatedLinks&amp;pgtype=Article" target="_blank" rel="noopener">https://www.nytimes.com/2023/06/26/technology/newark-schools-khan-tutoring-ai.html?action=click&amp;module=RelatedLinks&amp;pgtype=Article</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup><a href="https://michiganvirtual.org/blog/how-will-artificial-intelligence-change-education/" target="_blank" rel="noopener">https://michiganvirtual.org/blog/how-will-artificial-intelligence-change-education/</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>5</sup> <a href="https://ny.chalkbeat.org/2023/1/3/23537987/nyc-schools-ban-chatgpt-writing-artificial-intelligence" target="_blank" rel="noopener">https://ny.chalkbeat.org/2023/1/3/23537987/nyc-schools-ban-chatgpt-writing-artificial-intelligence</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup><a href="https://www.washingtonpost.com/education/2023/01/05/nyc-schools-ban-chatgpt/" target="_blank" rel="noopener">https://www.washingtonpost.com/education/2023/01/05/nyc-schools-ban-chatgpt/</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>ibid</p>
         <p class="hanging-indent" style="text-align: left"><sup>8</sup><a href="https://hai.stanford.edu/news/ai-will-transform-teaching-and-learning-lets-get-it-right" target="_blank" rel="noopener">https://hai.stanford.edu/news/ai-will-transform-teaching-and-learning-lets-get-it-right</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>9 </sup><a href="https://www.ascd.org/blogs/whats-the-purpose-of-homework" target="_blank" rel="noopener">https://www.ascd.org/blogs/whats-the-purpose-of-homework</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>10 </sup><a href="https://theconversation.com/chatgpt-isnt-the-death-of-homework-just-an-opportunity-for-schools-to-do-things-differently-205053" target="_blank" rel="noopener">https://theconversation.com/chatgpt-isnt-the-death-of-homework-just-an-opportunity-for-schools-to-do-things-differently-205053</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-the-gears-of-generative" title="生成式AI的要素">
         <header>
              <h1 class="chapter-title">生成式AI的要素</h1>
              <p data-type="subtitle" class="chapter-number">38</p>
         </header>
         <h2 class="chapter-author">Fabrizio Falchi 和 Manuel Gentile</h2>
         <p class="no-indent">      最近的自然语言对话系统（如ChatGPT、Bard和LLAMa2-chat）利用大语言模型在短时间内大受欢迎，这引发了人们对多个方面的激烈辩论，这些争论至今仍未解决。 不可否认，探讨一个由相对简单的数学方程控制的计算系统如何能够产生被许多人称为“智能”的行为，这无疑是一个迷人的话题。</p>
         <p class="no-indent"><span style="text-align: initial;font-size: 1em">        然而,本章不会试图对诸如&#8221;大语言模型是否具有我们可定义为&#8217;智能&#8217;的行为&#8221;、&#8221;人类智能的本质是什么&#8221;、&#8221;我们如何定义创造力&#8221;等问题提供答案。尽管这些问题很有趣,但要想正确回答它们,需要进行更深入的调查研究。</span></p>
         <p class="indent">相反,我们将尝试提供一个面向非专业人士的概述,以促进人们对大语言模型背后机制的理解。只有通过对这些机制有更深入的认知,人们才能够理解它们的潜力以及可能带来的风险,并促进它们在教育等领域的正确使用。</p>
         <p class="indent"> 这里需要澄清一个广泛存在的误解,即这类系统基本上就是由问答对组成的大型数据库。这种错误观点源于多年来建立聊天机器人系统所采用的常见做法(我们建议您阅读相关章节)。但同时,这一想法也无法体现出大语言模型的生成性特点。</p>
         <p class="indent">语言模型是一种统计模型,能够根据给定的上下文(通常由预期单词前面的一组单词定义),计算出某个文本片段(通常是一个单词)出现的概率。</p>
         <p class="indent">使用纯统计方法构建的模型(如马尔可夫链,也称为n-gram模型)<sup>1</sup>,随着时间的推移逐渐被基于神经网络的语言模型所取代<sup>1</sup>。这些模型在网络结构和规模方面都发生了演化。</p>
         <p class="indent">大型语言模型（LLMs）之所以被这样命名，是因为它们基于在海量数据基础上训练出来的大型神经网络。</p>
         <p><a href="https://www.bilibili.com/video/BV1cJ4m1G7SV/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 为什么数据对人工智能如此重要？(Why is data so important for AI?)</a></p>
         <p class="no-indent">因此，我们在研究之初就声明，语言模型生成文本，而不是简单地从预构建的知识库中检索它们。</p>
         <p class="indent">LLM的生成性及其本质上的专家直觉性质使得我们难以预测它们对用户输入的响应方式。这一特性反映了人们对这类系统的普遍不信任，因为它们可能会生成虚假或不准确文本。</p>
         <p class="indent">因此，就机器理解和生成文本的能力而言，这一特性既是一项伟大技术成就，同时也是这类技术的主要危险之一。</p>
         <p class="indent">然而，让我们试着去发现这样的系统。</p>
         <p class="indent">像任何技术革命一样，这一突破背后的因素是多方面的。为简化起见，我们在提及主要因素的同时，也为读者提供了一些参考资料，以指导他们进行后续的深入研究：</p>
         <ul>
              <li><strong>网络规模</strong>：这是以网络内可训练参数的数量来衡量的。大语言模型是深度神经网络，其节点和层的数量惊人。为了给出一个数量级，该领域的一些专家将参数超过了100亿的语言模型称为“大”模型。为了给您一个具体的量级，GPT3模型有1500亿个参数，而LLAMa v2的最大版本大约有700亿。</li>
              <li><strong>网络架构</strong>：成功与否取决于网络的规模，以及神经网络的节点和不同层级之间的连接方式。经过再次简化，我们可以将<a href="https://pressbooks.pub/aiforteachers/chapter/transformers/" target="_blank" rel="noopener">变换器网络和注意力机制</a>确定为主要的架构创新，以帮助理解有效性的提升。</li>
              <li><strong>可用于训练的数据量</strong>：大量可用的数据无疑是训练此类模型的一个基本要素，但实际上，这一点在引入此类模型之前就已存在多年。因此，关键的创新因素在于训练技术以及从数据到训练集的选择和准备过程。这就是所谓的自我监督学习。</li>
              <li><strong>当前的计算能力</strong>：显然，计算能力的提高对扩大这些网络的规模发挥了决定性作用。经验似乎表明，规模因素正是这些行为出现的基本参数之一。</li>
              <li><strong>调整机制</strong>：另一个经常被忽视的因素是调优机制，它是构建此类模型过程中的最后一步。具体而言，我们指的是具有人类反馈和排名的强化学习机制。这些机制有助于定义模型，并用于产生更符合用户意图的响应。除此之外，我们还可以添加微调过程，以便在执行特定任务时对这些网络的行为进行专业化和改进。</li>
              <li><strong>安全机制</strong>：除深度学习模型外，还有一些专门技术，旨在减轻系统在不安全输入时的脆弱性，并防止在安全和不安全输入时出现不希望的行为。</li>
         </ul>
         <p class="no-indent">此时，了解了LLM的不同特点，我们只需在我们的教育环境中对这些系统进行测试，来探索它们的潜力。因此，尝试与ChatGPT或Bard对话，帮助创建新的练习并根据我们学生的具体需求进行调整，创建包含相关内容的新教案，等等。这取决于你的创造力以及你如何学会与这些系统对话。</p>
         <p class="no-indent"><strong>注意</strong>：每个因素都需要适当阐述。如有兴趣，我们将提供一份参考资料清单。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Bengio, Y., Ducharme, R., &amp; Vincent, P., <em>A neural probabilistic language model</em>. Advances in neural information processing systems, 13, 2000.</p>
         <p class="hanging-indent"><sup>2</sup> Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., … &amp; Polosukhin, I., <em>Attention is all you need</em>, Advances in neural information processing systems, 30, 2017.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-of-assignments-and-assessments" title="提示的艺术、技巧或科学">
         <header>
              <h1 class="chapter-title">提示的艺术、技巧或科学</h1>
              <p data-type="subtitle" class="chapter-number">39</p>
         </header>
         <h2 class="chapter-author">Bastien Masse</h2>
         <p class="no-indent">在本节中，我们的目标是开发一种方法论，使我们能够使用一系列步骤、技巧和窍门来制定有效的提示（prompt）。需要注意的是，生成式AI系统可以产生多种输出（如图像、文本、代码、网站、视频等）。每个平台都有其自身的优势和局限性，并基于特定的逻辑运行。因此，首先要确保使用正确的模型来完成正确的工作。下面的指南是适用于大多数场景的最佳实践。</p>
         <p class="indent">让我们首先定义什么是一个“好的提示”。理想情况下，我们希望：</p>
         <ul>
              <li>提示所产生的答案能够在内容、形式和精确度方面满足我们的需求；</li>
              <li>提供的信息准确、有效或至少可验证；</li>
              <li>生成的结果可复制；</li>
              <li>在提供制定提示所需的必要细节时采取简约方法。</li>
         </ul>
         <h3 style="text-align: left">步骤1：定义你期望的结果</h3>
         <p class="no-indent">如同任何研究一样，初步规划至关重要。你必须清楚地了解你期望的输出是什么。这可能是一条简单的信息，也可能是您希望产生的特定类型的内容：无论是独特措辞的文本、图像中的艺术风格、可下载的代码，还是数据表。AI生成的内容类型多种多样，很大程度上取决于您的请求的具体性。因此，请事先明确您的意图：</p>
         <ul>
              <li>我搜索的目的和目标是什么？</li>
              <li>我将如何使用生成的回复？</li>
              <li>对产生的结果是否有特定的约束或要求？</li>
         </ul>
         <p class="no-indent">例如，在图书馆中，我们不会随机拿起书籍，希望找到所需的确切信息。提示就像是向图书管理员询问特定数据一样,无论是机器还是人类,在处理请求之前都需要某些信息。</p>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p class="no-indent"><strong>目标</strong>：使用文本生成AI为我的学生设计练习题。</p>
                   <p class="no-indent"><strong>用途</strong>：在课堂上分发的练习题。</p>
                   <p class="no-indent"><strong>格式</strong>：针对二年级学生的不规则动词英语练习题</p>
              </div>
         </div>
         <h3 style="text-align: left">步骤2：提供语境</h3>
         <p>语境背景是生成式人工智能的基础。始终记住，你的提示将作为AI构建其响应的语义框架。它所做的一切都基于根据你的提示构建一个逻辑连贯和可能的语序。因此，在这一关键步骤中，你可以通过你的用词选择、引用或提示来指导AI。语境越强，你就越有可能收到符合你期望的响应。就像图书管理员的工作，如果知道你是不是高中老师或初中生，你是否已经对主题有所了解，你将如何使用内容，以及你是否有特定的格式要求，那么工作就会变得简单得多。花时间精确而全面地表达你的请求：目的、学习目标、目标受众/水平、期望的行动、格式（大纲、列表、思维导图、语法、语言水平……）。</p>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <p>“我是一名小学教师。我希望为我的二年级学生（6至7岁）制作一个课堂练习。这个练习应该涵盖英语中的不规则过去式动词。请提供一个包含10道题的填空文本，并在其后附上批改。”</p>
              </div>
         </div>
         <h3 style="text-align: left">步骤3：分析、验证和批判性思考</h3>
         <p class="no-indent">一旦AI作出初步响应，可能会出现两种情况：</p>
         <ul>
              <li style="font-weight: 400;text-align: justify">响应在质量、形式或内容方面不符合您的期望，或AI表示它无法满足您的请求。在这种情况下，请考虑重新措辞、提供更多上下文信息，或进一步明确您的需求。了解平台的能力和局限性（例如，平台拒绝为您提供外部链接或某些格式）也很有好处。</li>
              <li style="font-weight: 400;text-align: justify">回复大致符合你的期望。在此，根据您的知识验证所提供的信息，或与外部来源进行交叉引用。如有必要，可以进一步深入与AI探讨更多细节或来源。</li>
         </ul>
         <h3 style="text-align: left">步骤4：完善和协作</h3>
         <p class="no-indent">这一步骤主要适用于基于聊天的生成式AI，但如果可以使用，它也是一项强大的功能。在AI作出初步响应后，如果您感到满意，可以通过提供额外指导来微调内容。这可能涉及调整回复的形式和复杂程度、创建变体或请求解释和来源。这就像编辑文档一样：你可以指导AI，就像指导一个助手一样。</p>
         <div class="textbox textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>示例</strong></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li style="font-weight: 400">介绍两个过去时形式更复杂的动词（如“go”变成“went”）。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">增加一个关于不规则形式动词的问题（如“swim”变成“swam”而不是“swimmed”）。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">使用更长的句子。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">将所有这些动词融入一个短故事。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">以7岁儿童能理解的方式写出使用不规则过去时动词的规则。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">想出一个基于记忆技巧的押韵诗来帮助记住一些比较难的动词。</li>
                   </ul>
                   <ul>
                        <li style="font-weight: 400">设计这个练习的变式。</li>
                   </ul>
              </div>
         </div>
         <h3 style="text-align: left">步骤5：调整内容并实施</h3>
         <div class="container___hZllz">
              <div class="main___dsnkV">
                   <div class="content___hMdwe">
                        <div class="markdown___Ho3m0">
                             <p>到目前为止，你应该已经拥有了一份令人满意的内容。然而，过程并没有就此结束。无论是文本、图像、视频、网站还是代码，这些内容都只是一种媒介，你需要在教学过程中实际应用它们。这类内容很少能够直接使用，所以可能值得你自己进行修改，改进它，并将其适应到你的特定情境中。这种实施直接与第一步中概述的目标相关，即你的方法的“为什么”和“怎么做”。作为一名教育工作者，这就是你可以增加价值的地方，确保内容是鼓舞人心的、有创造性的或创新的。然后，你可以探索、结构化，并适当地安排你的内容。</p>
                        </div>
                   </div>
              </div>
         </div>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-the-degenerative" title="局限性，第1部分">
         <header>
              <h1 class="chapter-title">局限性，第1部分</h1>
              <p data-type="subtitle" class="chapter-number">40</p>
         </header>
         <p class="no-indent">作为一种深度学习工具，生成式AI继承了机器学习模型的所有伦理和社会性后果。</p>
         <p class="no-indent"><a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual/" target="_blank" rel="noopener"><strong>隐私威胁</strong></a>：与许多其他AI技术的提供商一样，生成式AI的提供商收集各种用户数据，然后与第三方共享。OpenAI的隐私政策承认，如果用户提出请求，它会删除用户数据，但不会删除用户提示，因为这些提示本身可能包含可以追溯到用户的敏感信息<sup>1</sup>。</p>
         <p class="indent">还有一个风险是，人们可能在一次看似人类的对话中会透露更多敏感信息，而这在其他情况下是不会发生的<sup>2</sup>。当学生直接使用生成式AI系统时，这一点尤其重要。由于这项技术在模仿人类语言（尤其是儿童掌握的语言）方面非常成功，这项技术“可能对学习者产生未知的心理影响，引发对他们的认知发展、情感健康以及被操纵的潜在可能性的担忧”<sup>3</sup>。</p>
         <p class="no-indent"><strong>透明度和可解释性：</strong>即使是所谓的开放的生成式AI模型的提供者，有时也对投入到训练和调整模型的所有材料和方法讳莫如深。此外，作为具有数百万参数的深度模型，无法解释这些参数的权重分配，以及它们是如何共同实现特定输出<sup>3</sup>。</p>
         <p class="indent">即使在提示和用户历史几乎没有差异的情况下，输出的形式和内容也可能有很大的差异<sup>2</sup>。如果为两个学生提供相同的练习，他们不仅可能得出截然不同的回答，而且无法解释这些差异。模型和版本是否为付费版本也会影响输出。这不仅影响学生的学习效果，也会影响评分过程的公平性。但是，禁止使用这些软件也存在问题，因为这将扩大能够在家中使用它的学习者与不能使用的学习者之间的差距<sup>1</sup>。</p>
         <p class="no-indent"><a href="https://pressbooks.pub/aiforteachers/chapter/homogenisation-invisibility-and-beyond-towards-an-ethical-ai/" target="_blank" rel="noopener"><strong>同质性</strong></a>：虽然输出不稳定和缺乏解释是令人担忧的问题，但同样令人担忧的还有标准化和同质化的问题。作为从互联网数据中训练的模型，生成式AI系统会将某些观点和文化价值观置于其他观点的价值观之上，从而限制了学习者接触多样化视角的机会和他们的批判性思维能力<sup>3</sup>。“每个数据集，即使是那些包含数十亿图像（即从互联网上抓取的文本对）的数据集，都包含了某种世界观，并将世界划分为可能存在严重问题的类别”<sup>4</sup>。例如，以维基百科（Wikipedia）作为训练数据集的常用资源，其内容创作者主要是男性<sup>5</sup>。</p>
         <p class="indent">由于基础模型被设计为旨在适应下游的各种任务<sup>6</sup>，这种同质化趋势比其他机器学习模型更强。然而，如何调整这些模型似乎对同质化是加强、削弱还是保持不变有很大影响<sup>7</sup>。</p>
         <p class="indent">ChatGPT是“多语言但单文化的”，因为它是“基于英语文本进行训练的，其中蕴含着文化偏见和价值观，并与一小群美国承包商的价值观保持一致”。如果老师使用生成式AI来评估学生的写作，那么评估的主要内容不就是学生在多大程度上能够符合这种世界观，这种思维方式、认知和语言使用方式<sup>1</sup>？</p>
         <p class="no-indent"><strong><a href="https://pressbooks.pub/aiforteachers/chapter/issues-with-data-bias-and-fairness/" target="_blank" rel="noopener">偏见、刻板印象和包容性</a>:</strong> 生成式AI系统中可能存在很多偏见和刻板印象。例如，当ChatGPT被提示“助理律师因为怀孕而嫁给了律师”，并被问及代词“她”指的是谁时。ChatGPT回答“她”指的是助理律师，并极力解释为什么不可能是律师。</p>
         <figure id="attachment_937" aria-describedby="caption-attachment-937" style="width: 714px" class="wp-caption aligncenter">
              <img class="wp-image-937" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650.jpg" alt="" width="714" height="581" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650.jpg 1090w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-300x244.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-1024x832.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-768x624.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-65x53.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-225x183.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240616142650-350x284.jpg 350w" sizes="(max-width: 714px) 100vw, 714px" />
              <figcaption id="caption-attachment-937" class="wp-caption-text">来源：<a href="https://twitter.com/Eodyne1/status/1650632232212520960/photo/1">https://twitter.com/Eodyne1/status/1650632232212520960/photo/1</a></figcaption>
         </figure>
         <p class="no-indent">即使ChatGPT拒绝编写赤裸裸的性别歧视或种族歧视内容，它也被证明更愿意编写包含此类内容的Python代码<sup>1</sup>。Codex生成的代码似乎也反映了不同种类刻板印象<sup>8</sup>。BERT被证明会将涉及残疾人的短语与负面词汇联系在一起，涉及精神疾病的短语与枪支暴力、无家可归和毒品成瘾联系在一起<sup>5</sup>。</p>
         <p class="indent">文本到图像模型也被证明能生成有偏见的内容，包括那些与训练数据相关的“错误表述（例如对少数群体的有害刻板印象）、代表性不足（例如在某些职业中消除一种性别的出现）和代表性过度（例如默认采用盎格鲁中心的视角）”<sup>6,4</sup>。</p>
         <p class="indent">还有一些更微妙的消极形式，例如对群体的非人性化以及某些群体的表述方式。传播这些问题的大语言模型不仅影响相关用户，而且当这些材料在留言板和评论中自动传播时，它们也会成为反映“新现实”的新一代 LLM 训练数据<sup>5</sup>。不幸的是，教师有责任筛选生成的输出结果，并在孩子接触到这些输出结果时立即进行干预，无论他们是直接受到这些输出结果的贬低，还是可能学习并传播这种偏见。</p>
         <p class="no-indent"><strong>内容审核</strong>：与搜索引擎和推荐系统类似，生成式AI所做的也是策划用户看到的内容。生成式AI能生成的内容必然是基于它能够接触到的内容：即它能实际获取并被其创造者认为适合消费的内容。因此，他们的观点为生成式AI用户定义了“现实”，并影响他们的<a href="https://pressbooks.pub/aiforteachers/chapter/ai-aied-and-human-agency/" target="_blank" rel="noopener">自主能动性</a>。因此，教师和学习者应始终以批判的眼光看待构成生成文本和图像结构的价值观、习俗和文化<sup>3</sup>。</p>
         <p class="indent">必须牢记，生成式AI不是，并且“永远不能成为所涉及任何主题的权威知识来源”<sup>3</sup>。</p>
         <p class="indent">为了消除其<a href="https://pressbooks.pub/aiforteachers/chapter/behind-the-search-lens-effects-of-search-on-the-individual-on-the-society/" target="_blank" rel="noopener">过滤效应</a>，应该为学习者提供充分的机会，让他们与同伴交流，与来自不同职业和生活方式的人交谈，探究意识形态，提出问题，验证真相，进行实验，并从成功、错误和一切其他之间学习。如果一项活动是让他们按照生成式AI建议的项目、代码或实验的想法去做，那么另一项活动应该让他们尝试自己的想法和问题，并参考多样化的学习资源。</p>
         <p class="no-indent"><strong>环境和可持续性</strong>：所有机器学习模型都需要大量的处理能力和数据中心；这些都会带来相关的环境成本，包括冷却服务器所需的水量<sup>9</sup>。在过去六年中，深度学习大模型所需的计算能力增加了30万倍<sup>5</sup>。训练大语言模型会消耗大量能源，模型必须托管在某处并可远程访问<sup>8</sup>。微调模型也需要大量能源，关于这一过程的环境成本没有太多数据。</p>
         <p class="indent">然而，虽然这些模型的性能得到了报告，但其环境成本很少被讨论。即使在成本效益的分析中，也没有考虑到虽然一个社区可能从好处中获利，而付出了代价的确实另一个完全不同的社区<sup>5</sup>。抛开这一点的不公正不谈，从长远来看，这对于生成式AI项目的可行性并不是个好消息。</p>
         <p class="indent">在这些模型被广泛应用于教育领域之前，在现有的基础设施和学习方式被忽视、转而支持由生成式AI驱动的方式之前，必须对这种飞跃的可持续性和长期可行性进行讨论。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Trust, T., Whalen, J., &amp; Mouza, C., <em><a href="https://citejournal.org/volume-23/issue-1-23/editorial/editorial-chatgpt-challenges-opportunities-and-implications-for-teacher-education" target="_blank" rel="noopener">Editorial: ChatGPT: Challenges, opportunities, and implications for teacher education</a></em>, Contemporary Issues in Technology and Teacher Education, 23(1), 2023.</p>
         <p class="hanging-indent"><span style="margin: 0px;padding: 0px">2 Tlili, A., Shehata, B., Adarkwah, M.A., et al., <em>What if the devil is my guardian angel: ChatGPT as a case study of using chatbots in education</em>, Smart Learning Environments, 10, 15 2023.</span></p>
         <p class="hanging-indent"><sup>3 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, UNESCO, Paris, 2023.</p>
         <p class="hanging-indent"><sup>4 </sup>Vartiainen, H., Tedre, M., <em>Using artificial intelligence in craft education: crafting with text-to-image generative models</em>, Digital Creativity, 34:1, 1-21, 2023.</p>
         <p class="hanging-indent"><sup>5 </sup>Bender, E.M., et al, <em>On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?</em>, Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’21). Association for Computing Machinery, New York, 610–623, 2021.</p>
         <p class="hanging-indent"><sup>6 </sup>Bommasani , R., et al., <em>On the Opportunities and Risks of Foundation Models</em>, Center for Research on Foundation Models (CRFM) — Stanford University, 2021.</p>
         <p class="hanging-indent"><sup>7 </sup>Bommasani, R., et al, <em>Picking on the Same Person: Does Algorithmic Monoculture lead to Outcome Homogenization?</em>, Advances in Neural Information Processing Systems, 2022.</p>
         <p class="hanging-indent"><sup>8 </sup>Becker, B., et al, <em>Programming Is Hard – Or at Least It Used to Be: Educational Opportunities and Challenges of AI Code Generation</em>, Proceedings of the 54th ACM Technical Symposium on Computer Science Education V. 1 (SIGCSE 2023), Association for Computing Machinery, New York, 500–506, 2023.</p>
         <p class="hanging-indent"><sup>9 </sup>Cooper, G., <em>Examining Science Education in ChatGPT: An Exploratory Study of Generative Artificial Intelligence</em>, Journal of Science Education and Technology, 32, 444–452, 2023.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-the-degenerative-part-2" title="局限性，第2部分">
         <header>
              <h1 class="chapter-title">局限性，第2部分</h1>
              <p data-type="subtitle" class="chapter-number">41</p>
         </header>
         <p class="no-indent">生成式AI特有的危险包括：</p>
         <p class="no-indent"><strong>不准确性和幻觉</strong>：生成模型在输出连贯、流畅、类似人类的语言方面堪称奇迹。但这些缺乏深思熟虑的话语中，隐藏着事实错误、有限的真相、捏造的参考资料和纯粹的虚构——我们称之为“幻觉”<sup>1,2</sup>。在ChatGPT界面的底部，所有会话的下方都标有这样一则提示：ChatGPT可能会产生关于人物、地点或事实的不准确信息。ChatGPT的准确性约为60%或更低，具体取决于主题<sup>2,3</sup>。</p>
         <p class="indent">更糟糕的是，ChatGPT往往会在没有证据或限定的情况下呈现真相。当被特别要求提供参考文献时，它可以凭空捏造出根本不存在的来源，或者不支持文本中呈现的真相<sup>4,2</sup>。然而，许多用户倾向于像使用“互联网搜索引擎、参考图书管理员，甚至是维基百科”<sup>5</sup>那样使用它。当老师或学生使用它来获取他们之前没有了解的信息时，他们可能学到错误的东西或向他人展示错误的知识<sup>1,5</sup>。</p>
         <p class="indent">当今LLMs的成功在于它们使用的参数数量和训练数据量之多，它们用这些来模拟人类交流中词语的组合方式。老师和学生应始终牢记，对话模型生成的文本与这些模型对该文本的理解无关，甚至与现实的概念无关<sup>1</sup>。虽然它们可以在不同程度上成功地操纵语言形式，但它们无法获得这种形式背后的含义<sup>6</sup>。“人类式的思考基于可能的解释和纠错，这一过程逐渐限制了可以合理考虑的可能性……人类在理性推测解释的种类方面受到限制，而机器学习系统既可以学习地球是平的，也可以学习地球是圆的”<sup>7</sup>。</p>
         <p class="no-indent"><strong>权力和控制的转移或恶化</strong>：生成式AI依赖于大量的数据、计算能力和先进的计算方法。只有少数公司、国家和语言可以获得所有这些。然而，随着越来越多的人采用这些技术，大部分人类被迫遵循它们的路线，因此被异化并被迫失去表达能力<sup>1</sup>。</p>
         <p class="indent">创造者保留了权力，却将责任外包。例如，净化ChatGPT输出的责任落在了肯尼亚工人身上，“他们必须筛选出暴力和令人不安的内容，如性虐待、仇恨言论和暴力”<sup>4</sup>。</p>
         <p class="no-indent"><strong>版权和知识产权侵犯</strong>：生成系统的大部分技术知识都被企业屏障所保护。然而，这些数据却是取自公众。在未经被拍摄者知情或同意的情况下，可以使用某个平台上公开的图片吗？例如，如果某人的脸被用于种族主义宣传怎么办<sup>8</sup>？阻止生成式AI的唯一方法是将内容私有化吗？</p>
         <p class="indent">除了公共数据之外，语言模型还可以取用付费屏障后的内容并为用户进行总结。众所周知，图像模型能够将清晰显示水印的图片拼凑在一起。还有知识共享许可协议的问题，即作者向公众公开其作品，但每次使用时必须标明出处，而模型可能会也可能不会这样做。</p>
         <p class="indent">对于教师来说，这引发了道德、伦理和法律问题。如果他们使用模型生成的内容，他们是否可以自由使用并发布它？如果它受版权保护或根据知识共享许可协议授权，谁将承担责任<sup>9</sup>？用户如何知道他们正在使用他人的财产<sup>1</sup>？遗憾的是，关于这个话题还没有明确的指导方针。在指令出台之前，我们只能静观其变，小心行事。</p>
         <p class="no-indent"><strong>在教育中使用生成式AI的长期影响</strong>：尽管生成式AI在教育中的应用方式多种多样，但其长期影响尚不明确：</p>
         <ul>
              <li>既然写作也构建了思考，那么按照生成式AI的大纲进行写作会对学生产生什么影响<sup>1</sup>？</li>
              <li>它会影响思考范围、批判性思维、创造力和解决问题的技能吗<sup>1</sup>？</li>
              <li>它会使学生因为可以轻松获得信息和解决方案而过度依赖它吗<sup>1,10,9</sup>？</li>
              <li>学生是否仍然有动力去探索世界并得出自己的结论<sup>10</sup>？</li>
              <li>它会让我们陷入与我们周围的现实脱节的世界观中吗？</li>
              <li>我们在精通提示技巧的路上每迈进一步，将会失去多少技能？</li>
         </ul>
         <p class="no-indent">专注于高阶技能并将繁琐工作交给AI，这听起来似乎是个好主意，但重复练习某些基础的低阶技能仍是不可或缺的，因为这种坚持甚至挫折感通常是获得高阶技能所必需的<sup>1,8</sup>。这也是学习者在进行基本计算时减少对技术的依赖所必需的，因为这有损于<a href="https://pressbooks.pub/aiforteachers/chapter/ai-aied-and-human-agency/" target="_blank" rel="noopener">人类能动性</a>和他们独自面对世界的信心。</p>
         <p class="indent">一些防范潜在长期危害的对策可能是：</p>
         <ul>
              <li>将语言模型仅作为一个起点，用来生成各种可能性并探索不同的视角，而非作为满足所有需求的一站式解决方案<sup>10</sup>；</li>
              <li>通过直接实验或其他来源验证模型的输出；</li>
              <li>始终让教师参与其中<sup>10</sup>；</li>
              <li>促进社会性学习，并增加接触人类创造性成果的机会<sup>1</sup>；</li>
              <li>积极寻找其他教育资源和屏幕外活动<sup>10</sup>；</li>
              <li>尝试寻找其他解释和思考模式及方法。</li>
         </ul>
         <p class="no-indent">我们应该始终警惕将人类和机器之间划上错误等号的倾向，甚至承认生成式AI的优越性。例如，人们常说人类无法像AI那样处理大量数据。考虑到人类在模式识别、外推和创造力方面的技能，我们是否有必要处理千兆字节的数据？因为AI可以在一瞬间分析100本书的内容，是否就意味着学生不会享受或受益于其中一本书？做事更快是否一定是一件好事，一定是我们想要采纳的衡量标准吗<sup>8</sup>？</p>
         <p class="indent">我们必须牢记，孩子们不是为了当今的世界和技术而受教育。他们是为了10-15年后的世界做准备的，或者说是为他们自己准备技能的<sup>8</sup>。ChatGPT在短短一年内带来了如此大的革命性变化，这更说明了教育应该超越ChatGPT，而不是为了ChatGPT而教育。学生需要具备独立思考的能力、适应变化的韧性以及面对生活新挑战的成长能力。</p>
         <p class="indent">教育的终极目标不能是培养出能够高效的智能机器操作员或生产线上的工人，而是帮助形成具有自由思考、创造性、韧性强的和全面发展的公民。在决定如何最好地采用一项技术以实现这一目标之前，有一些关键问题需要深思熟虑，有一些长期影响需要甄别。无论AI是否具有生成性，都不能将这项重要任务交给AI。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, UNESCO, Paris, 2023.</p>
         <p class="hanging-indent"><sup>2 </sup>Tlili, A., Shehata, B., Adarkwah, M.A. et al, <em>What if the devil is my guardian angel: ChatGPT as a case study of using chatbots in education</em>, Smart Learning Environments, 10, 15 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>3 </sup>Lewkowycz, A., Andreassen, A., Dohan, D. et al, <em>Solving Quantitative Reasoning Problems with Language Models</em>, Google Research, 2022.</p>
         <p class="hanging-indent" style="text-align: left"><sup>4 </sup>Cooper, G., <em>Examining Science Education in ChatGPT: An Exploratory Study of Generative Artificial Intelligence</em>, Journal of Science Education and Technology, 32, 444–452, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>5 </sup>Trust, T., Whalen, J., &amp; Mouza, C., <em><a href="https://citejournal.org/volume-23/issue-1-23/editorial/editorial-chatgpt-challenges-opportunities-and-implications-for-teacher-education" target="_blank" rel="noopener">Editorial: ChatGPT: Challenges, opportunities, and implications for teacher education</a>,</em> Contemporary Issues in Technology and Teacher Education, 23(1), 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>6 </sup>Bender, E.M., et al, <em>On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?</em>, Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’21). Association for Computing Machinery, New York, 610–623, 2021.</p>
         <p class="hanging-indent" style="text-align: left"><sup>7 </sup>Chomsky, N., Roberts, I., Watumull, J., <em>Noam Chomsky: The False Promise of ChatGPT</em>, The New York Times, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>8 </sup>Vartiainen, H., Tedre, M., <em>Using artificial intelligence in craft education: crafting with text-to-image generative models</em>, Digital Creativity, 34:1, 1-21, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>9 </sup>Becker, B., et al, <em>Programming Is Hard – Or at Least It Used to Be: Educational Opportunities and Challenges of AI Code Generation</em>, Proceedings of the 54th ACM Technical Symposium on Computer Science Education V. 1 (SIGCSE 2023), Association for Computing Machinery, New York, 500–506, 2023.</p>
         <p class="hanging-indent" style="text-align: left"><sup>10 </sup>Enkelejda, K., et al, <em>ChatGPT for Good? on Opportunities and Challenges of Large Language Models for Education</em>, EdArXiv, 2023.</p>
    </section>
</div>
<div data-type="part" class="part" id="part-the-next-steps">
    <header>
         <h1 class="part-title">下一步</h1>
         <p data-type="subtitle" class="part-number">VII</p>
    </header>
    <p class="no-indent">        在前几章中，我们探讨了AI在学术领域的声称已经产生的影响。鉴于人工智能产业的市值已高达数十亿欧元，我们有理由期待，现有的产品和服务会持续改进，并且会涌现出新的产品、服务和市场机遇。然而，在这种情况下，我们唯一能确定的是将会有许多无法预料的变化，至于这些变化具体是什么，目前还无法预知。</p>
    <p class="indent">同样，我们也无法精确预知AI在教育领域扮演的日益重要角色将会带来怎样的影响。但可以肯定的是，影响必然发生。</p>
    <p class="indent">本部分将探讨教育可能面临的一些变革。我们的讨论将比之前的章节更具前瞻性，走上一条不寻常的道路。因此，这里的内容应被视为开放的讨论和对未来的一种解读。</p>
    <section data-type="chapter" class="chapter" id="chapter-open-or-closed" title="开放还是封闭？">
         <header>
              <h1 class="chapter-title">开放还是封闭？</h1>
              <p data-type="subtitle" class="chapter-number">42</p>
         </header>
         <h3 style="text-align: left">开放教育资源（OER）及其历史</h3>
         <p><a href="https://www.bilibili.com/video/BV1Kx4y1H7sZ/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 人工智能和开放教育 (AI and Open Education)</a></p>
         <p class="no-indent">        教育资源涵盖了所有可用于教育的材料，这些材料越来越倾向于数字化形式，例如：教科书、课件、课程大纲和考试试卷。当这些资源可以自由地与他人分享时，我们就称之为“开放的”教育资源（稍后将给出更明确的定义）。</p>
         <p class="indent">尽管教育在多个方面早已实现开放，但相关的术语定义过去可能并不那么明确。根据2019年11月25日的建议，我们对开放教育资源（OER）和开放许可证的定义进行了修订<sup>3</sup>：</p>
         <ol>
              <li>开放教育资源（OER）：包括各种格式和媒介的学习、教学和研究材料。这些材料要么是公共领域的，要么是受版权保护但已经通过开放许可证授权，允许公众免费访问、再次使用、重新调整用途、改编以及重新分发教育资源。</li>
              <li>开放许可证：是一种尊重版权所有者权益的许可协议，它允许公众免费访问、再次使用、重新调整用途、改编以及重新分发教育资源。</li>
         </ol>
         <figure id="attachment_156" aria-describedby="caption-attachment-156" style="width: 300px" class="wp-caption alignright">
              <img class="size-medium wp-image-156" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER-300x200.png" alt="" width="300" height="200" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER-300x200.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER-65x43.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER-225x150.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER-350x234.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-1-OER.png 560w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption id="caption-attachment-156" class="wp-caption-text">“开放教育资源标志” 由IDA Projekt授权，遵循CC BY-SA 4.0许可证。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-sa/4.0/?ref=openverse">https://creativecommons.org/licenses/by-sa/4.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">      “开放内容”和“OER”指那些可以授予特定使用权利的受版权保护的作品（不包括软件，软件通常有其他专门的描述方式，比如“开源”），这些作品允许用户行使以下五项权利（也称作“五个R”）<sup>1,2</sup>：</p>
         <ul>
              <li>保留权（Retain） – 用户可以制作、拥有和控制内容副本（例如，下载、复制、存储和管理）；</li>
              <li>重用权 （Reuse）– 用户能以多种方式使用这些内容（例如，在课堂上、学习小组中、网站上、视频中）；</li>
              <li>修改权（Revise） –用户可以对内容进行修改、调整或改动（例如，将内容翻译成另一种语言）；</li>
              <li>混合权（Remix） – 用户可以将原始内容或经过修改的内容与其他素材结合，创造出新的作品（例如，嵌入内容）；</li>
              <li>重新分发权（Redistribute） – 用户可以将原始内容、修订内容或其它们的组合副本分发给其他人。</li>
         </ul>
         <p class="no-indent">这些权利并非微不足道。例如，第三个权利（修改权）对教师至关重要。这意味着教师可以利用他人的教学材料，并根据自己的教学目的、课堂时长和水平，以及特定的地域和文化背景进行调整。</p>
         <h3 style="text-align: left">为什么AI需要开放数据</h3>
         <p class="no-indent">        正如本书不同部分所展示的，以及业界的财务投资所证明的，教育可以被视为一个市场。由于机器学习作为推动人工智能发展的核心动力，可以合理推断，为了让AI在教育领域大放异彩，它迫切需要数据作为支撑。</p>
         <h3 style="text-align: left">用户数据与知识数据的区别</h3>
         <p class="no-indent">        在AI教育的数据需求中，有两种类型的数据尤为关键。</p>
         <p class="indent">一种是用户数据，比如，他们如何学习？哪些因素促进了高效学习？什么因素让他们学得更好？正如Daphne Koller所说：“我们应该将教育科学转化为数据科学！”这些宝贵的数据只能由用户自身产生。因此，对于企业来说，拥有一个能让用户与之互动的平台至关重要。这不仅是许多AI公司成功的秘诀，也将是教育领域实现突破的关键。</p>
         <p><a href="https://www.bilibili.com/video/BV1tb421e71i/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] Daphne Koller: 我们从在线教育中学到了什么？(What we&#8217;re learning from online education)</a></p>
         <p class="no-indent">        第二种是知识数据。在教育领域，课件构成了知识的重要组成部分。然而，关于这类数据的共享情况千差万别。大多数情况下，知识的创造者或收集者对于许可证的概念并不清晰，因此他们所创作的材料常常被埋没在大学的资料库、冷门的博客或是社交网络的特定群体中。当然，也有一些知识被设置为付费内容，需要支付费用才能获取；而另一些则出现在一些提供免费知识的网站上，但用户必须忍受广告和其他不必要的宣传，才能获取或维持对这些知识的访问。</p>
         <h3 style="text-align: left">用户数据必须受到保护</h3>
         <p class="no-indent">        在第一种情况下，用户数据必须受到保护。如果这些数据属于未成年学生，更是如此。这意味着学校或教师在没有得到明确允许的情况下，不得将学生的数据分享给任何平台，哪怕这个平台提供了令人心动的服务。同样，以参加某项活动为由去登记学生的姓名和地址，这样的做法也是极不可取的。</p>
         <p class="indent">欧洲联盟为了保护公民的隐私和数字权利，制定了一套严格的法规，即GDPR（通用数据保护条例）。这一条例赋予了公民必须由平台授予的权利，无论它们是用于教育还是其他目的。</p>
         <h3 style="text-align: left">知识数据应该被共享</h3>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>了解一下！</strong></p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/gdpr-in-a-nutshell/" target="_blank" rel="noopener">让我们了解一下GDPR的核心要点</a>
              </div>
         </div>
         <p class="indent">在拥有相应权利的前提下，知识可以并应当被共享。</p>
         <p class="indent">这意味着我们需要深入了解许可制度是如何运作的。对于OER来说，创作共享许可证往往是最为合适的选择。一旦OER被共享，人工智能可以被许多实体和项目使用，例如项目<a href="https://pressbooks.pub/aiforteachers/chapter/x5gon/" target="_blank" rel="noopener">X5-GON</a>（自由可获取的技术元素的集合）。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Wiley, D., &amp; Hilton, J. (2018). <a href="https://doi.org/10.19173/irrodl.v19i4.3601" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.19173/irrodl.v19i4.3601">Defining OER-enabled pedagogy</a>. International Review of Research in Open and Distance Learning, 19(4).</p>
         <p class="hanging-indent"><sup>2 </sup>Wiley, D (2014).<a href="https://opencontent.org/blog/archives/3221" target="_blank" rel="noopener" data-cke-saved-href="https://opencontent.org/blog/archives/3221">The Access Compromise and the 5th R</a>.</p>
         <p class="hanging-indent"><sup>3 </sup>UNESCO. (2019). <a href="https://en.unesco.org/themes/building-knowledge-societies/oer/recommendation" target="_blank" rel="noopener" data-cke-saved-href="https://en.unesco.org/themes/building-knowledge-societies/oer/recommendation">Recommendation on open educational resources (OER)</a>.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-artificial-intelligence-homework-exams-and-so-forth" title="人工智能、作业与考试等">
         <header>
              <h1 class="chapter-title">人工智能、作业与考试等</h1>
              <p data-type="subtitle" class="chapter-number">43</p>
         </header>
         <p class="no-indent">        支持人工智能在教育领域大放异彩的一个热门观点是，AI能够帮我们管理考试。</p>
         <figure id="attachment_159" aria-describedby="caption-attachment-159" style="width: 336px" class="wp-caption aligncenter">
              <img class="wp-image-158" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test-300x100.png" alt="" width="336" height="112" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test-300x100.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test-65x22.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test-225x75.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test-350x117.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-exam-test.png 750w" sizes="(max-width: 336px) 100vw, 336px" />
              <figcaption id="caption-attachment-159" class="wp-caption-text">由Sean MacEntee创作的“考试测试”在CC BY 2.0下授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/2.0/?ref=openverse">https://creativecommons.org/licenses/by/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">       截至2022年12月，人工智能帮助教师管理考试的一些方法包括：</p>
         <ol>
              <li>自动化文本评估</li>
              <li>监控考试中的学生活动：这称为<strong>监考</strong>。网络摄像头和其他传感器被用来监控考试过程。COVID-19疫情期间，提供这类服务的公司迅速增多。然而，电子监考的使用引发了争议，有研究指出这种技术可能侵犯隐私、导致种族歧视，并且效果不佳<sup>1,2</sup>。</li>
              <li>检测抄袭。在线工具可以将学生的作文与大量文本数据库进行对比，检测抄袭。即使大部分工作不是AI完成的，但也有工具专门用于检测近似抄袭的情况，即论文被部分的重写。<a href="https://www.turnitin.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.turnitin.com/">Turnitin</a>就是这样一个常用工具，多大学都在使用它或类似工具。有时候，大学还会制定使用这些工具的策略，明确学生在此事项上的权利。</li>
              <li>自动设置个性化问题。这项技术已经应用多年，可以在流行的学习管理系统中找到，例如Moodle<sup>3</sup>。</li>
         </ol>
         <p class="no-indent">     作业至少遵循三个逻辑原则<sup>4</sup>：</p>
         <ol>
              <li>在某些情况下，它是一种<a href="https://en.wikipedia.org/wiki/Summative_assessment" target="_blank" rel="noopener" data-cke-saved-href="https://en.wikipedia.org/wiki/Summative_assessment">总结性评估</a>：成绩取决于多种结果的综合；一些教师认为，要求学生在家以自己的节奏学习可能会减少压力。通常情况下，如果评价活动不在课堂时间内进行，老师们往往没有足够的时间去完成整个教学大纲。</li>
              <li>在其他情况下，作业是为了加深在课堂上构建的知识基础。</li>
              <li>在第三种情况下，家庭作业是为了应对下周即将到来的考试，学生需要做好准备。有时候老师会提供一些练习和活动；而有时候，则需要学生付出记忆上的努力。</li>
         </ol>
         <p class="no-indent">        对于家庭作业，不同文化有着不同的看法。因为这些观点千差万别，我们在此不做评论。</p>
         <figure aria-describedby="caption-attachment-159" style="width: 300px" class="wp-caption aligncenter">
              <img class="size-medium wp-image-159" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework-300x225.jpg" alt="" width="300" height="225" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework-300x225.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework-65x49.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework-225x169.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework-350x263.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page-2-homework.jpg 500w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption class="wp-caption-text">由peapodsquadmom创作的“作业 作业 作业”在CC BY 2.0下授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by/2.0/?ref=openverse">https://creativecommons.org/licenses/by/2.0/?ref=openverse</a>。</figcaption>
         </figure>
         <p class="no-indent">        如果学生不清楚家庭作业的真正目的，他们会尽可能地不完成作业。</p>
         <p class="indent">AI能够揭露在家庭作业中作弊的学生：</p>
         <ul>
              <li style="text-align: justify">在数学中，像<a href="https://photomath.com" target="_blank" rel="noopener" data-cke-saved-href="https://photomath.com">Photomath </a>这样的应用可以让学生拍下等式的照片，然后直接提供解答。</li>
              <li style="text-align: justify">同样在数学中，现在我们有了 ChatGPT 和其他生成式 AI 工具，它们能够解决一些简单的数学题目。</li>
              <li style="text-align: justify">在语言学习中，自动翻译工具，如<a href="https://www.deepl.com/translator" target="_blank" rel="noopener" data-cke-saved-href="https://www.deepl.com/translator">Deepl</a>和<a href="https://translate.google.com/" target="_blank" rel="noopener" data-cke-saved-href="https://translate.google.com/">Google Translate</a>，经常在学生做作业时被使用；</li>
              <li>在文学和社会科学中，新工具正在出现。通过 AI 工具生成的论文有可能欺骗老师。</li>
         </ul>
         <p>我们的目的不是覆盖所有内容。关于这些议题的新文章每天都在不断产生。并没有现成的解决方案。我们希望能够提升公众意识，并激励实践社区开始思考这个问题。在讨论可能的解决办法之前，我们先来看看在国际象棋领域作弊是如何成为一个问题的。</p>
         <h3 style="text-align: left">国际象棋</h3>
         <p class="no-indent">       棋类游戏不仅是一种智力游戏，它也与教育和人工智能有着紧密的联系<sup>5</sup>。一些学校将棋类游戏引入教学中。下棋和玩其他游戏需要运用推理能力，适合所有年龄段。也有倡议使用桥牌游戏进行教育<sup>6</sup>。</p>
         <p class="indent">国际象棋为人工智能提供了两个主要的里程碑。1997年，Gary Kasparov被Deep Blue7<sup>7</sup>击败。2016年，<a href="https://wikipedia.org/wiki/AlphaZero" data-cke-saved-href="https://wikipedia.org/wiki/AlphaZero">Alphazero</a>以相当大的优势击败了所有先进的AI系统。在第一种情况下，AI不包含任何机器学习成分，完全基于人类设计的规则。而在第二种情况中，神经网络和强化学习变得至关重要。1997年，AI是基于成千上万场人类棋局设计的；但到了2016年，所有这些人类的知识都被抛弃，仅保留了棋盘游戏本身的规则。</p>
         <p class="indent">2022年，国际象棋因众多有关作弊的争议而显得更加引人关注。在Covid-19大流行期间，大多数国际象棋比赛都在线上进行，很明显存在作弊行为。在网络棋盘上作弊实在太过简单了。仅仅使用智能手机，就能知道AI所推荐的最佳走法。这引发了一个问题——我们如何判定一个棋手是否作弊？专家们设计了一种比对方法，通过将棋手的走法与AI程序中的建议进行比较。因为AI系统的棋力远胜人类，因此人们得出结论：如果某位棋手的走法与AI推荐的一致，那么他可能就是作弊了。公平地说，这种推理比我们自身对一个成绩平平的学生突然在考试中取得优异成绩时的反应要复杂。但这种情况不禁让我们联想到这个例子。</p>
         <h3 style="text-align: left">作弊</h3>
         <p class="no-indent">        在国际象棋上成立的事实，似乎也适用于课堂。有两个原因可以解释为什么玩家（或是学生）会选择使用AI软件而非自己去完成任务：</p>
         <ol>
              <li>AI软件简单易用</li>
              <li>AI软件被认为优于人类的智力</li>
         </ol>
         <p class="no-indent">        国际象棋棋手很清楚，AI提供的走法超越了他们的水平。但这样的诱惑很难抵挡。正如一些老师所言：“即使是表现较好的学生也会使用自动翻译工具。他们不借助工具完成作业后，反而会检查并发现AI给出的答案更为精确。”</p>
         <p class="indent">但一个问题仍然存在——<strong>这算作弊吗？</strong>如果按照游戏规则来说，是的。但如果任务只是简单地把一边的砖头搬到另一边而已。规则里禁止使用手推车，但手推车就放在那里而且你觉得没人注意到。虽然规则里说不许用，但利用它不就能更高效完成任务吗？</p>
         <h3 style="text-align: left">教师参与</h3>
         <p class="no-indent">        从上面的分析我们可以看出，作弊的机会正在变得无所不在。至少目前来看，想说服学生不去使用这些越来越便捷的工具，似乎不太可能。核心问题是，我们能否找到方法来区分课堂活动和家庭作业？我们是否能够接受家庭作业在AI的帮助下完成呢？</p>
         <p class="indent"><a href="https://substack.com/profile/19265909-arvind-narayanan" target="_blank" rel="noopener" data-cke-saved-href="https://substack.com/profile/19265909-arvind-narayanan">在这篇文章中</a>，Arvind Narayanan用丰富的常识对这个现象进行了分析，并提出了一些建议，帮助教师设计出有趣的家庭作业，减少甚至消除作弊现象。</p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Brown 2020; Brown L. X. Z. (2020), <em>How automated test proctoring software discriminates against disabled students</em>, Center for Democracy &amp; Technology, available at <a href="https://cdt.org/insights/how-automated-test-proctoring-software-discriminates-against-disabled-students/" target="_blank" rel="noopener" data-cke-saved-href="https://cdt.org/insights/how-automated-test-proctoring-software-discriminates-against-disabled-students/">https://cdt.org/insights/how-automated-test-proctoring-software-discriminates-against-disabled-students/</a>.</p>
         <p class="hanging-indent"><sup>2</sup> Conijn R. et al. (2022),<em> The fear of big brother: the potential negative side-effects of proctored exams</em>, Journal of Computer Assisted Learning, pp. 1-14, available at <a href="https://doi.org/10.1111/jcal.12651" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1111/jcal.12651">https://doi.org/10.1111/jcal.12651</a>.</p>
         <p class="hanging-indent"><sup>3</sup> Moodle is an open and collaborative project. Many extensions and plug-ins have been built and are shared to help teachers with grading. You can start your search here: <a href="https://edwiser.org/blog/grading-in-moodle/" target="_blank" rel="noopener" data-cke-saved-href="https://edwiser.org/blog/grading-in-moodle/">https://edwiser.org/blog/grading-in-moodle/</a>.</p>
         <p class="hanging-indent"><sup>4</sup> There are a lot of positions about homework to be read on the internet. Some in favour, some against. Furthermore, the different European countries may have different rules concerning these questions. One interesting, but US based, discussion can be found here: <a href="https://www.procon.org/headlines/homework-pros-cons-procon-org/" target="_blank" rel="noopener" data-cke-saved-href="https://www.procon.org/headlines/homework-pros-cons-procon-org/">https://www.procon.org/headlines/homework-pros-cons-procon-org/</a>.</p>
         <p class="hanging-indent"><sup>5</sup> The FIDE is the body in charge of chess worldwide. It has specialists working on the issue of chess in education: <a href="https://edu.fide.com/" target="_blank" rel="noopener" data-cke-saved-href="https://edu.fide.com/">https://edu.fide.com/.</a></p>
         <p class="hanging-indent"><sup>6</sup> Nukkai is a French AI company whose AI software Nook has beaten, in March 2022, teams of world champions at Bridge. They are also working on a version of Bridge which can teach logics to children. <a href="https://nukk.ai/" target="_blank" rel="noopener" data-cke-saved-href="https://nukk.ai/">https://nukk.ai/.</a></p>
         <p class="hanging-indent"><sup>7</sup> There are many references covering the story of Deep Blue’s victory over Gary Kasparov. IBM’s view is obviously biased but worth reading as IBM will insist on the <strong>computer</strong> winning rather than the algorithm. <a href="https://www.ibm.com/ibm/history/ibm100/us/en/icons/deepblue/" target="_blank" rel="noopener" data-cke-saved-href="https://www.ibm.com/ibm/history/ibm100/us/en/icons/deepblue/">https://www.ibm.com/ibm/history/ibm100/us/en/icons/deepblue/.</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-obsolescence" title="过时了吗？">
         <header>
              <h1 class="chapter-title">过时了吗？</h1>
              <p data-type="subtitle" class="chapter-number">44</p>
         </header>
         <p class="no-indent">        2022年9月，我们在南特大学开放日举办了一场小型研讨会，邀请了一些年轻人参加。我们向他们解释了人工智能对就业市场的影响，以及对某些职业的未来不太乐观<sup>1</sup>的想法。随后，我们要求他们重新审视学校课程，并列出两列内容：一列是那些在他们看来已经不再需要学习的课程主题，另一列则是他们认为需要增加学习时间或引入的新主题。<br />
          ​​​​​</p>
         <figure id="attachment_161" aria-describedby="caption-attachment-161" style="width: 213px" class="wp-caption alignleft">
              <img class="size-medium wp-image-161" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-213x300.jpg" alt="" width="213" height="300" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-213x300.jpg 213w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-727x1024.jpg 727w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-768x1082.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-1090x1536.jpg 1090w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-65x92.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-225x317.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence-350x493.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/ch7-page3-obsolescence.jpg 1453w" sizes="(max-width: 213px) 100vw, 213px" />
              <figcaption id="caption-attachment-161" class="wp-caption-text">“成年人已过时” 由 917press 创作，根据 CC BY-NC-SA 2.0 许可证授权。要查看此许可证的副本，请访问 <a href="https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse">https://creativecommons.org/licenses/by-nc-sa/2.0/?ref=openverse</a>.</figcaption>
         </figure>
         <p class="no-indent">        我们强调三点：(1) 这次研讨会仅是一个前瞻性的讨论，没有科学依据，所得结论纯属推测。(2) 在研讨会之前，我们并未涉及教育议题，仅探讨了工作相关的话题，且参与者并非教育领域的专家。(3) 关于21世纪所需技能的问题，已经有许多更权威的文献和立场文件进行了深入阐述。</p>
         <p class="indent">因此，这次研讨会的结论更多是从“普通大众可能的看法”这一角度出发。如果某个主题被放在了第一列，那就意味着有参与者认为这个主题已经过时。</p>
         <p class="indent">有趣的是，我们发现（外语）语言学习总是被放在第一列，即被认为可能过时的领域。这让我们回想起另一场与语言教师进行的研讨会，他们提到学生过于依赖自动翻译工具，而这些工具并未给学生带来额外的价值。一些教师还观察到，学生们对语言学习的价值持怀疑态度，因此教师在激发学生语言学习动力方面，面临着挑战。</p>
         <p class="indent">两组参与者都提出了一些观点：</p>
         <ul>
              <li>学生们更倾向于使用AI，他们认为AI比他们即使付出努力所能达到的水平还要好；</li>
              <li>技术发展的速度让他们觉得，等他们完成学业时，技术可能已经找到了更便捷的解决方案。和大多数人一样，他们也对技术的快速发展和进步感到担忧。</li>
         </ul>
         <p class="no-indent">如上所述，这些观点并不是要说明语言学习已经过时。但它们确实表明，如果公众普遍认为某些技能不再必要，那么教授这些技能将会变得更加困难。</p>
         <h3 style="text-align: left">信息检索的类似问题</h3>
         <p class="no-indent">正如 D. Russell 所说<sup>2</sup>：<em>“更大的问题是：在如今几乎可以在线搜索任何主题的时代，成为一个具备信息素养和信息检索技能的用户意味着什么？”</em>然而，尽管市面上已有众多课程教我们如何更好地使用搜索引擎，也有很多人认为掌握搜索技巧是当代社会不可或缺的一项技能。</p>
         <h3 style="text-align: left">解决方案是什么？</h3>
         <p class="no-indent">以语言学习为例（这一挑战同样也适用于其他技能和主题），教师和教育机构需要在问题显现之前就深入研究AI的影响。我们需要回顾，2000年教授这些语言课程的原因是什么？这些原因在今天是否依然成立？有没有出现新的教学需求？在明确了这些原因之后，我们又该如何有效地将这些信息传达给学生及其家长呢？</p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Many websites list the jobs that will disappear by 2030. Some of these are intellectual and even artistic. Architects, for example, should worry a little: AI can play a big part in their profession. This link is not representative but has some great images of futuristic AI-designed buildings:<a href="https://edition.cnn.com/style/article/ai-architecture-manas-bhatia/index.html." target="_blank" rel="noopener"> https://edition.cnn.com/style/article/ai-architecture-manas-bhatia/index.html.</a></p>
         <p class="hanging-indent"><sup>2</sup> Russell, D., <em>What Do You Need to Know to Use a Search Engine? Why We Still Need to Teach Research Skills</em>, AI Magazine, 36(4), 2015.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-individual-or-collective-ai" title="面向个体或群体的AI">
         <header>
              <h1 class="chapter-title">面向个体或群体的AI</h1>
              <p data-type="subtitle" class="chapter-number">45</p>
         </header>
         <p class="no-indent">       明天，人工智能面临的关键问题可能是：AI到底是为谁服务的？</p>
         <p class="indent">当你使用一款理应在学习上给你带来助力的工具时，你自然希望它能如你所愿。但有没有可能，这款工具实际上是在追求一个更复杂的优化目标，而不仅仅是满足你的需求？那么，只要我们能得到预期的学习成果，这个问题真的重要吗？我们一起来探讨一下。</p>
         <p class="indent">当然，当AI是由一家私营公司开发时，了解它的商业模式就显得尤为重要。这会帮助我们理解它到底是为谁服务的：如果这是一款一次性购买的学习软件，面向的是家长群体，那么公司必须有足够的理由来吸引他们。而如果目标用户是学校、教师或政府，那么他们的需求就会有所不同，软件的设计和功能也会相应调整。</p>
         <p class="indent">我们要记住的是，当涉及到基于机器学习的AI软件时，学习过程总是围绕一个目标函数进行的。可以训练神经网络来减少学生的学习时间，提高测验成绩，或者可能同时优化这两个方面。</p>
         <p class="indent">但在很多情况下，学习是在一个社会环境中进行的，而AI给出的建议可能会同时影响到个体和整个群体。</p>
         <p class="indent">为了深入探讨这个观点，让我们以Waze为例，看看它是如何运作的。Waze是一款广受欢迎的交通导航应用，虽然在学校中不太常见，但老师们为了准时到达学校常常会选择使用它。</p>
         <h3 style="text-align: left">Waze</h3>
         <p class="no-indent">        Waze是一款为司机提供导航服务的应用，旨在帮助他们找到最佳路线。每月有高达1.5亿的用户在使用它。除了具备社交网络的诸多功能外，Waze在分析交通状况时所使用的数据并非来源于官方的开放数据库或摄像头，而是来自于用户自己<sup>1</sup>。</p>
         <p class="indent">对于那些不使用Waze的人来说，这里有一个简单的总结它是如何工作的——它就像是你每天上班路上的得力助手。即使你对路线了如指掌，Waze仍然能为你提供诸多便利。</p>
         <p class="indent">你周围的许多司机也会这样做。在地图上，你会看到一条精心计算的路线，指引你顺利到达目的地。同时，系统还会实时更新预计到达时间，让你随时掌握路况变化。此外，系统还会及时提醒你前方路况，比如260米处有障碍物，1公里处发生了车祸，3公里处出现了交通堵塞等。根据这些实时信息，系统还会为你规划一条能节省七分钟的替代路线。</p>
         <p class="indent">为了让这一切得以顺利实现，作为Waze的用户，你需要通过系统输入路况信息，提醒其他用户注意前方有动物出没。同样重要的是，当动物或障碍物已经离开原地时，你也需要及时更新信息。</p>
         <h3 style="text-align: left">AI究竟在哪里发挥作用？</h3>
         <p class="no-indent">        在预计时间、路线等的计算中，AI的身影无处不在。它同时考虑到静态信息（距离）和动态信息（汽车的速度）。Waze还能通过分析你的驾驶历史，了解你的驾驶模式<sup>2</sup>。Waze甚至能预测交通灯的变化是否有利于你的行驶。</p>
         <p class="indent">但AI的能力远不止于此。当一个Waze用户输入新信息时，系统如何考虑它？假设我报告道路堵塞，那会发生什么？就像人类专家会核实信息、评估用户可信度、确认现场情况一样，AI也会进行这些操作。</p>
         <p class="indent">不仅如此，当系统检测到某条道路拥堵时，它会智能地引导用户选择其他路线。但如何确保新路线的交通状况真的更好呢？毕竟，已经陷入拥堵的车辆无法提供实时信息。这时，AI会派出一些“探路”车辆前往现场，以获取最真实的路况信息，从而确保用户能够避开拥堵，顺利到达目的地。</p>
         <h3 style="text-align: left">一些伦理考虑？</h3>
         <p class="no-indent">        存在许多伦理方面的考量：</p>
         <ol>
              <li>Waze掌握了你大量的个人信息——你的居住地、工作地点、常去的地点以及你的习惯。它会向你推送你可能感兴趣或不感兴趣的广告。</li>
              <li>为了满足尽可能多的客户需求，Waze需要解决许多探索/利用的困境，比如上面提到的。它是如何做出决策的？有没有正确的决策方式？</li>
              <li>经常使用这些工具确实会影响我们解决问题的能力。现在已经知道，这些工具正在影响我们的（人类）认知能力。举个例子，这绝非个例，本书的作者有一次早上使用Waze时，系统建议他离开高速公路以避免拥堵。在沿着一条宁静的二级公路行驶了两公里后，Waze改变了主意，建议他回到高速公路上才是最佳路线。这个例子重要的不仅仅是系统改变了优化路线（这本身是合理的），而是我们对这类AI驱动的系统的依赖使我们失去了独立判断的能力<sup>3</sup>。</li>
         </ol>
         <h3 style="text-align: left">对教育的影响</h3>
         <p class="no-indent">        据我们所知，这个群体处理的问题在教育中还没有出现 &#8211; 至少现在还没有。当资源是无限的（例如，访问一个网络平台），这种情况影响不大。但假设资源是有限的：同一时间只有三个学生可以使用机器人。在这种情况下，一个人工智能系统将会提议哪些学生应该有机会使用机器人。许多因素可能支配决策。如果系统想要公平，决策可能是随机的。但许多人对此不会满意。如果系统想要为整个教室获得最佳结果，它可能会分配更多资源给处于劣势的儿童。但如果系统被赋予的任务是确保至少90%的学生在学期末获得XYZ等级，这并不意味着每个学生现在都有90%的成功机会，而是意味着10%的学生肯定会失败。</p>
         <h3 style="text-align: left">教师的角色</h3>
         <p class="no-indent">        身处人工智能时代，教师不仅要掌握这些系统的工作原理，还需了解算法的局限，并学会做出正确决策。这听起来简单，实施起来却并不容易。虽然教师可以利用人工智能系统，就像前面提到的导航工具那样，为所有人带来便利。但是，教师更应该结合自己的教学经验，对人工智能提出的建议进行审慎评估。在道路上耽误15分钟，对成年人来说或许影响不大。但对于学生来说，教师做出的每一个决定都可能对他们的成长产生深远影响。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup><a href="https://www.cozyberries.com/waze-statistics-users-facts/" target="_blank" rel="noopener" data-cke-saved-href="https://www.cozyberries.com/waze-statistics-users-facts/">https://www.cozyberries.com/waze-statistics-users-facts/</a> and <a href="https://www.autoevolution.com/news/waze-reveals-how-many-users-run-the-app-on-android-and-iphone-197107.html" target="_blank" rel="noopener" data-cke-saved-href="https://www.autoevolution.com/news/waze-reveals-how-many-users-run-the-app-on-android-and-iphone-197107.html">https://www.autoevolution.com/news/waze-reveals-how-many-users-run-the-app-on-android-and-iphone-197107.html</a> for some facts and figures concerning Waze.</p>
         <p class="hanging-indent"><sup>2 </sup>Petranu, Y. <em>Under the Hood: Real-time ETA and How Waze Knows You’re on the Fastest Route</em>. <a href="https://medium.com/waze/under-the-hood-real-time-eta-and-how-waze-knows-youre-on-the-fastest-route-78d63c158b90" target="_blank" rel="noopener" data-cke-saved-href="https://medium.com/waze/under-the-hood-real-time-eta-and-how-waze-knows-youre-on-the-fastest-route-78d63c158b90">https://medium.com/waze/under-the-hood-real-time-eta-and-how-waze-knows-youre-on-the-fastest-route-78d63c158b90</a></p>
         <p class="hanging-indent"><sup>3 </sup>Clemenson, G.D., Maselli, A., Fiannaca, A.J. <i>et al.</i> <em>Rethinking GPS navigation: creating cognitive maps through auditory clues</em>. <i>Sci Rep</i> <b>11</b>, 7764 (2021). <a href="https://doi.org/10.1038/s41598-021-87148-4" target="_blank" rel="noopener" data-cke-saved-href="https://doi.org/10.1038/s41598-021-87148-4">https://doi.org/10.1038/s41598-021-87148-4</a><br />
          <a href="https://www.nature.com/articles/s41598-021-87148-4" target="_blank" rel="noopener" data-cke-saved-href="https://www.nature.com/articles/s41598-021-87148-4">https://www.nature.com/articles/s41598-021-87148-4</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-teaching-ai" title="教授人工智能">
         <header>
              <h1 class="chapter-title">教授人工智能</h1>
              <p data-type="subtitle" class="chapter-number">46</p>
         </header>
         <p class="no-indent">        在这个阶段，我们认为教师在人工智能方面的水平已经足够高，能够安全、有效地使用人工智能，为教育过程增添价值。教师可能还想与学生分享一些行业内的知识，或者解释某些工具的工作原理。但这并不意味着教师已经承担起教授AI的角色和任务。</p>
         <p class="indent">然而，这个问题迟早会被提出：是否需要对每个人都进行AI方面的教育？如果需要，那么应该教授哪些内容？由谁来教授？教师还需要学习多少知识？</p>
         <h3 style="text-align: left">我们从教授编程中学到了什么</h3>
         <p class="no-indent">        十年前，多数欧洲国家达成共识：仅仅教会孩子如何使用计算机还远远不够，必须教他们编程（有时，更有远见地还会教授计算机科学与信息技术）<sup>1,2</sup>。当时使用的论据，在今天看来对人工智能也同样适用：</p>
         <ul>
              <li>编程和写作、计算一样有用</li>
              <li>许多人类活动从编程中受益</li>
              <li>编程与解决问题等其他必要技能相关</li>
         </ul>
         <p class="no-indent">        因此，编程课程被引入学校，但成效各异<sup>3</sup>。在培训教师方面，投入的资源不足。这里存在一个复杂的问题——过度培训教师可能导致他们转行到薪酬更高的计算机行业，从而放弃教育事业。欧洲信息学协会(Informatics Europe)和其他组织的报告都指出了这一点（当然也有例外）。</p>
         <p class="indent">培训教师历来是各国面临的复杂任务，到2023年，成果仍然参差不齐。在多数国家，人们普遍感觉缺乏足够经过充分培训的教师。这使得培训教师教授AI变得尤为复杂，尤其是要达到能够教授AI的水平（而不是使用AI教学）。</p>
         <h3 style="text-align: left">AI素养</h3>
         <p class="no-indent">       第一个目标可能是在学校引入某种形式的AI素养。然而，目前大家对于这一素养具体应包含哪些内容还没有达成共识。我们是应该深入解释AI的工作原理，还是只需说明它的应用结果？素养是否仅仅意味着理解AI？那么适应和创新能力又该如何培养呢？这些问题亟待我们探讨。或许，在明确AI素养课程的教学内容之前，我们首先要明确我们的教育目标是什么。</p>
         <p class="indent">普及人工智能素养有助于人们区分什么是魔法，什么是科学。为了让学生们能够更直观地了解新的AI解决方案，并对其工作原理（而不仅仅是它做了什么）有所感悟，我们需要进行实践性的培训。学生需要能够测试系统并了解这些系统是如何工作的。</p>
         <h3 style="text-align: left">范式</h3>
         <p class="no-indent">        AI并不仅限于算法。它涉及许多人类层面的因素，需要我们深入思考。举例来说，很多AI方法会在一定程度上依赖于随机性，这可能对那些旨在协助我们做出重大决策的技术来说显得有些奇怪（或者，在越来越多的情况下，如证券交易所，这些技术直接负责执行决策）。</p>
         <p class="indent">然而，如果AI在未来要扮演关键角色，我们是否应该尽早开始着手准备呢？</p>
         <p class="indent">在2018年为联合国教科文组织撰写的一份报告中<sup>4</sup>，以下五个问题需要在当前的教育系统中得到重视和解决：</p>
         <ol>
              <li>尽管使用这些工具看似不需要直接编程，但AI工具背后的逻辑仍遵循着可以通过编程学习到的规则。</li>
              <li>随机性至关重要。AI会犯错，且这些错误在很多情况下都是不可避免的。错误可能源于数据或传感器的质量，也可能因为所使用的算法具有统计性质。大部分AI算法并不追求绝对正确。</li>
              <li>世界不再具有确定性。这是上述观点的一个必然结果，但其影响具体而深远。因为我们现在明白，一个AI系统可能会针对简单问题给出不同，甚至相互矛盾的答案。阅读Alan Turing(1950)的论文<sup>6</sup>可以帮助我们更深入地理解这些问题。</li>
              <li>批判性思维至关重要，但知道如何使用正确的工具也同样重要。AI工具在创建假图像、视频以及现在的文本方面越来越出色。也许不久的将来，我们甚至会看到假的讲座。仅凭常识不足以帮助我们判断图像、声音或文本是否为假。</li>
              <li>我们珍视自己的价值观——分析世界、做出伦理决策、质疑我们为何花费时间学习或工作。</li>
         </ol>
         <p class="no-indent">        考虑到AI在不断进步，这些价值观需要被审视。</p>
         <p class="indent">每天，我们对真理的认知都在变得更加模糊。当AI能够参考集体经验并处理大量数据时，个人的经验或许就不再那么受重视了。</p>
         <p class="indent">对这些问题进行深入了解或至少展开探究，显得尤为重要。</p>
         <h3 style="text-align: left">课程和框架</h3>
         <p class="no-indent">        到2023年底，为K-12及其教师设计的AI课程仍然相当匮乏<sup>4,5</sup>。联合国教科文组织已经开始对这些课程进行调研，并予以展示<sup>8</sup>。</p>
         <p class="indent">作为全球教育的领军组织，联合国教科文组织一直密切关注教育的未来走向<sup>9</sup>，它对AI在教育领域的应用及其影响格外关注。该组织为政策制定者和教师提供了大量关于AI、教育伦理以及生成式AI在教育中的应用的文档。2023年，联合国教科文组织的专家们致力于撰写一份描述教师和学生应具备的AI相关能力的文档<sup>11</sup>。最终版本预计将于2024年发布。这份2023年的文档提议了一种平衡技术问题和更多与社会科学相关问题的观点，特别是针对教师的专业发展问题。虽然编程技能不是立即需要的，但它似乎对于更好地理解AI至关重要。</p>
         <h3 style="text-align: left">AI编程</h3>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>了解更多！</strong></p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/ai-and-coding/" target="_blank" rel="noopener">AI和编码：编码、无代码或低代码？</a>
              </div>
         </div>
         <p class="no-indent">       自2012年起，欧洲多国开始大力推广编程教育。到2023年，欧洲联盟更是加大了对信息学教学的支持力度。</p>
         <p class="indent">然而，随着生成式AI技术的兴起及其对教育领域的潜在影响逐渐显现<sup>10</sup>，人们开始质疑学习编程的必要性。我们不能让AI为我们完成这项任务吗？或者，考虑到未来许多职业都将与AI密切相关，我们是否应该学习编程，以便更好地利用AI技术？</p>
         <div class="textbox textbox--sidebar textbox--examples">
              <header class="textbox__header">
                   <p class="textbox__title" style="text-align: center"><strong>了解更多！</strong></p>
              </header>
              <div class="textbox__content">
                   <a href="https://pressbooks.pub/aiforteachers/chapter/machine-learning-ai-through-data-experiments-in-orange/" target="_blank" rel="noopener">尝试Orange？</a>
              </div>
         </div>
         <p class="no-indent">        学习编码的主要原因是教师或学生可以在计算机程序中使用AI。与AI编程相关的任务有很多。构建模型通常是数据科学和机器学习的一部分。一个优秀的程序员能够处理和分析数据集，从中提取有用的信息和模式，并通过机器学习算法来优化程序性能。程序员还可以定义有意义的属性，或者让算法自动对文本或图像进行分类。有些编程语言，如Orange，特别擅长这方面的工作。当然，在其他情况下，程序员也可能会选择使用Python等通用编程语言来完成任务。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup> Royal Society (2012). <em>Shut down or restart? Report of the Royal Society.</em> 2012<a href="https://royalsociety.org/topics-policy/projects/computing-in-schools/report/T" target="_blank" rel="noopener"> https://royalsociety.org/topics-policy/projects/computing-in-schools/report/T.</a></p>
         <p class="hanging-indent"><sup>2 </sup>Académie des Sciences (2013). <em>L’Académie des Sciences : L’enseignement de l’informatique en France – Il est urgent de ne plus attendre.</em><a href="http://www.academie-sciences.fr/fr/activite/rapport/rads_0513.pdf" target="_blank" rel="noopener"> http://www.academie-sciences.fr/fr/activite/rapport/rads_0513.pdf</a></p>
         <p class="hanging-indent"><sup>3 </sup>Informatics Europe (2017). <a href="https://www.informatics-europe.org/news/382-informatics-education-in-europe-are-we-on-the-same-boat.html" target="_blank" rel="noopener"> Informatics Education in Europe: Are We All in the Same Boat?</a></p>
         <p class="hanging-indent"><sup>4 </sup> Colin de la Higuera (2018). <em>Report on Education, Training Teachers and Learning Artificial Intelligence.</em> <a href="https://www.k4all.org/project/report-education-ai/" target="_blank" rel="noopener">https://www.k4all.org/project/report-education-ai/</a></p>
         <p class="hanging-indent"><sup>5 </sup>Touretzky, D., Gardner-McCune, C., Martin, F., &amp; Seehorn, D. (2019). <em>Envisioning AI for K-12 : What Should Every Child Know about AI ?</em> Proceedings of the AAAI Conference on Artificial Intelligence, 33, 9795-9799.<a href="https://doi.org/10.1609/aaai.v33i01.33019795" target="_blank" rel="noopener"> https://doi.org/10.1609/aaai.v33i01.33019795</a></p>
         <p class="hanging-indent"><sup>6 </sup>A. M. Turing (1950)—Computing Machinery and Intelligence, Mind, Volume LIX, Issue 236, October 1950, Pages 433–460,<a href="https://doi.org/10.1093/mind/LIX.236.433" target="_blank" rel="noopener"> https://doi.org/10.1093/mind/LIX.236.433</a></p>
         <p class="hanging-indent"><sup>7 </sup>Howell, E. L., &amp; Brossard, D. (2021). <em>(Mis) informed about what? What it means to be a science-literate citizen in a digital world.</em> Proceedings of the National Academy of Sciences, 118(15), e1912436117.<a href="https://www.pnas.org/doi/abs/10.1073/pnas.1912436117" target="_blank" rel="noopener"> https://www.pnas.org/doi/abs/10.1073/pnas.1912436117</a></p>
         <p class="hanging-indent"><sup>8 </sup>Unesco (2022) K-12 AI curricula: a mapping of government-endorsed AI curricula.<a href="https://unesdoc.unesco.org/ark:/48223/pf0000380602" target="_blank" rel="noopener"> https://unesdoc.unesco.org/ark:/48223/pf0000380602</a></p>
         <p class="hanging-indent"><sup>9 </sup>Unesco (2023). Artificial intelligence and the Futures of Learning. <a href="https://www.unesco.org/en/digital-education/ai-future-learning" target="_blank" rel="noopener">https://www.unesco.org/en/digital-education/ai-future-learning</a></p>
         <p class="hanging-indent"><sup>10 </sup>Unesco (2023). Guidance for generative AI in education and research. <a href="https://www.unesco.org/en/articles/guidance-generative-ai-education-and-research" target="_blank" rel="noopener">https://www.unesco.org/en/articles/guidance-generative-ai-education-and-research</a></p>
         <p class="hanging-indent"><sup>11 </sup>Unesco (2023). AI Competency frameworks for students and teachers. <a href="https://www.unesco.org/en/digital-education/ai-future-learning/competency-frameworks" target="_blank" rel="noopener">https://www.unesco.org/en/digital-education/ai-future-learning/competency-frameworks</a></p>
    </section>
</div>
<div data-type="part" class="part" id="part-additional-content">
    <header>
         <h1 class="part-title">附加内容</h1>
         <p data-type="subtitle" class="part-number">VIII</p>
    </header>
    <section data-type="chapter" class="chapter" id="chapter-optical-character-recognition" title="光学字符识别（OCR）">
         <header>
              <h1 class="chapter-title">光学字符识别（OCR）</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent"><strong>       OCR</strong>是用于识别照片中的字符的人工智能技术。它还可以帮助PDF阅读器扫描图像上的文字。邮局使用它来分拣信件和包裹。</p>
         <p class="indent">现在的OCR系统非常先进。连人类都难以辨认的潦草字迹，它都能轻松解读。想象一下，当你拿到医生写的处方时，可能连药剂师都看不懂，但OCR应用却有可能帮你找到正确的药物！不过，它可不会告诉你医生是否写错了字哦……</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-slug-42" title="42">
         <header>
              <h1 class="chapter-title">42</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">42在极客文化中是一个特殊的数字。这是一个名为“深思（Deep Thought）”的庞大超级计算机经过750万年的计算得出的答案。</p>
         <p class="indent">不幸的是，没有人知道问题是什么！</p>
         <p class="indent">因此，在书籍《生命、宇宙以及一切的终极问题的答案》中，出现了一个由有机成分构成的、大小相当于一颗小行星的特殊计算机，它被命名为“地球”，用于计算那个终极问题。</p>
         <p>&nbsp;</p>
         <p class="indent">查看<a href="https://en.wikipedia.org/wiki/42_(number)" target="_blank" rel="noopener">维基百科关于42的网页</a>了解完整故事！</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-a-brief-description-of-some-search-engines" title="一些搜索引擎的简要描述">
         <header>
              <h1 class="chapter-title">一些搜索引擎的简要描述</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.bing.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.bing.com/"><span style="background-color: #ffffff">Bing</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li style="text-align: justify"><strong>来源：</strong>Bing</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>从Bing收集您的数据，并从第三方购买您的数据。隐私政策取决于您使用的账户类型。这些数据用于个性化和针对性广告。与微软控制的附属公司和子公司共享数据；与代表我们工作的供应商等共享数据。</li>
                        <li style="text-align: justify"><strong>Cookie政策：</strong>出于多种目的收集cookies。</li>
                        <li style="text-align: justify"><strong>隐私设置：</strong>菜单 &gt; 隐私</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://search.brave.com/" target="_blank" rel="noopener" data-cke-saved-href="https://search.brave.com/"><span style="background-color: #ffffff">Brave</span> </a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li style="text-align: justify"><strong>来源</strong>：Brave（2021年以前使用Google，如果搜索结果不足，仍会与其他来源比较），Bing用于图像和视频结果</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>不收集个人数据、搜索查询或鼠标点击</li>
                        <li style="text-align: justify"><strong>Cookie政策：</strong>记住设置 &#8211; 即使这是匿名的，并且用户可以关闭</li>
                        <li style="text-align: justify"><strong>设置：</strong>菜单 &gt; 显示更多</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://duckduckgo.com/" target="_blank" rel="noopener" data-cke-saved-href="https://duckduckgo.com/"><span style="background-color: #ffffff">DuckDuckGo</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>超过400个来源 – 包括其他搜索引擎，如Yahoo、Bing和Google。</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>不收集个人数据，搜索查询以汇总的方式记录，不包含个人数据</li>
                        <li><strong>Cookie政策：</strong>不使用跟踪或识别cookies</li>
                        <li><strong>隐私设置：</strong>菜单 &gt; 所有设置 &gt; 隐私</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.ecosia.org/?tt=ba893d82&amp;gclid=Cj0KCQjwkOqZBhDNARIsAACsbfJRLI3qDUK3kcAU2FGQRzlkK4yAi3QQqLR6NKQ8pXG6v0MYOhZFqcAaAlaQEALw_wcB" target="_blank" rel="noopener" data-cke-saved-href="https://www.ecosia.org/?tt=ba893d82&amp;gclid=Cj0KCQjwkOqZBhDNARIsAACsbfJRLI3qDUK3kcAU2FGQRzlkK4yAi3QQqLR6NKQ8pXG6v0MYOhZFqcAaAlaQEALw_wcB"><span style="background-color: #ffffff">Ecosia</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Bing</li>
                        <li><strong>数据政策：</strong>不出售个人或搜索数据，7天内匿名化数据</li>
                        <li><strong>Cookie政策：</strong>没有第三方跟踪，最小化的可关闭的跟踪</li>
                        <li><strong>隐私设置：</strong>菜单 &gt; 所有设置</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.google.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.google.com/"><span style="background-color: #ffffff">Google</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Google</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>收集个人数据、搜索词、互动、活动和跨Google应用程序的偏好；收集使用Google服务的第三方网站和应用上的活动。这些数据用于个性化、针对性广告和改进Google服务。Google还从公开可获取的来源、可信来源和广告合作伙伴那里收集关于您的信息。</li>
                        <li><strong>Cookie政策：</strong>出于多种目的收集cookies。</li>
                        <li style="text-align: justify"><strong>隐私设置：</strong>设置 &gt; 搜索设置以进行安全搜索；设置 &gt; 您在搜索中的数据或登录时在Google账户下的隐私设置</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://metager.org/" target="_blank" rel="noopener" data-cke-saved-href="https://metager.org/"><span style="background-color: #ffffff">MetaGer</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Yahoo, Bing, Scopia, Infotiger, OneNewspage, Kelkoo</li>
                        <li><strong>数据政策：</strong>不跟踪或存储个人数据，搜索记录在96小时内删除</li>
                        <li><strong>Cookie政策：</strong>使用非个人可识别的cookies来保存搜索设置</li>
                        <li><strong>隐私设置：</strong>菜单 &gt; 设置安全过滤器和黑名单</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.onesearch.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.onesearch.com/"><span style="background-color: #ffffff">OneSearch</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Bing</li>
                        <li><strong>数据政策：</strong>不存储搜索历史，IP地址存储4天。</li>
                        <li><strong>Cookie政策：</strong>不使用cookies。</li>
                        <li><strong>隐私设置：</strong>在搜索框附近的开关切换高级隐私设置。</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.qwant.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.qwant.com/"><span style="background-color: #ffffff">Qwant</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>自身，Bing</li>
                        <li><strong>数据政策：</strong>不存储个人信息或搜索，匿名化IP存储7天</li>
                        <li><strong>Cookie政策：</strong>不使用跟踪cookies</li>
                        <li><strong>隐私设置：</strong>菜单 &gt; 设置安全过滤器</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://www.startpage.com/" target="_blank" rel="noopener" data-cke-saved-href="https://www.startpage.com/"><span style="background-color: #ffffff">Startpage</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Google</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>不收集个人数据或记录搜索查询，匿名化数据，清晰标记赞助内容</li>
                        <li><strong>Cookie政策：</strong>不使用跟踪或识别cookies</li>
                        <li><strong>隐私设置：</strong>可以通过菜单 &gt; 设置 &gt; 向下滚动到“隐私和安全”访问</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--key-takeaways">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://swisscows.com/en" target="_blank" rel="noopener" data-cke-saved-href="https://swisscows.com/en"><span style="background-color: #ffffff">Swisscows</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Swisscows （德语搜索），Bing（其他语言）</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>不存储任何数据，因此不基于收集的数据提供广告，搜索查询在7天后匿名化</li>
                        <li><strong>Cookie政策：</strong>不使用cookies</li>
                        <li><strong>隐私设置：</strong>不需要！</li>
                   </ul>
              </div>
         </div>
         <div class="textbox textbox--exercises">
              <header class="textbox__header">
                   <p class="textbox__title"><a href="https://search.yahoo.com/" target="_blank" rel="noopener" data-cke-saved-href="https://search.yahoo.com/"><span style="background-color: #ffffff">Yahoo!</span></a></p>
              </header>
              <div class="textbox__content">
                   <ul>
                        <li><strong>来源：</strong>Bing</li>
                        <li style="text-align: justify"><strong>数据政策：</strong>收集个人数据、搜索词、互动、活动和偏好，跨Yahoo!应用；在使用Yahoo!服务的第三方网站和应用上的活动。这些数据用于个性化、针对性广告和改进服务。Yahoo!还从公开可获取的来源、可信来源和广告合作伙伴那里收集关于您的信息。</li>
                        <li><strong>Cookie政策：</strong>出于多种目的收集cookies。</li>
                        <li><strong>隐私设置：</strong>菜单 &gt; 设置 &gt; 偏好设置</li>
                   </ul>
              </div>
         </div>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-optimising-search" title="优化搜索">
         <header>
              <h1 class="chapter-title">优化搜索</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">这是优化搜索练习“<a href="https://pressbooks.pub/aiforteachers/chapter/search-engines-part-1/" target="_blank" rel="noopener">搜索引擎第一部分”</a>章节的关键。</p>
         <p class="indent">搜索引擎会不断微调它们的算法，而不同的搜索引擎其搜索和排序算法也会有所区别。因此，在一个搜索引擎上效果好的搜索方法，在另一个搜索引擎上可能就不奏效了。不过，还是有一些通用的规则，能够帮助我们在大多数情况下优化搜索效果。</p>
         <p>最好<strong>避免使用单个词的搜索查询</strong>。一个好的经验法则是包含上下文信息，明确你想要通过搜索的目标。但是，如果用的词太多，可能会找不到结果，或者返回的结果不相关：尝试用<strong>几个关键名词</strong>描述你的需求，同时避免使用过于泛泛的词汇。</p>
         <p class="indent">搜索是一个迭代过程。你需要根据有效的内容<strong>重新构思问题</strong>。</p>
         <p>下面是一个来自《英国教育技术杂志》的一个例子，展示了学生如何通过迭代搜索来找到所需信息：<br />
          “Nomusa在目标领域优化了检索指令，因此她能够构建出以下搜索序列：</p>
         <ul>
              <li class="no-indent"><strong><em>可持续建筑材料</em></strong>（在结果列表中看不到有趣的内容）</li>
              <li class="no-indent"><em><strong>可持续生计</strong></em>（探索两个搜索结果）</li>
              <li class="no-indent"><em><strong>可持续生计建筑材料</strong></em>（找到一个目标来源）</li>
         </ul>
         <p>这种搜索序列的使用是经验丰富的网络搜索者常用的策略。他们通常会对查询词进行微小的调整，然后反复进行查询<sup>1</sup>。</p>
         <p class="indent">如果你想了解AI在搜索引擎中的应用，可以尝试搜索<strong><em>搜索引擎中的人工智能</em>，<em>搜索引擎中使用的人工智能</em></strong>等。</p>
         <ul>
              <li style="text-align: justify"><strong>使用引号强制搜索引擎寻找与引号内精确匹配的词语</strong>。搜索<strong><em>烤奶酪食谱</em></strong>可能包括芝士蛋糕食谱，而<strong><em>&#8220;烤奶酪&#8221; 食谱</em></strong>将避免这种混淆。<strong><em>&#8220;东德人&#8221;故事</em></strong>将显示同时包含东和德国的结果，这应通过比较<strong><em>&#8220;东德人&#8221;故事</em></strong>和<strong><em>东德人故事</em></strong>的搜索结果页数来证明。</li>
              <li style="text-align: justify">搜索引擎<strong>忽略标点符号</strong>，除了 &#8216; 和 &#8220;（如上所述，以及表示所有权）。</li>
              <li style="text-align: justify"><em><strong>附近</strong></em>显示给定位置附近的内容。<em><strong>我附近</strong></em>将显示设备当前位置适用的结果。如果你正在参观埃菲尔铁塔，那么搜索<em><strong>埃菲尔铁塔附近的餐厅</strong></em>就能找到附近的餐厅。</li>
              <li style="text-align: justify">在一个词前加上减号符号将<strong>排除包含该词的页面</strong>；在&#8221;&#8221;内组合多个词可以使它们同时出现在搜索结果中。搜索<strong><em>人工智能 -&#8220;机器学习&#8221;</em></strong>将显示提到人工智能但不包括机器学习的结果。</li>
              <li style="text-align: justify">搜索<strong><em>x AND y</em></strong>寻找同时包含x和y的结果。搜索<strong><em>x OR y</em></strong>显示包含x或y或同时包含x和y的结果。注意AND和OR都是大写的。“当你想要包含两个具体同义或密切相关词的结果时，使用OR操作符。例如：<em><strong>直销营销顾问 OR 专家</strong></em>。这将同时显示<em><strong>直销营销顾问</strong></em>和<em><strong>直销营销专家</strong></em>”<sup>2</sup>的搜索结果。</li>
              <li style="text-align: justify">通配符<strong>* </strong>可以代替一个未知词。<strong><em>*<strong>加</strong>州大学</em></strong>的结果将包括南加州大学，而<strong><em>加州大学</em></strong>则不会，至少在搜索结果的前几页中不会。</li>
              <li style="text-align: justify"><em><strong>site:bbc.com</strong></em>只会返回在bbc.com网站中找到的内容。<strong><em>courses<strong> </strong>site:*.edu</em></strong>返回以.edu结尾的所有站点（教育机构）的结果。在寻找学术文章时，最好在特定网站如springer.com, scholar.google.com等查找。“搜索学术研究论文时，使用专门的学术信息集合会比在普通的开放网络上搜索更加高效。选择合适的资源进行搜索是一种必要的搜索范围界定，以确保得到适当类型的结果。信息空间并不是平滑的，而是具有独特的结构。对这种结构了解得越多，作为搜索者的效率就会越高<sup>3</sup>。”</li>
              <li style="text-align: justify"><em><strong>filetype:pdf</strong></em>或<em><strong>filetype:jpg</strong></em>等将分别返回PDF文档或JPG图像的链接。</li>
         </ul>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Walton, M., Archer, A., <em>The Web and information literacy: scaffolding the use ofweb sources in a project-based curriculum</em>, British Journal of Educational Technology, Vol 35 No 2, 2004.</p>
         <p class="hanging-indent"><sup>2 </sup>Spencer, S., <em>Google Power Search: The Essential Guide to Finding Anything Online With Google</em>, Koshkonong, Kindle Edition.</p>
         <p class="hanging-indent"><sup>3 </sup>Russell, D., <em>What Do You Need to Know to Use a Search Engine? Why We Still Need to Teach Research Skills</em>, AI Magazine, 36(4), 2015.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-x5gon" title="X5GON项目">
         <header>
              <h1 class="chapter-title">X5GON项目</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <figure id="attachment_170" aria-describedby="caption-attachment-170" style="width: 300px" class="wp-caption alignleft">
              <img class="wp-image-170 size-medium" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-300x178.jpg" alt="" width="300" height="178" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-300x178.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-1024x609.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-768x457.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-65x39.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-225x134.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected-350x208.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-Education-connected.jpg 1416w" sizes="(max-width: 300px) 100vw, 300px" />
              <figcaption id="caption-attachment-170" class="wp-caption-text">经作者许可复制</figcaption>
         </figure>
         <p class="no-indent" dir="ltr">对教师而言，寻找教育资源非常重要，特别是在准备新的讲座、探索新领域、或策划活动时。这些材料（课件）有时候只是用来记录信息，但有时教师可能想从这些材料中构建新的课件。一种聪明利用复制粘贴的方式是非常诱人的,也在认识上是合理的,因为这可以避免重复劳动。但很不幸的是,这通常是不合法的,因为它会侵犯版权法。</p>
         <p class="indent">当资源的作者用<a href="https://creativecommons.org/licenses/" target="_blank" rel="noopener" data-cke-saved-href="https://creativecommons.org/licenses/">创作共用许可证</a>授权他们的作品时，这些资源就成为了<strong>开放教育资源(OER)</strong>，教师可以自由地使用、修改、重组和分享它们。当然，使用时需要正确引用原作者。因此,识别一个资源是否为开放资源非常重要。</p>
         <p class="indent">网上有很多经过授权的开放教育资源集合和存储库可能存在于您的部门。但是,如何在整个网络上找到这些资源呢?是否有专门的搜索引擎可以帮助我们?</p>
         <p class="indent">X5-GON项目由欧盟资助，旨在找到并索引OER，并利用AI工具，特别是搜索工具，帮助用户更方便地找到这些资源。</p>
         <h3 style="text-align: left"></h3>
         <h3><em>在这个过程中</em><em>AI出现在哪些阶段？</em></h3>
         <p class="no-indent">它会出现在所有阶段：</p>
         <p class="indent">在摄取阶段，机器人会爬取网络并返回OER：这是一个复杂的过程，因为它意味着要识别OER以及相应的许可证。其中一部分可以被视为典型的<strong>分类</strong>任务（一个常见的AI任务）。</p>
         <p class="indent">当机器人找到某个资源后，需要从这个资源中提取文本。如果资源是音频或视频文件，则意味着需要使用转录技术。</p>
         <p class="indent"><img class="size-medium wp-image-171 alignleft" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-300x129.jpg" alt="" width="300" height="129" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-300x129.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-768x330.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-65x28.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-225x97.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery-350x150.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5-discovery.jpg 963w" sizes="(max-width: 300px) 100vw, 300px" />X5-GON中的“5”指的是项目希望解决的5个障碍或维度：其中之一是语言。因此，流程的下一步是使用自动翻译工具，以获取选定语言中的文本版本。这同样是一个典型的 AI 工具。</p>
         <p class="indent">此时，你可能会想：自动转录和翻译技术正在快速发展，但它们仍然会犯严重的错误。依赖这些技术是否安全？答案是搜索和推荐算法并不需要精确的文本。它们需要将文档定位在一个空间中，与关键词和其他文档相邻。</p>
         <p class="indent">想象一下你有一箱旧文件需要整理。理想情况下，你会希望有一个预设的整理系统，将每份文件放在正确的位置。但通常我们并没有这样预先存在的归档系统，而是根据文件的共同之处将它们放在一起，这些规则并未明确写出来。这两份文件放在一起是因为它们是同一年的，那两份是因为它们与汽车有关，另外两份是因为它们大小相同，诸如此类的共同属性。这里的关键词是“相邻”。我们将在后面的书中详细讨论这一点。</p>
         <p class="indent"><img class="size-medium wp-image-172 alignleft" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-300x194.jpg" alt="" width="300" height="194" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-300x194.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-1024x662.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-768x497.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-65x42.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-225x146.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn-350x226.jpg 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-X5Learn.jpg 1042w" sizes="(max-width: 300px) 100vw, 300px" />一旦提取了原始文本，就可以构建模型。文档将成为高维空间中的向量，通过比较这些向量，我们可以回答诸如以下问题：哪十份文档与这份文档最相似？哪五份文档与这个关键词最匹配？<a class="inline wrap" href="https://www.ai4t.eu/book/ai-for-teachers-an-open-textbook/media/X5Learn.jpg" data-align="left" data-annotations="" data-size="small" data-caption="title-and-description" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://www.ai4t.eu/book/ai-for-teachers-an-open-textbook/media/X5Learn.jpg"></a></p>
         <p class="indent">通过训练可以获得更丰富的模型，它们可以回答更复杂的问题：</p>
         <ul>
              <li>这门课程有多难？答案可能存在于课程描述或元数据中。元数据是观众看不到的，但应该提供关于文档的信息的数据。更有可能的是，这些信息可以通过自动分析文档来获得。句子的长度、单词的长度以及单词本身，都是针对课程面向哪个年龄段学生的强烈指标。</li>
              <li>我应该在浏览正式课件前看先导课件吗？先导课件是根据现有课件自动创建的。</li>
         </ul>
         <p class="no-indent">课程的质量如何？这对AI来说是一个难题。试图回答它，AI可能会带来更多的坏处而不是好处。然而，能够找出课程中的事实是否正确是有意义的。在假新闻之后，我们会有假课程吗？</p>
         <hr />
         <h3 dir="ltr" style="text-align: left">一些链接</h3>
         <p class="no-indent hanging-indent" dir="ltr">X5-Discover (<a href="https://discovery.x5gon.org/" target="_blank" rel="noopener" data-cke-saved-href="https://discovery.x5gon.org/">https://discovery.x5gon.org/</a>) 是一个搜索引擎。</p>
         <p class="no-indent hanging-indent" dir="ltr">学习平台X5-Learn (<a href="http://x5learn.org/" target="_blank" rel="noopener" data-cke-saved-href="http://x5learn.org/">http://x5learn.org/</a><a href="https://discovery.x5gon.org/" target="_blank" rel="noopener" data-cke-saved-href="https://discovery.x5gon.org/">)</a> 允许选择自己的课件并让AI以最佳顺序组织它。在这种情况下，使用了推荐引擎。</p>
         <p class="no-indent hanging-indent" dir="ltr"><a href="https://platform.x5gon.org/" target="_blank" rel="noopener" data-cke-saved-href="https://platform.x5gon.org/">在这里</a><a href="https://platform.x5gon.org/" target="_blank" rel="noopener" data-cke-saved-href="https://platform.x5gon.org/">可以</a><a href="https://platform.x5gon.org/" target="_blank" rel="noopener" data-cke-saved-href="https://platform.x5gon.org/">找到更多X5-GON工具（开发者API，可安装在Moodle中的版本）</a>。</p>
         <p class="no-indent hanging-indent">X5GON项目由欧盟的Horizon 2020研究与创新计划资助，授予号码761758。</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-does-data-always-have-to-be-labeled" title="数据是否总需要标注？">
         <header>
              <h1 class="chapter-title">数据是否总需要标注？</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <h3 style="text-align: left">数据是否总是需要标记？</h3>
         <p class="no-indent">答案是不一定需要。机器学习算法中，很多都属于监督学习算法或无监督学习算法。</p>
         <p class="indent">例如，当你想要区分照片中的狗、猫或猩猩时，你可以向机器学习模型提供已经标记为狗、猫或猩猩的照片。同样，如果你想为作文打分，可以输入许多已批改并标记了分数的作文。在这些情况下，我们都知道预期的输出结果是什么：比如狗、猫、猩猩或者分数等级A+、A、A-、D&#8230;</p>
         <p class="indent">在训练过程中，如果提供了标记数据，算法会尝试找到一个函数或数学模型，将输入与预期的输出相匹配。这通常意味着程序员会试验不同的算法，以找到最佳的匹配函数。标记数据在这个过程中起到了监督或指导的作用，确保算法所选的函数是有效的<sup>1</sup>。如果函数的输出与标记数据不符，算法就需要寻找更好的匹配方式。</p>
         <p class="indent">然而，标记数据是一个既耗时又昂贵的过程，往往需要雇佣人力来完成。如果我们只是希望从数据中发掘出某种模式，但又不清楚具体会找到什么样的模式，那么我们就无法事先为数据打上标签。这时，无监督学习算法就派上了用场。</p>
         <p class="indent">无监督学习算法不是试图将输入与预期的输出相匹配，而是努力在数据中寻找规律，以便将输入数据自动分组到不同的类别中<sup>1</sup>。例如，银行会利用无监督机器学习来检测信用卡交易中的欺诈行为。由于每分钟都有大量的交易发生，而且我们不可能手动检测每个交易并标记为欺诈行为，因此，我们依赖机器学习算法自动发现这些欺诈行为的模式。同样，将学生按照一定数量进行分组，或者在网络中的活动流数据中找出恐怖主义活动，也是无监督学习能够解决的问题。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Kelleher, J.D, Tierney, B, <em>Data Science</em>, London, 2018.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-how-many-features-are-too-many" title="多少特征才算太多？">
         <header>
              <h1 class="chapter-title">多少特征才算太多？</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p><a href="https://www.bilibili.com/video/BV1b1421y7aQ/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 过度拟合 (Overfitting)</a></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-hands-on-machine-learning" title="动手实践机器学习">
         <header>
              <h1 class="chapter-title">动手实践机器学习</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="indent no-indent">本活动改编自 Codeweek 创建的活动，它遵循了<a href="https://creativecommons.org/licenses/by-nc-sa/4.0/deed.zh" target="_blank" rel="noopener" data-cke-saved-href="https://creativecommons.org/licenses/by-nc-sa/4.0/deed.zh">Creative Commons Attribution-NonCommercial-ShareAlike 4.0 国际许可证</a>授权。您可以在他们的<a href="https://codeweek.eu/training/introduction-to-artificial-intelligence-in-the-classroom" target="_blank" rel="noopener" data-cke-saved-href="https://codeweek.eu/training/introduction-to-artificial-intelligence-in-the-classroom">网站上找到原始活动列表。</a>本活动使用的两个数据集，初始训练数据集和测试数据集，也是由他们创建的。</p>
         <p class="indent">我们将使用<a href="https://teachablemachine.withgoogle.com/train" target="_blank" rel="noopener" data-cke-saved-href="https://teachablemachine.withgoogle.com/train">Google的教学机器(Teachable Machine)</a>来训练机器将图像分类为自行车或摩托车。回顾一下，机器学习应用程序在使用前必须经过训练和测试。我们会收集并整理一些样本图片，这些图片将被用于训练模型，并测试它是否能够正确分类一组示例图片。<img class="aligncenter wp-image-762" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826.png" alt="" width="548" height="261" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826.png 1998w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-300x143.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-1024x488.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-768x366.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-1536x732.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-65x31.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-225x107.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/2.5-1-e1718938469826-350x167.png 350w" sizes="(max-width: 548px) 100vw, 548px" /></p>
         <h3 style="text-align: left">步骤 1: 收集并分组示例图片</h3>
         <p>1.1 下载<a href="https://drive.google.com/drive/folders/1cqDQHXn4SiYsHNOjV3aZpIFf7fArAvwc" target="_blank" rel="noopener" data-cke-saved-href="https://drive.google.com/drive/folders/1cqDQHXn4SiYsHNOjV3aZpIFf7fArAvwc">这里找到的</a>自行车图片。</p>
         <p>1.2 如有必要，将zip文件夹内容解压到您电脑上的本地文件夹中。这将用作机器学习应用的训练集。</p>
         <p>1.3 下载<a href="https://drive.google.com/drive/folders/1cqDQHXn4SiYsHNOjV3aZpIFf7fArAvwc" target="_blank" rel="noopener" data-cke-saved-href="https://drive.google.com/drive/folders/1cqDQHXn4SiYsHNOjV3aZpIFf7fArAvwc">这里找到的</a>摩托车图片。</p>
         <p>1.4 如有必要，将zip文件夹内容解压到您电脑上的本地文件夹中。这也将用作机器学习应用的训练集。</p>
         <p>1.5 下载<a href="https://drive.google.com/drive/folders/10VQn2N9P997aUJMhyBWwnvs0KRVpw3Hs" target="_blank" rel="noopener" data-cke-saved-href="https://drive.google.com/drive/folders/10VQn2N9P997aUJMhyBWwnvs0KRVpw3Hs">这里找到的</a>所有图片。</p>
         <p>1.6 如有必要，将zip文件夹内容解压到您电脑上的本地文件夹中。这将用作测试数据集。</p>
         <p>1.7 点击<a href="https://teachablemachine.withgoogle.com/train" target="_blank" rel="noopener" data-cke-saved-href="https://teachablemachine.withgoogle.com/train">Google的教学机器</a>并选择<strong>图像项目</strong> &gt; <strong>标准图像模型。</strong></p>
         <p>1.8 在类别 1 下，点击<strong>上传 &gt; 从您的文件中选择图片 &gt; </strong>打开您在步骤 1 和 2 中创建的自行车图片文件夹，并导入此处存储的所有图片。</p>
         <p>1.9 在类别 2 下，点击<strong>上传 &gt; 从您的文件中选择图片 &gt; </strong>打开您在步骤 3 和 4 中创建的摩托车图片文件夹，并导入此处存储的所有图片。</p>
         <h3 style="text-align: left">步骤 2: 训练模型</h3>
         <p class="no-indent">完成图片上传后，点击<strong>训练模型</strong>按钮。这时，模型就会开始学习如何区分自行车和摩托车。耐心等待，直到显示<strong>模型已训练完成</strong>。</p>
         <p class="indent">注意，我们不必手动选择和输入自行车和摩托车的特征。算法会自动从图片中学习和识别这些特征。<a class="inline" href="https://www.ai4t.eu/book/ai-for-teachers-an-open-textbook/media/teachable%20machine.PNG" data-align="center" data-annotations="" data-size="large" data-caption="description" data-cke-saved-name="scalar-inline-media" data-cke-saved-href="https://www.ai4t.eu/book/ai-for-teachers-an-open-textbook/media/teachable%20machine.PNG"></a></p>
         <figure id="attachment_176" aria-describedby="caption-attachment-176" style="width: 1024px" class="wp-caption aligncenter">
              <img class="wp-image-176 size-large" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-1024x415.png" alt="" width="1024" height="415" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-1024x415.png 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-300x122.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-768x311.png 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-1536x623.png 1536w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-65x26.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-225x91.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine-350x142.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-teachable-machine.png 1892w" sizes="(max-width: 1024px) 100vw, 1024px" />
              <figcaption id="caption-attachment-176" class="wp-caption-text">来源：谷歌的教学机器</figcaption>
         </figure>
         <h3 style="text-align: left">步骤 3: 测试模型</h3>
         <p>3.1 在<strong>预览</strong>界面，点击靠近<strong>网络摄像头</strong>的箭头并更改输入为<strong>文件。</strong></p>
         <p>3.2 点击<strong>从您的文件中选择图片</strong>并选择您在 1.5 和 1.6 中存储的测试图片。</p>
         <p>3.3 向下滚动并查看输出结果。</p>
         <p>3.4 您可以多次尝试不同的测试图片，以评估模型的性能。</p>
         <p class="no-indent">如果一张图片被用来训练分类器，机器已经记录了该图片的相应标签。在测试阶段将这张图片展示给机器无法衡量模型的泛化能力。这就是为什么您的测试数据集和训练数据集应该彼此不同。</p>
         <p class="no-indent"><strong>注意</strong>：您也可以上传自己的图片进行训练和测试。<a href="https://wordpress.org/openverse/?referrer=creativecommons.org" target="_blank" rel="noopener" data-cke-saved-href="https://wordpress.org/openverse/?referrer=creativecommons.org">这里</a>是一个不错的免费图片资源。</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-cookies-and-fingerprinting" title="Cookie 和指纹识别">
         <header>
              <h1 class="chapter-title">Cookie 和指纹识别</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <div class="mceTemp">
              <figure id="attachment_178" aria-describedby="caption-attachment-178" style="width: 322px" class="wp-caption alignleft">
                   <img class="wp-image-178" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie-300x151.png" alt="" width="322" height="162" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie-300x151.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie-65x33.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie-225x114.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie-350x177.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chaddhttpcookie.png 408w" sizes="(max-width: 322px) 100vw, 322px" />
                   <figcaption id="caption-attachment-178" class="wp-caption-text">HTTP Cookie由Harmil 遵循 CC BY SA 许可证授权。查看此许可证，请访问 <a href="https://creativecommons.org/licenses/by-sa/2.0/">https://creativecommons.org/licenses/by-sa/2.0/</a></figcaption>
              </figure>
              <p class="no-indent">Cookies是保存在您电脑里的小文件，它们能告诉浏览器用户的身份，比如您在该网站的用户号是 #745673，以及您喜欢哪些内容。这些 cookies 的设计初衷是，每次我们访问同一个网站时，就不必重新设置语言、地点等偏好，不必担心购物车里的物品丢失，也不必重新填写表单。在cookies技术刚出现的时候，我们完全能够控制它们收集哪些数据<sup>1,2</sup>。</p>
              <p class="indent">后来，公司意识到他们可以使用 cookie 数据来分析我们的点击和购买喜好。于是，广告投放不再只是依据当前页面的内容，而是根据我们的个人喜好（行为定向）<sup>1</sup>。再后来，公司开始在其他公司的网站上设置自己的cookies，以便更深入地追踪用户行为。这些第三方cookies需要向网站支付费用才能使用。这就是为什么广告会跨网站追踪我们的原因。</p>
              <p class="indent">此外，通过使用电子邮件 ID 或信用卡号等，这些公司可以将不同的识别号码链接到单个用户，以更好地了解他们的行为。这称为 <em>cookie 同步</em>。用户当然无法知道哪些数据被收集以构建他们的行为画像。</p>
              <p class="indent">除此之外，更糟糕的是机器学习算法开始被用来分析用户的数据，然后给用户打上诸如男性、女性、黑人、欧洲人，甚至是“易患抑郁症”的标签<sup>1</sup>。这些标签与我们的身份无关，而是与我们自己的先前用户行为最相似的行为类型有关。这些标签被卖给出售产品、房屋和工作机会的公司。因此，同一网页上，不同行为模式的用户可能会看到完全不同的广告。这反过来可以影响我们申请什么类型的工作，以及我们在哪个社区购买房屋，进而决定我们的孩子上哪所学校<sup>3</sup>。</p>
              <p class="indent">现在，大多数互联网浏览器都内置了cookie技术。一项2016年的研究发现，大多数第三方都在进行 cookie 同步。“在前50名中有45个，前100名中有85个，前200名中有157个，前1000名中有460个”第三方从不同来源同步 cookies 以收集用户信息<sup>4</sup>。有研究表明，例如Google这样的公司能追踪到用户在80%的网站上的行为<sup>5</sup>，这无疑对我们的隐私和自主权构成了威胁，并加强了网络监视和监控<sup>6</sup>。</p>
              <p class="indent">当这些结果被公布时，引起了公众的强烈抗议。于是，像DoNotTrackMe这样的阻止cookie的浏览器插件开始流行起来。互联网浏览器也开始提供阻止或删除cookie的功能<sup>2</sup>。像苹果和谷歌这样的公司甚至停止或承诺禁止第三方 cookies<sup>1</sup>。在线定位从 cookies 转移到更持久的跟踪技术。</p>
              <p class="indent">例如，可以使用 Adobe 的 Flash 播放器存储类似于 cookie 的文件，这些文件在删除其他cookie后依然存在。当然，通过安装FlashBlock这样的应用程序来阻止它们<sup>2</sup>。然而，现在的跟踪技术更是配备了更先进的工具，比如各种类型的指纹跟踪，这些工具甚至能够躲过大多数阻止工具的侦查<sup>4</sup>。</p>
              <figure aria-describedby="caption-attachment-178" style="width: 300px" class="wp-caption alignleft">
                   <img class="size-full wp-image-250" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/chadd-fingerprint.jpg" alt="" width="300" height="168" />
                   <figcaption class="wp-caption-text">“指纹扫描”由Daniel Aleksandersen 遵循 CCo I.0. 许可证授权。查看此许可证，请访问 <a href="https://creativecommons.org/publicdomain/zero/1.0/deed.en">https://creativecommons.org/publicdomain/zero/1.0/deed.en</a></figcaption>
              </figure>
              <p class="no-indent">这个理念在于，我们的设备和服务，比如电脑、手机和音响，在处理数据和输出结果时，会与其他用户的设备存在细微差异。这些差异可以作为我们独特的“指纹”，特别是在将这些不同技术结合起来以构建我们的在线身份<sup>4</sup>。我们设备的 IP 地址、以太网或 Wifi 地址（基于 WebRTC 的指纹识别）、硬件和软件播放音频文件的方式（AudioContext 指纹识别）甚至电池信息，都可以作为我们的长期和短期标识符，使在线追踪得以持续进行<sup>7,</sup><sup>4</sup>。</p>
              <p>&nbsp;</p>
              <hr />
              <p class="hanging-indent"><sup>1</sup> Kant, T., <em>Identity, Advertising, and Algorithmic Targeting: Or How (Not) to Target Your “Ideal User”,</em> MIT Case Studies in Social and Ethical Responsibilities of Computing, 2021.</p>
              <p class="hanging-indent"><sup>2</sup> Schneier, B., <em>Data and Goliath : the Hidden Battles to Collect Your Data and Control Your World, W.W. Norton &amp; Company, </em>New York, 2015.</p>
              <p class="hanging-indent"><sup>3 </sup>Barocas, S.,  Hardt, M., Narayanan, A., <em><a href="https://fairmlbook.org/" target="_blank" rel="noopener">Fairness and machine learning Limitations and Opportunities</a>, </em>2022.</p>
              <p class="hanging-indent"><sup>4 </sup>Englehardt, S., Narayanan, A., <em><a href="https://webtransparency.cs.princeton.edu/webcensus/" target="_blank" rel="noopener">Online Tracking: A 1-million-site Measurement and Analysis</a></em>, Extended version of paper, ACM CCS, 2016.</p>
              <p class="hanging-indent"><sup>5 </sup>Libert, T., <a href="https://ijoc.org/index.php/ijoc/article/view/3646" target="_blank" rel="noopener"><em>Exposing the Invisible Web: An Analysis of Third-Party HTTP Requests on 1 Million Websites</em></a>, International Journal of Communication, v. 9, p. 18, Oct. 2015.</p>
              <p class="hanging-indent"><sup>6 </sup>Tavani, H., Zimmer, M., <em><a href="https://plato.stanford.edu/archives/fall2020/entries/ethics-search/">Search Engines and Ethics</a></em>, The Stanford Encyclopedia of Philosophy, Fall 2020 Edition, Edward N. Zalta (ed.).</p>
              <p class="hanging-indent"><sup>7 </sup>Olejnik, L., Acar, G., Castelluccia, C., Diaz, C., <em>The leaking battery</em>, Cryptology ePrint Archive, Report 2015/616, 2015.</p>
         </div>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-more-on-big-data" title="关于大数据的更多信息">
         <header>
              <h1 class="chapter-title">关于大数据的更多信息</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">通俗来讲，保存下来的各种类型的数据被称为大数据<sup>1</sup>。由于数据存储成本降低，同时随着强大的处理器和算法（特别是自然语言处理和机器学习）的出现，分析大数据变得更加容易<sup>2</sup>，因此这种做法是非常有意义的。</p>
         <p><a href="https://www.bilibili.com/video/BV1xZ421p7c1/?share_source=copy_web&amp;vd_source=92215961f10bf13779b8ac76fad9760f">[AI4T] 数据：其形状和大小多种多样 (Data: it comes in many shapes and sizes (2/2)</a></p>
         <p>&nbsp;</p>
         <p class="indent no-indent">正如视频中所讨论的，大数据具有数据量大（<strong>体量</strong>）、生成迅速（<strong>速度</strong>）、不同类型（<strong>多样性</strong>）等特点，数据来自多个源头。因此获得的数据往往是不完整和不精确的（<strong>真实性</strong>），其相关性随时间变化（<strong>波动性</strong>）。需要复杂的算法来整合、处理和可视化这类数据。然而，从这些数据中得出的推论，特别是与传统数据结合时，可以非常有力，因此这些努力都是值得的<sup>2</sup>。</p>
         <p class="indent">一些专家扩展了三个或五个“V”<sup>2</sup>，强调构成大数据的三个核心维度：</p>
         <ul>
              <li>技术使得收集、分析、链接和比较大型数据集成为可能。分析旨在识别大数据集中的模式，从而提出经济、社会、技术和法律方面的主张。</li>
              <li>“大数据集提供一种更高形式的智能和知识，产生之前无法获得的见解，并带有真实、客观和准确的光环”<sup>3</sup>。</li>
              <li>大数据分析“可能揭示出学生在学习中的挑战和优势，理解学生的个体需求，从而制定出个性化的学习策略。”</li>
         </ul>
         <p class="indent"><img class="aligncenter wp-image-914" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/8.1-e1718938576827.png" alt="" width="317" height="564" /></p>
         <hr />
         <p class="hanging-indent"><sup>1</sup> Schneier, B., Data and Goliath: <em>The Hidden Battles to Capture Your Data and Control Your World</em>, W. W. Norton &amp; Company, 2015.</p>
         <p class="hanging-indent"><sup>2</sup> Kelleher, J.D, Tierney, B, <em>Data Science</em>, London, 2018.</p>
         <p class="hanging-indent"><sup>3</sup> D’Ignazio, C., Bhargava, R., <em>Approaches to Building Big Data Literacy</em>, Bloomberg Data for Good Exchange, New York, 2015.</p>
         <p class="hanging-indent"><sup>4</sup> General Data Protection Regulation (GDPR), European Union, April 2016.</p>
         <p class="hanging-indent"><sup>5</sup> Ethical guidelines on the use of artificial intelligence and data in teaching and learning for educators, European Commission, October 2022.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-other-terms-related-to-personalised-learning" title="与个性化学习相关的其他术语">
         <header>
              <h1 class="chapter-title">与个性化学习相关的其他术语</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <h3 style="text-align: left">在讨论个性化学习时，常用的一些学习和教学类型：</h3>
         <p><img class="alignnone wp-image-904" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052.jpg" alt="" width="553" height="464" data-wp-editing="1" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052.jpg 1287w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-300x252.jpg 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-1024x859.jpg 1024w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-768x644.jpg 768w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-65x55.jpg 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-225x189.jpg 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/微信截图_20240617103052-350x294.jpg 350w" sizes="(max-width: 553px) 100vw, 553px" /></p>
         <p>推广材料和媒体中使用的个性化学习术语，由Bulger M., <em>Personalised Learning: The Conversations We’re Not Having</em>, Data &amp; Society Working Paper, 2016遵循CC BY-NC-SA 4.0 许可证授权。</p>
         <h3 style="text-align: left">混合式学习</h3>
         <p class="no-indent">这是将面对面授课与在线学习有机结合的教学方式。教师既可以为在线学习准备内容，也可以使用 Kahn Academy 这样的内容提供商的资源。混合学习通常涉及使用学习管理系统，如 Moodle 或 Google Classroom，将两种学习方式融为一体，辅助跟踪学生的学习进度<sup>1</sup>。</p>
         <h3 style="text-align: left">基于能力的学习</h3>
         <p class="no-indent">内容、技能和态度，这些都可以被视作学生需要掌握的能力。在基于能力的学习中，学生一旦掌握了一项能力，就可以进入下一阶段的学习。如果他们遇到困难，会得到及时的帮助<sup>1,2</sup>。</p>
         <p class="indent">基于能力的学习与传统模式不同，学生的进步基于学生的年龄和在教室里度过的时间。</p>
         <h3 style="text-align: left">差异化教学</h3>
         <p class="no-indent">&#8220;差异化教学是要认识到学生们不同的背景知识、准备程度、语言能力、学习偏好和兴趣，并据此灵活调整教学方法&#8221;<sup>3</sup>。与个性化学习不同，差异化教学并非完全由学生主导，而是有一个共同的学习目标——唯一的差异在教学方法上。例如，在学习新单词时，一些学生可能会被要求找到包含这些单词的报纸剪报；其他人可能会被要求学习一首歌。</p>
         <h3 style="text-align: left">翻转课堂</h3>
         <p class="no-indent">这种方式将课堂作业和家庭作业调换。学生在家中通过观看在线课程或讲座自主学习，而教师则在课堂上指导学生进行实践操作或完成具体项目<sup>2</sup>。</p>
         <h3 style="text-align: left">个性化学习</h3>
         <p class="no-indent">个性化学习关注学生的学习进度<sup>4</sup>。当学生遇到学习困难时，他们可以选择花更多时间来巩固所学内容；而当他们感到自信时，则可以加速学习进度，探索更多内容，避免无聊和枯燥。</p>
         <h3 style="text-align: left">基于问题的学习和基于项目的学习</h3>
         <p class="no-indent indent">学生通过解决问题或做一个项目来学习，这些问题或项目可能是个性化的，也可能不是，而教师则充当他们的促进者或指导者。</p>
         <p>&nbsp;</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Groff, J., <em>Personalized Learning: The State of the Field &amp; Future Directions</em>, Center for Curriculum Redesign, 2017.</p>
         <p class="hanging-indent"><sup>2</sup> Holmes, W., Anastopoulou S., Schaumburg, H &amp; Mavrikis, M.<em>, Technology-enhanced personalised learning: untangling the evidence,</em> Stuttgart: Robert Bosch Stiftung, 2018.</p>
         <p class="hanging-indent"><sup>3</sup> Hall, T., Vue, G., Strangman, N., &amp; Meyer, A., <a href="https://sde.ok.gov/sites/ok.gov.sde/files/DI_UDL.pdf" target="_blank" rel="noopener" data-cke-saved-href="http://www.cast.org/products-services/resources/2003/ncac-differentiated-instruction-udl">Differentiated instruction and implications for UDL implementation</a>, Wakefield, MA: National Center on Accessing the General Curriculum, 2003.</p>
         <p class="hanging-indent">4 Michell, M., <em><a href="https://blog.edmentum.com/personalized-individualized-and-differentiated-learning-simple-math-equation" target="_blank" rel="noopener" data-cke-saved-href="https://blog.edmentum.com/personalized-individualized-and-differentiated-learning-simple-math-equation">Personalized, Individualized, and Differentiated Learning: A Simple Math Equation</a></em>, 2016.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-technology-is-moving-fast" title="AI技术发展迅速">
         <header>
              <h1 class="chapter-title">AI技术发展迅速</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p>教育中的自动翻译是一个由于技术发展速度之快而使得分析变得困难的领域。那些超过五年的研究，分析的可能都是已经过时的技术。例如，它可能会坚持认为自动翻译工具不起作用，并会报告一些不再有效的故障示例。很快，这可能也会发生在人工智能作为主要参与者的其他领域。</p>
         <p>这有各种后果，包括：</p>
         <ol>
              <li>研究将会变得困难。研究工作通常需要建立在已有成果的基础上，以避免重复发现已知事实。然而，在这个领域，我们原本希望依赖的坚实基础可能会迅速变得过时。</li>
              <li>教师们需要找到保持信息更新的方法，因为这些技术的非线性进步可能难以跟进。应该设想帮助教师使用这项技术的工具，而不是仅仅依赖社交媒体上的观点。</li>
         </ol>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-some-automatic-translation-vocabulary" title="一些自动翻译相关的词汇">
         <header>
              <h1 class="chapter-title">一些自动翻译相关的词汇</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">本章使用了许多技术术语。<a href="ai-speak--image-and-speech-recognition" data-cke-saved-href="ai-speak--image-and-speech-recognition">AI Speak页面</a>提供了关于术语的一些细节以及自然语言处理的历史。</p>
         <p class="indent">从更广泛的角度来看，可以在线访问<strong>自动翻译工具</strong>，并且可以通过多种方式使用：</p>
         <ul>
              <li>直接通过复制粘贴一种语言的文本片段并获得另一种语言的相同文本；</li>
              <li>通过向网站提交一些预定义格式的文件。整个文件将被翻译，保留文件的结构和格式；</li>
              <li>通过APIs（<em>应用程序编程接口，</em>是程序员可以在其软件中使用的代码片段，用来辅助翻译工具的使用）。</li>
         </ul>
         <p class="no-indent"><strong>自动转录</strong>也利用了人工智能。无论是在线还是离线视频、音频录制，都可以进行自动转录。一些视频会议平台甚至可以通过自动转录获取字幕，从而提高内容的可访问性/帮助理解其他语言的内容。</p>
         <p class="no-indent"><strong>语音合成技术</strong>可以将文本和语音模型结合,使用该语音模型来朗读文本。语音模型可以是标准的,也可以专门训练以模仿特定的人的声音。</p>
         <p class="no-indent"><strong>文本生成</strong>工具则利用人工智能生成新的文本内容。这些新文本可能是基于已有的文本进行摘要、简化或重新表述得到的，也可能是基于对话模型生成的，其中AI会根据某个特定主题进行回应。</p>
         <p class="indent">这些技术可以单独使用或组合使用，以便实现流畅的多语言对话。</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-understanding-the-debates-about-the-possible-dangers-of-ai" title="理解关于人工智能潜在危险的争论">
         <header>
              <h1 class="chapter-title">理解关于人工智能潜在危险的争论</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">在2023年的3月<sup>1</sup>和5月<sup>2</sup>，两封请愿信/公开信被发布，警告人们注意AI可能带来的某些风险。这些信件得到了数百位来自行业的知名科学家和AI专家的签署。那么，我们应该知道些什么呢？</p>
         <h3 style="text-align: left">这对教师来说是一个有趣的问题吗？</h3>
         <p class="no-indent">对于年龄稍大一些的学生来说，AI对文明的风险这一问题可能会浮现出来。虽然教师不必对每个问题都给出明确的答案，但了解这场争议的大致情况还是十分必要的。</p>
         <h3 style="text-align: left">作为教师，是否应该只讲解技术方面的内容，而将人类、经济和哲学问题留给专家？</h3>
         <p class="no-indent">这是一个有趣的问题，人们对此意见不一。</p>
         <p class="indent">物理教师应该知道广岛或切尔诺贝利吗？这些问题的讨论应该在课堂上进行吗？同理，在AI方面，教师是否应该只关注如何安全地使用某些软件，并大致了解它们的工作原理？还是应该更深入地去理解关于AI的各种讨论和争议呢？</p>
         <p class="indent">联合国教科文组织和其他专家都认为，AI不应该只被当作一项技术来看待，教师更应该理解其中涉及的伦理问题。这些问题包括对AI可能给社会、文明和人类带来的影响的担忧。</p>
         <h3 style="text-align: left">这些是新问题吗？</h3>
         <p>关于人工智能的危险性的一些问题已经存在了一段时间。特别是当AI的智力“超越”人类时，会发生什么，这个问题已经讨论了很长时间。早在1965年，艾伦·图灵(Alan Turing)的前同事欧文·古德(Irving Good)<sup>4</sup>就提出了“技术奇点”的概念。他认为，一旦AI被认为比人类更聪明或拥有超级智能，那么它将变得无法控制。Good甚至为艾伦·库布里克(Alan Kubrick)的电影《2001太空漫游》提供了建议，这是一部以人工智能失控为特色的电影。</p>
         <h3 style="text-align: left">各种立场</h3>
         <p>3月公开信<sup>1</sup>提出警告，人工智能既能做好事也能做坏事，对社会和就业的影响可能是巨大的。信中提到，人工智能不仅会取代那些枯燥或不受欢迎的工作，还可能取代人们愿意从事的“好”工作。更令人担忧的是，在AI技术的发展和应用中，存在一些快速的变化或决策过程，这些过程可能没有通过传统的民主渠道进行充分的讨论和审议。</p>
         <p>在第二篇公开信<sup>2</sup>中，讨论的新增风险是人工智能失控（或此类情景的变式）和人类文明的潜在终结。</p>
         <p>在这场辩论中，还出现了第三种立场<sup>3</sup>——人工智能确实令人担忧，但人们不应仅因存在性威胁而过度恐慌，因为这可能掩盖了更紧迫的问题。</p>
         <h3 style="text-align: left">辩论结束了吗？</h3>
         <p class="no-indent">不，辩论还没有结束。一些科学家认为仍存在许多风险，技术发展迅猛，需要尽快进行监管。而另一些人则认为，目前人工智能带来更多的是好处，我们应该保持警惕，但不必过于害怕。</p>
         <p class="indent">关于这场辩论，谁胜谁负、谁对谁错，目前还难以定论。它让人不禁回想起1945年后关于物理学的那场大辩论。</p>
         <p class="indent">目前，一个普遍的共识是需要加强监管，尽管具体如何监管仍存在分歧。</p>
         <h3 style="text-align: left">能否找到一个合理的立场？</h3>
         <p class="no-indent">实际上，两种立场可能都是合理的。当前的事实似乎支持乐观派（人工智能正在医学、农业、气候分析、语言和通信方面推动进步）的观点，但我们作为人类总能发现论点中存在严重的局限。</p>
         <h3 style="text-align: left">如何进一步了解更多关于这场辩论的信息？</h3>
         <p class="no-indent">对于一个思想开放的人（或教师）来说，有许多潜在的信息来源，如博客、权威的网站以及所有顶尖科学家、包括历史学家和哲学家发表的论文和视频。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1</sup> <a href="https://futureoflife.org/open-letter/pause-giant-ai-experiments/" target="_blank" rel="noopener">https://futureoflife.org/open-letter/pause-giant-ai-experiments/</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>2</sup> <a href="https://www.safe.ai/statement-on-ai-risk#open-letter" target="_blank" rel="noopener">https://www.safe.ai/statement-on-ai-risk#open-letter</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>3</sup> <a href="https://theconversation.com/lets-focus-on-ais-tangible-risks-rather-than-speculating-about-its-potential-to-pose-an-existential-threat-207842" target="_blank" rel="noopener">https://theconversation.com/lets-focus-on-ais-tangible-risks-rather-than-speculating-about-its-potential-to-pose-an-existential-threat-207842</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>4</sup> <a href="https://www.historyofinformation.com/detail.php?id=2142" target="_blank" rel="noopener">https://www.historyofinformation.com/detail.php?id=2142</a></p>
         <p class="hanging-indent" style="text-align: left"><sup>5</sup> <a href="https://en.wikipedia.org/wiki/I._J._Good" target="_blank" rel="noopener">https://en.wikipedia.org/wiki/I._J._Good</a></p>
         <p class="hanging-indent"></p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-generative-ais-where-should-a-teacher-use-them" title="生成式AI - 教师应该在哪里使用它们？">
         <header>
              <h1 class="chapter-title">生成式AI - 教师应该在哪里使用它们？</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">生成式AI可以用来设计课堂内外各种有趣的活动，它们可能在教育中发挥作用，并且在某些情况下已经发挥了作用。但是，生成式AI到底在教育中扮演了什么角色？教师又该如何引导学生参与？在什么情况下使用它最合适呢？我们主张，目前教师可以并应该限制生成式AI的使用范围，主要将其应用于课外活动中。</p>
         <h3 style="text-align: left">“目前”</h3>
         <p class="no-indent">事情的发展速度惊人。就在2022年10月，这本教科书的初版问世时，ChatGPT都还未出现。然而，仅仅一年后，网上已经出现了许多提供生成式AI教育工具的平台。科技进步的速度如此之快，以至于此刻（2023年11月）看来合理的东西，可能几个月后就不再适用。或许我们目前看到的某些缺陷将来会被修正。或许教师们会接受足够的培训来克服这些缺陷。或许学校或国家教育部门将提供关于可以或应该做什么的指导。保持了解最新信息是至关重要的。</p>
         <h3 style="text-align: left">“政策问题”</h3>
         <p class="no-indent">AI为各部门提出了严峻的挑战。一方面，我们希望以能够让学生适应未来世界的方式教育他们。毕竟，考虑到就业市场将受到的影响，尽早对学生进行教育是合理甚至必要的。但另一方面，使用尚未证明其稳定性的技术可能会带来风险。这种风险在隐私问题上尤为突出<sup>2</sup>。目前，它们对学习的影响仍然相当不清晰<sup>3</sup>。</p>
         <p class="indent">工业界积极推广其产品，而家长们则关注着相互矛盾的信息，比如重视基础知识的教学（如阅读、写作、算术）与掌握与工作相关的技能之间的平衡。这种分歧使政策制定者面临更加复杂的任务。</p>
         <p class="indent">制定决策可能需要时间，但当这些决策出台时，教师们会希望理解其背后的原因和意义。</p>
         <h3 style="text-align: left">关于“安全环境”</h3>
         <p class="no-indent">在使用生成式AI的过程中，会交换大量数据。教师和学生可能会很容易地泄露数据，这些数据很快就能成为指向个人身份的信息。如果缺乏适当的措施，这些数据可能会直接关联到每个人。尽管GDPR保护个人隐私，但目前尚不清楚这些法律是否足够应对新出现的挑战。一些国家已经引入了以匿名化处理数据为规则的安全校园环境。在这种环境中，与个体用户相关的在线活动不会在学校服务器之外被记录。</p>
         <p class="indent">数据安全问题层出不穷，教师很难确保自己和学生的权益不受侵犯。他们可能会思考：这些数据会保存多久？会被用于什么目的？由谁来使用？在涉及学生数据时，教师是否有权代表学生做决策？由于这些问题极为复杂，因此，在未经相关机构进行必要审查的情况下，将学生在外部平台随意注册并不是一个明智之举。</p>
         <h3 style="text-align: left">课外活动</h3>
         <p>人们已经可以发现许多教师可以在家或办公室与生成式AI一起参与的活动例子，而无需学生参与。这些活动包括准备课堂活动、编写试题、搜索信息和探索下一堂课的主题等。普遍观点认为，在这些场景下，AI有助于我们更好地探索新知、发现新点子，并以更出色的方式展示材料。虽然AI也存在一些问题（如缺乏参考文献、幻觉、偏见等），但总体上看来是积极的。</p>
         <p class="indent">最重要的是，教师报告说他们节省了时间。这一次，技术不仅仅是承诺做得更好，而是以更少的努力做得更好。</p>
         <h3 style="text-align: left">支持课堂内活动的论点。</h3>
         <p class="no-indent">如果生成式AI在未来将扮演举足轻重的角色，而合理利用AI也将成为就业市场上的一项必备技能，那么学生无疑应该在老师的指导下学习如何正确使用这些技术。这确实会涉及AI的技术和伦理方面。</p>
         <p class="indent">如今与学生谈论这些技术既有回报又令人担忧。一方面，他们已经是AI用户，但他们有着强烈的误解，尤其是在对AI的信任方面。</p>
         <h3 style="text-align: left">反对课堂内活动的论点。</h3>
         <p class="no-indent">另一方面，任何尝试过这些AI工具的人都会明白，它们的输出是如此不可预测，用它们来教学真是难上加难。你用相同的提示运行生成式AI三次，可能会得到三个截然不同的结果。这虽然是这项技术的一大优势，但也可能让缺乏经验的教师（甚至是有经验的教师！）陷入尴尬的境地。想象一下，化学老师让学生们做同一个实验，结果有的学生那里发出巨响，有的冒出红烟，还有的闻到奇怪的气味。</p>
         <p class="indent">给学生们解释清楚这种现象，甚至给每个学生单独解释，都会变得既有趣又充满挑战。</p>
         <h3 style="text-align: left">所以……</h3>
         <p class="no-indent">从这一点上来说，教师在课堂外安全地测试生成式AI是很有必要的。这有助于他们更好地了解AI的工作原理，发现学生可能发现的事物，以便更好地备课。对生成式AI保持清醒的认识至关重要。此外，越来越多的教师通过经验证明，使用这项技术确实能让他们节省时间。</p>
         <p class="indent">另一方面，在许多情况下，直接与学生使用这些技术仍然是一个好主意。</p>
         <h3 style="text-align: left">那么我们如何帮助学生理解呢？</h3>
         <p class="no-indent">同样，这必须符合国家或学校设定的相关指导和规定。</p>
         <p class="indent">在允许的范围内，教师可以采取的第一个策略是与学生进行互动讨论，也许通过问他们什么是作弊和不作弊？讨论这个话题将帮助学生理解问题的复杂性。</p>
         <p class="indent">第二个建议是，教师可以在课堂上试用生成式AI，但最好不要用于复杂或学生不熟悉的主题。尽管这听起来有些违反直觉，但向学生展示一个人并不总是知道所有答案，这其实也是很有帮助的。甚至在学生相对擅长的主题上尝试使用生成式AI也很有价值——他们可能会发现其中的错误，并意识到AI并非总是正确无误！</p>
         <p class="indent">发现错误对学生来说可能是有趣的。对于教师来说，通过生成式人工智能产生的事实进行挑战并即时发现错误可能会更加困难。这不是关于对错的问题，教师也是允许犯错误的。但是，以教学的方式去解释这些错误，并不是一件简单的事。</p>
         <hr />
         <p class="hanging-indent"><sup>1 </sup>Generative AI likely to augment rather than destroy jobs. ILO report, August 2022 <a href="https://www.ilo.org/global/about-the-ilo/newsroom/news/WCMS_890740/lang--en/index.htm">https://www.ilo.org/global/about-the-ilo/newsroom/news/WCMS_890740/lang–en/index.htm</a></p>
         <p class="hanging-indent"><sup>2 </sup>After Italy blocked access to OpenAI’s ChatGPT chatbot, will the rest of Europe follow? Euronews, 7/4/2023. <a href="https://www.euronews.com/next/2023/04/07/after-italy-blocked-access-to-openais-chatgpt-chatbot-will-the-rest-of-europe-follow">https://www.euronews.com/next/2023/04/07/after-italy-blocked-access-to-openais-chatgpt-chatbot-will-the-rest-of-europe-follow</a></p>
         <p class="hanging-indent"><sup>3 </sup>Holmes, W., Miao, F., <em>Guidance for generative AI in education and research</em>, Unesco, Paris, 2023.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-transformers" title="变换器网络（Transformer）">
         <header>
              <h1 class="chapter-title">变换器网络（Transformer）</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <h2 class="chapter-author">Fabrizio Falchi 和 Manuel Gentile</h2>
         <p class="no-indent">Transformer是一种神经网络模型，旨在解决循环神经网络在分析数据序列（例如单词或词元）时遇到的限制<sup>1</sup>。具体来说，Transformer 模型采用了“自注意力”机制，使得可以并行地分析数据序列，同时提取这些序列中元素与其上下文之间的依赖关系。</p>
         <hr />
         <p class="hanging-indent" style="text-align: left"><sup>1 </sup>Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., … &amp; Polosukhin, I., <em>Attention is all you need</em>, Advances in neural information processing systems, 30, 2017.</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-gdpr-in-a-nutshell" title="《通用数据保护条例》（GDPR）简述">
         <header>
              <h1 class="chapter-title">《通用数据保护条例》（GDPR）简述</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">《通用数据保护条例》（GDPR），自2018年5月25日起生效，它要求公司必须制定严格的流程来处理和存储个人信息，从而保护每个人的数据安全。</p>
         <p class="indent">GDPR基于七大原则，确保公民的权利得到保障，同时规定了平台的义务。</p>
         <p class="indent">GDPR的七大原则是：合法性、公平性、透明性、目的限制、数据最小化、准确性、存储限制、完整性、保密性（安全性）问责制。在以上的背景中，特别需要关注一些权利和义务：</p>
         <ul>
              <li><strong>知情权</strong>要求平台必须告知公民其数据的使用情况；</li>
              <li><strong>删除权</strong>允许公民要求平台删除其被收集的数据（该数据集可能被出售给他人）；</li>
              <li><strong>访问权</strong>意味着公民可以（轻松地）了解自己哪些数据正在被收集。</li>
         </ul>
         <p class="no-indent">虽然GDPR在AI和教育领域的核心问题突显之前就已经制定，但这个框架并没有解决关于数据的很多问题。考虑到数据是人工智能技术发展的助燃剂，因此GDPR对于AI和教育领域具有特殊的意义。</p>
         <p class="no-indent">     与其我们自己尝试用简单易懂的语言来解释GDPR的内容和教师应该了解的内容，不如推荐一个已经为我们完成了这项工作的网站。</p>
         <p class="indent">这个网站的名称是<a href="https://www.liberties.eu/en/stories/gdpr-for-dummies/44076" target="_blank" rel="noopener" data-cke-saved-href="https://www.liberties.eu/en/stories/gdpr-for-dummies/44076">《GDPR傻瓜指南》</a>，虽然名字听起来可能有些冒犯（教师可不是傻瓜），但它是欧洲公民自由联盟（Liberties）的独立专家所编写的。Liberties是一个致力于保护欧盟每个人人权的监督机构，所以这个分析值得我们信赖。</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-ai-and-coding" title="人工智能与编程">
         <header>
              <h1 class="chapter-title">人工智能与编程</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <p class="no-indent">编写计算机代码与编写其他语言类似，需要遵循语法规则，确保程序具有意义且能按预期运行。在2022年，生成式AI开始能够根据提示编写代码；ChatGPT更是直接在界面内提供了这一功能，使得Python或C语言与其他语言如法语、意大利语或日语一样便捷。编写计算机代码就像用任何语言写作一样。</p>
         <p class="indent">很快，一个辩论出现了——既然AI在生成代码方面表现出色，还有必要学习编码吗？对于许多不会编码的人来说，毫无疑问，而且行业内声称AI能够产生高质量的代码就足够了。到2023年底，在行业内，一些工作岗位从人类转移到了AI，但总的来说，管理者们对于用AI替换程序员持谨慎态度。目前仍然存在幻觉的问题，但更重要的是，很快就显现出，只有在你能够写出正确的提示，或者换句话说，正确地指定时，你才能得到好的代码。再者，由于提示往往不是一次性的，而是需要某种形式的对话交互，因此理解这种“对话语言”是非常有用的。这种技能通常来自于长期的编程实践。</p>
         <p class="indent">目前看来，尽管人类可能不再是未来编写代码的主力军，但仍需要了解编程的人员与AI互动，以确保代码的有效运行。</p>
         <h3 style="text-align: left">代码、无代码、低代码</h3>
         <p class="no-indent">另一方面，如果需要高质量的编码人员与人工智能一起在复杂系统上工作，是否每个人都应该达到那个水平？答案可能不是。正如通常情况，事情并不总是非黑即白，可能存在一个介于不会编码和会编码之间的中间水平，通常被称为低代码。</p>
    </section>
    <section data-type="chapter" class="chapter" id="chapter-machine-learning-ai-through-data-experiments-in-orange" title="通过Orange项目中的数据实验学习机器学习与人工智能">
         <header>
              <h1 class="chapter-title">通过Orange项目中的数据实验学习机器学习与人工智能</h1>
              <p data-type="subtitle" class="chapter-number"></p>
         </header>
         <h2 class="chapter-author">Blaž Zupan</h2>
         <p class="indent" style="text-align: left"><em>海豚是哺乳动物吗？如果是，为什么？</em></p>
         <p class="indent" style="text-align: left"><em>几维鸟是什么物种的动物？</em></p>
         <p class="indent" style="text-align: left"><em>雅典和罗马是否位于同一气候带？</em></p>
         <p class="indent" style="text-align: left"><em>谁画了一幅著名的“尖叫女人”的画？这位艺术家是否总是用橙色画天空？</em></p>
         <p class="indent" style="text-align: left"><em>我们能否仅通过写作风格猜出社交媒体上帖子的作者是谁？</em></p>
         <p class="indent" style="text-align: left"><em>NBA中有没有与在卢卡·东契奇(Luka Dončič)的打球风格一模一样的克隆人？</em></p>
         <p class="indent" style="text-align: left"><em>能否仅通过树叶或者树皮的照片，判断出这棵树是什么种类呢？</em></p>
         <p class="indent" style="text-align: left"><em>世界各国是如何根据社会经济特征来分组的？世界真的是按照经济分为南北两部分吗？</em></p>
         <p class="indent" style="text-align: left"><em>罗马和雅典是否位于同一气候带？根据气候模式，哪个国家首都的气候与柏林最为相似？</em></p>
         <p class="no-indent">数据科学，特别是机器学习方法，正成为科学、工程和技术等多个领域变革的催化剂，对我们的日常生活产生了深远的影响。能够处理大量数据集、识别有趣模式并构建预测模型的计算技术正变得无处不在。然而，只有少数专业人士对数据科学有基本了解，而真正利用数据构建模型的人更是少之又少。在这个AI悄然塑造我们世界的时代，每个人都必须了解其能力、优势以及潜在风险。我们需要建立有效的方法，将数据科学的概念传授给广大受众，使机器学习、数据科学和人工智能的原理和技术成为常识。</p>
         <p class="indent">本章开头提出的每个问题，都可以通过观察相关数据来回答。我们提出以下机器学习训练方法：从问题出发，找到相关数据，然后通过分析数据模式和模型来回答问题。在<strong><a href="https://pumice.si/en/" target="_blank" rel="noopener">Pumice</a></strong>项目中，我们正在开发可以用来丰富不同学科的教育活动。我们利用与主题相关的数据，并借助AI和机器学习方法进行探索。我们与教育工作者携手合作，为教师和学生精心设计了学习模板和背景解释，以便他们更好地理解相关概念。</p>
         <p class="indent">Pumice的活动和培训得到了<a href="http://orangedatamining.com" target="_blank" rel="noopener">Orange</a>的支持，这是一个具有直观界面、交互式可视化和视觉编程的机器学习程序。其简化的关键在于采用类似乐高积木的分析流程构建方式和所有组件的交互性（见图1）。这既符合培训要求，又具备足够的灵活性，能够涵盖大多数核心主题并适应不同的应用领域。为了进一步支持教学，并专注于概念而非底层机制，Orange提供了对数据的便捷访问、通过保存工作流程及其各种用户设置和选择来实现的可重复性，以及通过设计新组件实现的轻松定制。培训的一个核心环节是通过工作流检查来进行故事叙述，并利用专门的实验功能，比如绘制实验数据集或学习多项式线性回归的过拟合问题。Orange作为开源软件可供使用，并配有<a href="https://www.youtube.com/orangedatamining" target="_blank" rel="noopener">简明培训视频</a>作为补充。</p>
         <p><img class="aligncenter size-medium wp-image-192" src="http://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot-300x289.png" alt="" width="300" height="289" srcset="https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot-300x289.png 300w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot-65x63.png 65w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot-225x217.png 225w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot-350x337.png 350w, https://aiopentext.itd.cnr.it/chinesegpt/wp-content/uploads/sites/24/2024/03/orange-screenshot.png 742w" sizes="(max-width: 300px) 100vw, 300px" /></p>
         <p style="text-align: center">图 1. Orange数据挖掘软件和一个典型的数据探索工作流。</p>
         <p class="no-indent">在图1中，我们展示了一个典型的Orange数据探索工作流程。这个流程包括了加载数据、计算距离、可视化数据或结果模型等多个环节，旨在帮助我们找到并可视化数据中的模式。在这个工作流中，我们使用了来自世界各国的社会经济数据。工作流的上部分支研究了两个特征，并显示了预期寿命和在校年数是相关的。但研究也发现像佛得角和摩洛哥这样的国家，虽然人们的寿命较长，但上学的时间却并不长。学校里的孩子们可以通过设计这样的数据网络来探索哪些国家在社会经济层面上较为相似。他们会发现，从社会经济角度来看，世界可以被划分为北部、中部和南部，而且发达和欠发达地区之间存在着巨大的差异。这些发现并不需要我们明确告诉他们，因为在Orange中挖掘数据的过程中，他们会自行发现这些规律，并在高年级的学习中深入探索这些差异。</p>
         <p class="no-indent">Orange这款软件自2003年诞生以来，发展势头强劲。如今，它已吸引了超过50,000名月度用户，作为一个被广泛接受的专业软件应用的地位，大约一半的用户来自学术界。值得注意的是，Orange在教育领域也备受追捧，全球已有超过500所大学将其纳入数据科学课程。</p>
         <p class="no-indent">如果你是一位致力于教授机器学习和数据科学的教育工作者，那么以下资源或许能为你提供不小的帮助。这些资源通过Orange进行实战数据探索，让你轻松入门这两个学科：</p>
         <ul>
              <li style="font-weight: 400">Orange，工具箱<a href="http://orangedatamining.com" target="_blank" rel="noopener">网站</a></li>
              <li style="font-weight: 400"><a href="http://youtube.com/orangedatamining" target="_blank" rel="noopener">数据科学简介</a>，是一套短视频，展示了使用Orange的选定可视化和机器学习方法。在<a href="http://youtube.com/orangedatamining" target="_blank" rel="noopener">http://youtube.com/orangedatamining</a>上找到视频，并转到“数据科学简介”播放列表。</li>
              <li style="font-weight: 400"><a href="https://pumice.si/en/" target="_blank" rel="noopener">Pumice</a>是一个教师网站，我们在那里收集了教师可以纳入培训计划的使用案例。</li>
         </ul>
    </section>
</div>
<section data-type="appendix" class="back-matter appendix" id="back-matter-appendix" title="Appendix">
    <header>
         <h1 class="back-matter-title display-none">Appendix</h1>
         <p data-type="subtitle" class="back-matter-number display-none">1</p>
    </header>
    <p>This is where you can add appendices or other back matter.</p>
</section>
<section data-type="afterword" class="back-matter afterword" id="back-matter-as-a-very-provisional-conclusion" title="初步结论">
    <header>
         <h1 class="back-matter-title">初步结论</h1>
         <p data-type="subtitle" class="back-matter-number">2</p>
    </header>
    <p class="no-indent">在2024年1月审阅这本教科书时，我们深感其中所代表的挑战之复杂。如今，人工智能今天不仅是一个重大议题，它更是<strong>一个问题</strong>，一个大于任何其他问题的问题。它究竟会带我们走向何方？它又会让我们多少次惊讶于那些昨天还看似不可能，今天就已成为现实的事情？在这样一个日新月异的领域里，如何能够编写一本不犯错误的教材呢？</p>
    <p class="indent">在教育领域，我们很少遇到变化如此迅速的主题。设计教学大纲需要数月，培训教师更是耗时数年。有人甚至说，全面深入研究一个新主题需要一代人的时间。</p>
    <p class="indent">然而，AI4T项目及其学习资源的目标，就是要紧跟人工智能的发展步伐，培训出具备相关知识的教师！因此，在阅读这本教材时，您可能会发现一些小的错误，或者一些不再正确的陈述：技术进步不断带来新的机会，而2022年或2023年还被视为难以克服的风险，在2024年可能已经变得可以接受；相关的法律法规也可能有所变动。这些变化会让我们的努力付诸东流吗？</p>
    <p class="indent">我们希望不会。如果我们利用技术提供给我们的机会和这本教科书的<strong>开放</strong>性质，使其不断变化，那么就不是。也许，传统的先出第一版，再出第二版的方式，可能已经不再是最适合编辑书籍的方法了。当然，存在其他解决方案，让这样的作品可以作为一个<strong>公共资源</strong>被共享，不仅在使用上，也包括其演变过程。这可能就是我们接下来要面临的挑战。</p>
    <p class="no-indent">这本教材现在已经交付到了教师和读者的手中。它的完成离不开众多人的付出。他们帮助我们深入了解教师和各部委的需求。有人负责准备材料、校对和搭建在线平台，有人协助翻译工作。我们还与外部团队紧密合作：Dagobafilms在视频制作方面给予了我们大力支持。最重要的是，还有那些一直鼓励我们的人。编写一本书是一项漫长而复杂的任务，我们需要家人、朋友和同事的支持来应对各种挫折，坚持正确的编辑选择，确保我们能够朝着设定的目标前进。</p>
    <p class="indent">在感谢过去三年里给予我们帮助的人时，我们可能会遗漏一些。我们对此深感抱歉，并希望他们能够原谅我们的疏忽。在此，我们要特别感谢那些以各种方式为此工作做出贡献的人们，他们的名字如下：</p>
    <div class="twocolumn">
         <p>Alain Thillay</p>
         <p>Andréane Roques</p>
         <p>Anne Boyer</p>
         <p>Anthony Kilcoye</p>
         <p>Axel Jean</p>
         <p>Azim Roussanaly</p>
         <p>Bastien Masse</p>
         <p>Blaž Zupan</p>
         <p>Borut Čampelj</p>
         <p>Catherine Lemonnier</p>
         <p>Catherine McD.</p>
         <p>Daniela Hau</p>
         <p>Dario La Guardia</p>
         <p>Deirdre Butler</p>
         <p>Dejan Zemljak</p>
         <p>Fabrizio Falchi</p>
         <p>Giuseppe Città</p>
         <p>Helena Fošnjar</p>
         <p>Iva Stegne</p>
         <p>Jean-Jacques Baton</p>
         <p>Jiajun Pan</p>
         <p>John Hurley</p>
         <p>Lucie Grasset</p>
         <p>Manuel Gentile</p>
         <p>Mélanie Pauly-Harquevaux</p>
         <p>Michael Hallissy</p>
         <p>Salvatore Perna</p>
         <p>Sašo Stanojev</p>
         <p>Solenn Gillouard</p>
         <p>Petra Bevek</p>
         <p>Urška Martinc</p>
         <p>Wayne Holmes</p>
    </div>
    <p class="no-indent">Jotsna想要感谢Thomas和Laya的理解、支持和（几乎）持续的爱。</p>
    <p class="no-indent">Colin感激Isabelle过去几个月的耐心。</p>
</section>
</body>
</html>